
TL;DR, Respuesta rápida
7 min de lecturaEl triage de bugs es el proceso recurrente en el que un grupo pequeño revisa los bugs recién reportados, clasifica cada uno por gravedad y prioridad, y asigna un responsable o una fecha límite. Funciona por separado del grooming del backlog, que reordena trabajo ya triado en lugar de decidir qué cuenta como bug en primer lugar. Un turno rotativo cambia quién asiste a cada sesión para que el triage no dependa de que una sola persona esté disponible.
¿Qué es el triage de bugs?
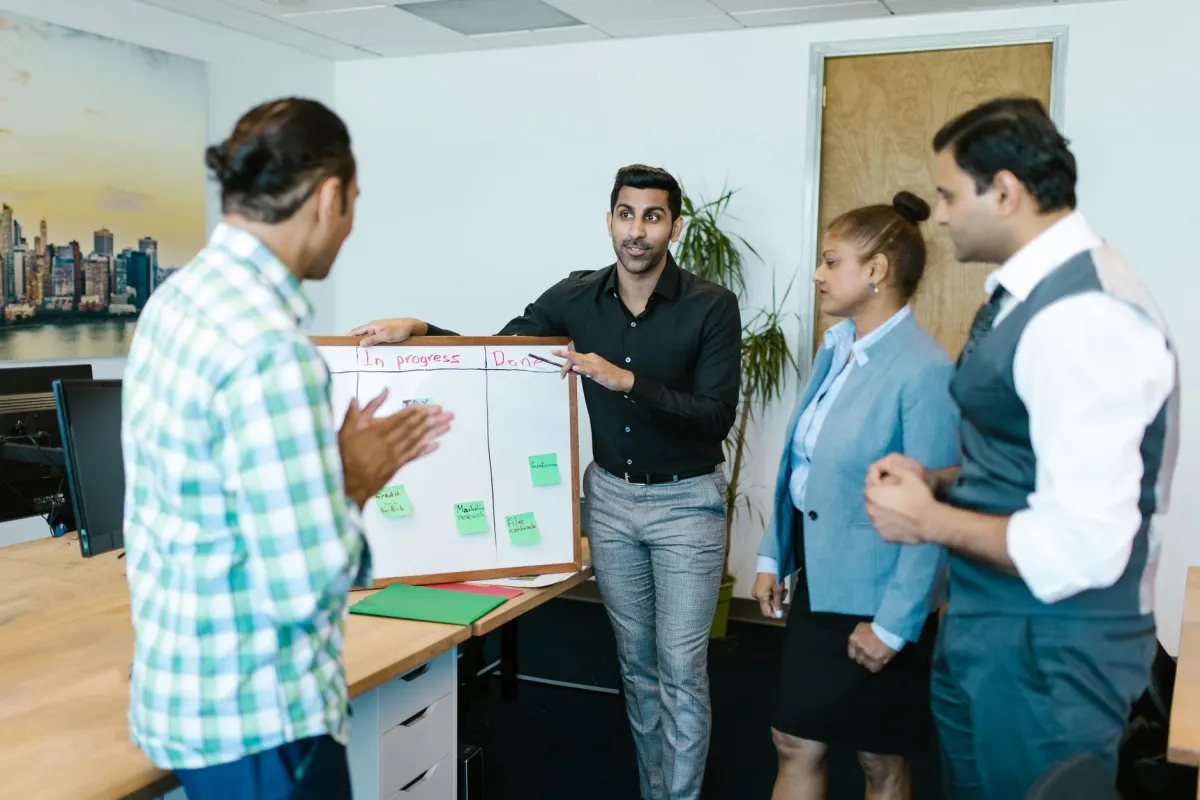
Un proceso de revisión recurrente llamado triage de bugs examina cada bug recién reportado, decide qué tan grave y qué tan urgente es cada uno, y le asigna un responsable o una fecha límite antes de que el bug entre en la cola regular de desarrollo. Un reporte que no ha pasado por el triage no tiene una gravedad acordada, ni un responsable confirmado, ni un lugar en el calendario, así que el triage es el paso que convierte un reporte entrante en trabajo procesable. La mayoría de los equipos ejecuta el triage en un ritmo fijo, como a diario o tres veces por semana, en lugar de revisar cada bug en el momento en que llega.
- Sin gravedad acordada
- Sin responsable confirmado
- Sin lugar en el calendario
- Una gravedad
- Una prioridad
- Un responsable o una posición en la cola
¿Quién asiste a una sesión de triage de bugs?
Una sesión de triage de bugs necesita a alguien que pueda juzgar la gravedad técnica, normalmente un ingeniero o tech lead, y a alguien que pueda juzgar el impacto de negocio, normalmente un product manager o un lead de soporte, además de quien esté en el turno de triage de ese periodo. Representantes de soporte o customer success suelen unirse para aportar contexto que un reporte de bug por sí solo no lleva, como cuántos clientes tuvieron el mismo problema o si está bloqueando una renovación. Mantener la lista de asistentes pequeña, normalmente entre tres y cinco personas, mantiene la reunión lo bastante rápida para repetirse varias veces por semana sin convertirse en una carga para el calendario.
¿Cómo se clasifican los reportes entrantes en el triage?
Los reportes entrantes se clasifican en dos ejes separados: gravedad, que mide qué tan roto está el producto, y prioridad, que mide qué tan pronto hay que resolverlo dado todo lo demás en la cola. Una distinción entre gravedad y prioridad importa porque un bug cosmético de baja gravedad que afecta a todos los clientes puede superar a un fallo de alta gravedad que solo un cliente ha sufrido alguna vez, según lo que el equipo decida resolver primero. El triage también verifica si un reporte incluye suficiente información para actuar, y un reporte al que le faltan los pasos para reproducir se devuelve pidiendo más detalle en lugar de asignarse a un ingeniero que no puede recrearlo.
¿En qué se diferencia el triage de bugs del grooming de bugs?
El triage de bugs decide qué es un bug recién reportado y qué tan urgente es; el grooming de bugs reordena bugs que ya pasaron por el triage y están en el backlog, refinando su alcance y reordenándolos frente a la capacidad del próximo sprint. El triage es reactivo, actúa sobre lo que haya entrado desde la última sesión, mientras que el grooming se programa en torno a la planificación, normalmente una vez por sprint, y trabaja desde el conjunto de bugs ya clasificados en lugar de los reportes entrantes sin procesar. Un bug pasa por el triage una vez, el día en que se reporta, y luego el grooming lo toca varias veces después conforme cambia su posición en el backlog.
¿Cómo es un turno de triage de bugs?
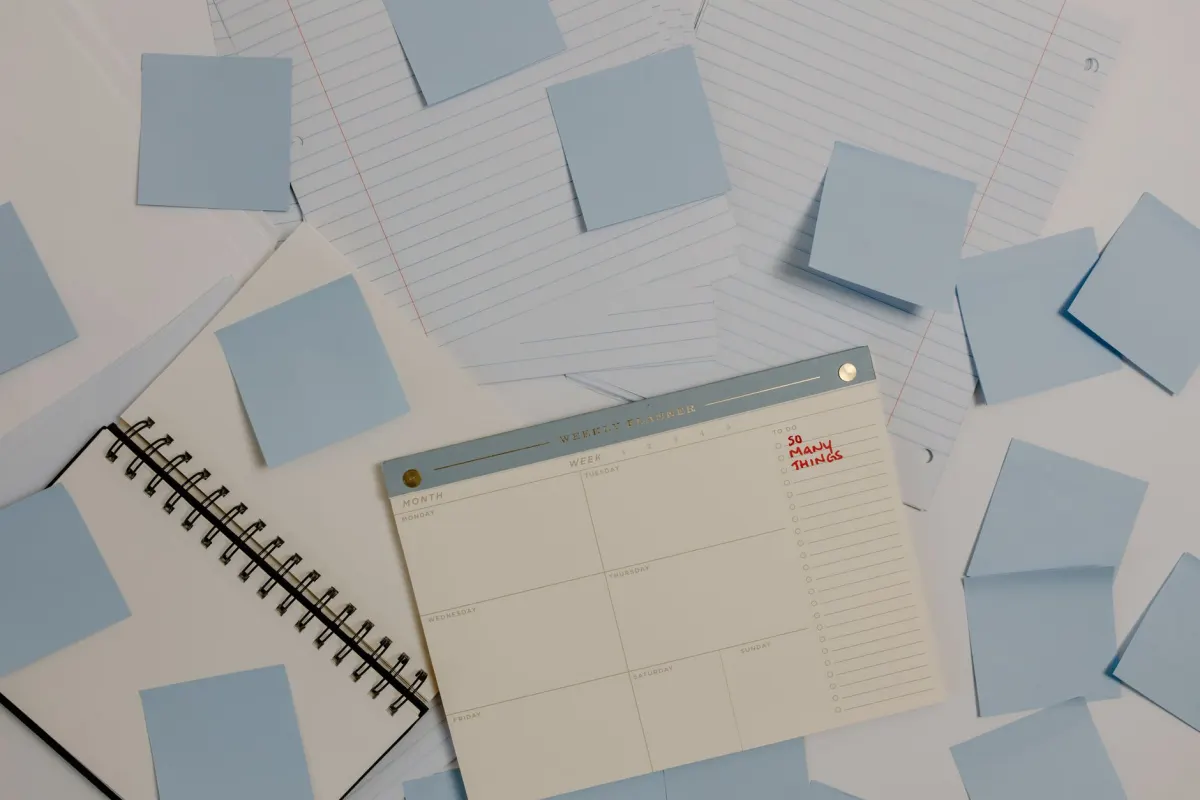
Un turno de triage de bugs asigna la responsabilidad de asistir y dirigir las sesiones de triage a un grupo rotativo de ingenieros, normalmente en base semanal, para que el proceso no dependa de que una persona concreta esté en cada sesión. Un turno típico nombra a un ingeniero como líder de triage de la semana, responsable de programar la sesión y de tomar la decisión final ante cualquier desacuerdo sobre la gravedad, más una contraparte rotativa de soporte o PM que aporta contexto de impacto para el cliente. Publicar el turno con antelación, junto con el ritmo del triage, permite al ingeniero asignado prepararse revisando la cola entrante antes de que empiece la sesión, en lugar de leer cada reporte en vivo durante la reunión.
¿Cómo conecta el triage un reporte con las herramientas que los ingenieros ya usan?
Un reporte de bug que llega sin una repetición de lo que realmente ocurrió obliga al grupo de triage a adivinar la gravedad a partir de una simple descripción en texto, lo que ralentiza cada sesión. Flowsery agrupa automáticamente las sesiones coincidentes en un solo issue clasificado, y cada issue llega a Slack, Linear o Jira con la repetición y los pasos para reproducir ya adjuntos, de modo que una sesión de triage empieza desde un reporte reproducible en lugar de una queja sin procesar. Clasificar los issues según a cuántos usuarios afectan también le da al grupo de triage una señal inicial de gravedad antes incluso de que empiece la reunión, ya que un bug que afecta a muchas sesiones sube solo a la parte superior de la cola de issues.
Preguntas frecuentes
¿Con qué frecuencia debería un equipo ejecutar el triage de bugs?
La mayoría de los equipos ejecuta el triage de bugs dos o tres veces por semana, o a diario en productos con un alto volumen de reportes entrantes, ya que un intervalo más largo entre sesiones deja que los reportes se acumulen sin una gravedad o un responsable asignado. El ritmo correcto es el que mantiene el backlog de reportes sin triar cerca de cero entre sesiones.
¿Cuál es la diferencia entre el triage de bugs y el grooming de bugs?
El triage de bugs clasifica y asigna los reportes completamente nuevos según llegan; el grooming de bugs reordena y refina bugs que ya pasaron por el triage, normalmente como parte de la planificación del sprint. El triage se ejecuta de forma reactiva sobre la cola entrante, mientras que el grooming se ejecuta en un ritmo de planificación programado.
¿Quién debería liderar una sesión de triage de bugs?
Un líder de triage rotativo, normalmente un ingeniero, funciona mejor que un único responsable fijo, ya que un turno reparte la responsabilidad y mantiene el proceso funcionando incluso cuando una persona no está disponible. El trabajo del líder es programar la sesión, mantenerla en marcha y tomar la decisión final cuando la gravedad se disputa.
¿Qué pasa si un reporte de bug no tiene pasos para reproducir?
Un reporte sin pasos para reproducir se devuelve a quien lo reportó o al equipo de soporte para pedir más detalle en lugar de asignarse a un ingeniero, ya que nadie puede confirmar la gravedad del bug sin poder recrearlo. Esto evita que el triage asigne trabajo no verificable a la cola de desarrollo.
¿Debería todo bug reportado pasar por el mismo proceso de triage?
Sí, hacer pasar cada reporte por los mismos pasos de clasificación, primero gravedad, luego prioridad, luego asignación, mantiene el backlog consistente y comparable a lo largo del tiempo. Saltarse el triage en reportes que a primera vista parecen menores es cómo los problemas de baja gravedad se acumulan en silencio sin llegar nunca a registrarse formalmente.
¿Cómo afecta la gravedad de un bug a la rapidez con la que se le hace triage, no solo a la rapidez con la que se resuelve?
Un reporte etiquetado como probable de alta gravedad, como uno que bloquea el checkout, normalmente se lleva al triage más rápido en lugar de esperar a la siguiente sesión programada, ya que confirmar la gravedad ante una posible caída no puede esperar a un ritmo rutinario. Los reportes de menor gravedad esperan a la sesión de triage regular sin alterar el calendario.
¿Cuántas personas deberían asistir a una sesión de triage de bugs?
Una sesión de triage de bugs funciona mejor con entre tres y cinco personas: un ingeniero o tech lead que evalúa la gravedad técnica, un product manager o responsable de soporte que evalúa el impacto de negocio, y quien esté de turno en el rota ese periodo. Mantener el grupo en ese tamaño mantiene las sesiones lo bastante ágiles como para repetirse varias veces por semana sin convertirse en una carga para el calendario.

Flowsery
Prueba gratuita
Panel en tiempo real
Seguimiento de objetivos
Rastreo sin cookies
¿Pueden participar representantes de soporte o customer success en una sesión de triage de bugs?
Los representantes de soporte o customer success suelen participar para aportar contexto que un reporte por sí solo no ofrece, como cuántos clientes han sufrido el mismo problema o si está bloqueando una renovación. Su presencia ayuda al grupo a juzgar el impacto de negocio en lugar de adivinarlo a partir del texto del reporte.
¿Quién tiene la última palabra cuando una sesión de triage no logra ponerse de acuerdo sobre la gravedad?
El responsable de triage rotativo de esa semana toma la decisión final ante cualquier desacuerdo sobre la gravedad. Esa misma persona también se encarga de programar la sesión, lo que mantiene el triage funcionando incluso cuando el grupo no coincide.
¿Cómo cambia la agrupación automática de issues lo que trabaja una sesión de triage de bugs?
La agrupación automática convierte una queja en bruto en un issue clasificado que ya trae un replay y los pasos para reproducir adjuntos, así que la sesión arranca desde algo reproducible en lugar de una simple descripción de texto. Clasificar los issues según cuántos usuarios los sufren también le da al grupo una primera señal de gravedad antes de que empiece la reunión.
¿Te resultó útil este artículo?
¡Cuéntanos qué opinas!
Vernos más en Google
Un clic marca Flowsery como fuente preferida y nuestros artículos aparecen más arriba en tus Noticias destacadas, el modo IA y los resúmenes con IA.
Antes de irte...
Flowsery
Analítica orientada a ingresos para tu sitio web
Rastrea cada visitante, fuente y conversión en tiempo real. Simple, potente y sin cookies.
Panel en tiempo real
Seguimiento de objetivos
Rastreo sin cookies
Términos relacionados del glosario
La plantilla de reporte de bugs que ningún revisor rechaza
Una plantilla de reporte de bugs nombra cada campo que un revisor espera, desde pasos para reproducir hasta gravedad, o el ticket incompleto se rechaza.
Por qué los pasos para reproducir deciden si un bug se arregla
Un buen reporte de bugs escribe los pasos para reproducir como acciones numeradas desde un punto de partida conocido, para que el equipo cause el mismo fallo.
Estas cifras muestran la tasa de rebote media por industria
Nueve industrias registradas muestran una tasa de rebote media por industria documentada, entre 35.76% y 48.38%, según datos de Databox de septiembre de 2024.
Cómo aplicar la fórmula del valor promedio del pedido paso a paso
La fórmula del valor promedio del pedido divide los ingresos entre pedidos, y un código de descuento puede distorsionar en silencio cada cifra reportada.
Cómo se comparan los sitios B2B y B2C en los benchmarks de duración media de sesión
Los datos propios de Databox sitúan los benchmarks de duración media de sesión en 77.61 segundos para B2B y 92.33 para B2C, por industria y dispositivo.
Lo que realmente mide la duración media de sesión
En analítica clásica, la duración media de sesión da cero tiempo a la última página vista de cada sesión, arrastrando el promedio hacia abajo en silencio.
Artículos relacionados
Por qué beforeunload vs pagehide decide si tus analíticas sobreviven
Comparar beforeunload vs pagehide muestra por qué el móvil se salta beforeunload, bloquea el bfcache y pagehide envía datos de forma fiable con sendBeacon.
Qué registra la analítica de comportamiento que las páginas vistas no ven
A diferencia de un conteo de páginas vistas, la analítica de comportamiento registra lo que un visitante hace en una página, como eventos vinculados a él.
Cómo la huella digital del navegador te identifica sin una cookie
Canvas, fuentes instaladas, tamaño de pantalla y zona horaria, combinados por la huella digital del navegador en un identificador que sobrevive al borrado.