
TL;DR, Kurzantwort
6 Min. LesezeitBug-Triage ist der wiederkehrende Prozess, bei dem eine kleine Gruppe neu gemeldete Bugs prüft, jeden nach Schweregrad und Priorität klassifiziert und einen Verantwortlichen oder eine Frist zuweist. Er läuft getrennt vom Backlog-Grooming ab, das bereits triagierte Arbeit neu ordnet, statt zu entscheiden, was überhaupt als Bug zählt. Ein Rotationsplan wechselt, wer an jeder Sitzung teilnimmt, damit die Triage nicht von der Verfügbarkeit einer einzelnen Person abhängt.
Was ist Bug-Triage?
Ein wiederkehrender Überprüfungsprozess namens Bug-Triage untersucht jeden neu gemeldeten Bug, entscheidet, wie schwerwiegend und wie dringend er ist, und weist ihm einen Verantwortlichen oder eine Frist zu, bevor der Bug in die reguläre Entwicklungs-Warteschlange gelangt. Ein Report, der die Triage noch nicht durchlaufen hat, hat keinen vereinbarten Schweregrad, keinen bestätigten Verantwortlichen und keinen Platz im Zeitplan, daher ist die Triage der Schritt, der aus einem eingehenden Report umsetzbare Arbeit macht. Die meisten Teams führen die Triage in einem festen Rhythmus durch, etwa täglich oder dreimal pro Woche, statt jeden Bug sofort bei seinem Eintreffen zu prüfen.
- Kein vereinbarter Schweregrad
- Kein bestätigter Verantwortlicher
- Kein Platz im Zeitplan
- Ein Schweregrad
- Eine Priorität
- Ein Verantwortlicher oder eine Position in der Warteschlange
Wer nimmt an einer Bug-Triage-Sitzung teil?
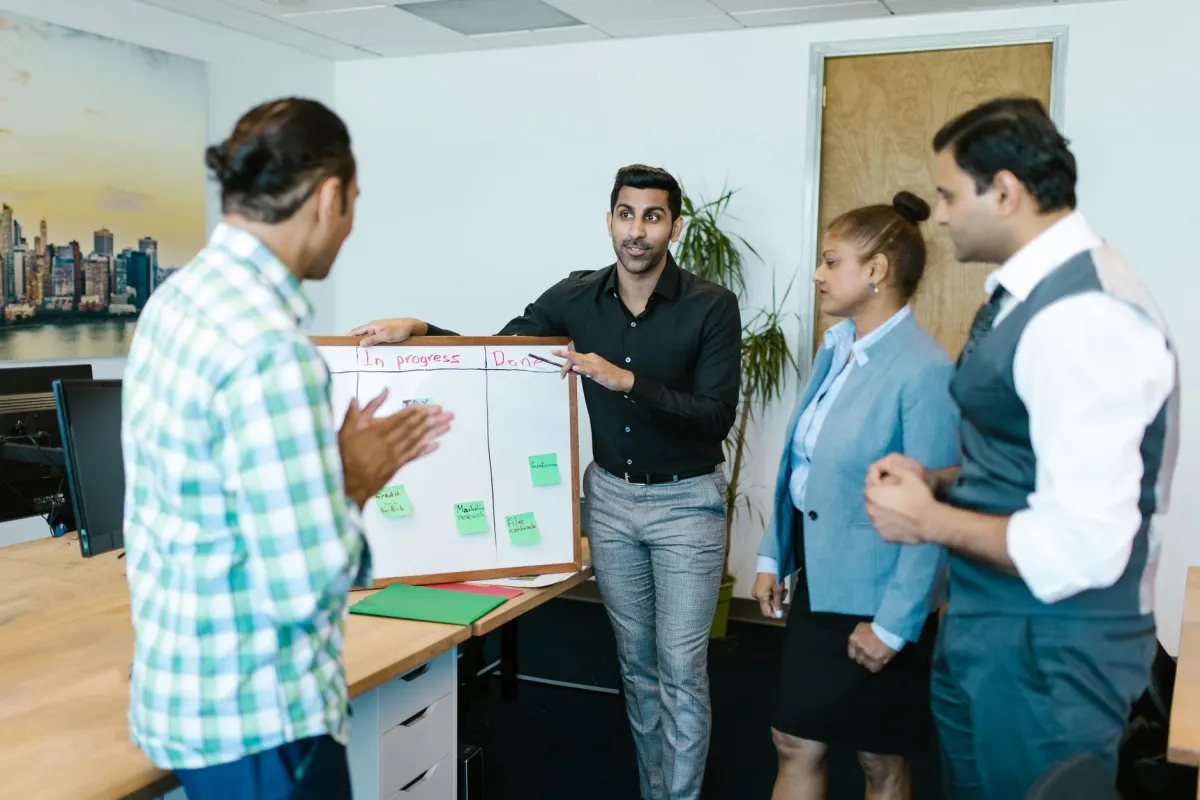
Eine Bug-Triage-Sitzung braucht jemanden, der den technischen Schweregrad beurteilen kann, meist ein Entwickler oder Tech Lead, und jemanden, der die geschäftliche Auswirkung beurteilen kann, meist ein Product Manager oder Support Lead, dazu wer auch immer gerade auf dem Triage-Rotationsplan steht. Support- oder Customer-Success-Mitarbeiter stoßen oft dazu, um Kontext beizutragen, den ein Bug-Report allein nicht liefert, etwa wie viele Kunden vom selben Problem betroffen sind oder ob es eine Vertragsverlängerung blockiert. Eine kleine Teilnehmerliste, typischerweise drei bis fünf Personen, hält die Besprechung schnell genug, um mehrmals pro Woche stattzufinden, ohne selbst zur Belastung für den Zeitplan zu werden.
Wie werden eingehende Reports in der Triage klassifiziert?
Eingehende Reports werden entlang zweier getrennter Achsen klassifiziert: Schweregrad, der misst, wie kaputt das Produkt ist, und Priorität, die misst, wie bald es angesichts von allem anderen in der Warteschlange behoben werden muss. Eine Unterscheidung zwischen Schweregrad und Priorität ist wichtig, weil ein kosmetischer Bug mit niedrigem Schweregrad, der jeden Kunden betrifft, einen Absturz mit hohem Schweregrad überholen kann, den bislang nur ein einziger Kunde je erlebt hat, je nachdem, was das Team zuerst beheben will. Die Triage prüft außerdem, ob ein Report genug Informationen enthält, um darauf zu reagieren, und ein Report ohne Schritte zur Reproduktion wird für weitere Details zurückgeschickt, statt einem Entwickler zugewiesen zu werden, der ihn nicht nachstellen kann.
Wie unterscheidet sich Bug-Triage von Bug-Grooming?
Bug-Triage entscheidet, was ein neu gemeldeter Bug ist und wie dringend er ist; Bug-Grooming ordnet Bugs neu, die bereits die Triage durchlaufen haben und im Backlog liegen, verfeinert deren Umfang und ordnet sie im Verhältnis zur kommenden Sprint-Kapazität neu ein. Die Triage ist reaktiv und arbeitet mit allem, was seit der letzten Sitzung neu eingegangen ist, während das Grooming rund um die Planung angesetzt wird, typischerweise einmal pro Sprint, und mit dem Pool bereits klassifizierter Bugs arbeitet statt mit rohen eingehenden Reports. Ein Bug durchläuft die Triage einmal, an dem Tag, an dem er gemeldet wird, und wird danach mehrfach vom Grooming berührt, während sich seine Position im Backlog verschiebt.
Wie sieht ein Bug-Triage-Rotationsplan aus?
Ein Bug-Triage-Rotationsplan weist die Verantwortung für die Teilnahme an und Leitung von Triage-Sitzungen einer rotierenden Gruppe von Entwicklern zu, meist auf wöchentlicher Basis, damit der Prozess nicht von einer bestimmten Person abhängt, die bei jeder Sitzung dabei sein muss. Ein typischer Rotationsplan benennt einen Entwickler als Triage-Lead der Woche, verantwortlich für die Terminierung der Sitzung und die endgültige Entscheidung bei jeder Uneinigkeit über den Schweregrad, dazu ein rotierendes Support- oder PM-Gegenstück, das Kontext zur Kundenauswirkung liefert. Wird der Rotationsplan im Voraus veröffentlicht, zusammen mit dem Triage-Rhythmus, kann sich der zuständige Entwickler vorbereiten, indem er die eingehende Warteschlange vor Sitzungsbeginn überfliegt, statt jeden Report live in der Besprechung zu lesen.
Wie verbindet die Triage einen Report mit den Tools, die Entwickler bereits nutzen?
Ein Bug-Report, der ohne Replay dessen ankommt, was tatsächlich passiert ist, zwingt die Triage-Gruppe, den Schweregrad allein aus einer Textbeschreibung zu erraten, was jede Sitzung verlangsamt. Flowsery gruppiert passende Sessions automatisch zu einem einzigen bewerteten Issue, und jedes Issue landet in Slack, Linear oder Jira mit bereits angehängtem Replay und Schritten zur Reproduktion, sodass eine Triage-Sitzung mit einem reproduzierbaren Report beginnt statt mit einer rohen Beschwerde. Issues nach der Anzahl betroffener Nutzer zu ranken, gibt der Triage-Gruppe außerdem schon vor Sitzungsbeginn ein erstes Schweregrad-Signal, da ein Bug, der viele Sessions betrifft, von selbst ganz oben in der Issues-Warteschlange auftaucht. Teams, die in Asana, Trello oder ClickUp triagieren, bekommen dieselbe Übergabe über die Zapier-Analytics-App von Flowsery, die bei jedem neuen Issue einen Zap startet.
Häufig gestellte Fragen
Wie oft sollte ein Team Bug-Triage durchführen?
Die meisten Teams führen Bug-Triage zwei- bis dreimal pro Woche durch, oder täglich bei Produkten mit hohem Volumen eingehender Reports, da eine längere Lücke zwischen den Sitzungen Reports ohne zugewiesenen Schweregrad oder Verantwortlichen anhäufen lässt. Der richtige Rhythmus ist der, der den Rückstand nicht triagierter Reports zwischen den Sitzungen nahe null hält.
Was ist der Unterschied zwischen Bug-Triage und Bug-Grooming?
Bug-Triage klassifiziert und weist brandneue Reports zu, sobald sie eintreffen; Bug-Grooming ordnet Bugs neu und verfeinert sie, die bereits die Triage durchlaufen haben, meist im Rahmen der Sprint-Planung. Die Triage läuft reaktiv gegen die eingehende Warteschlange, während das Grooming nach einem geplanten Planungsrhythmus abläuft.
Wer sollte eine Bug-Triage-Sitzung leiten?
Ein rotierender Triage-Lead, meist ein Entwickler, funktioniert besser als ein einzelner fester Verantwortlicher, da ein Rotationsplan die Verantwortung verteilt und den Prozess auch dann am Laufen hält, wenn eine Person nicht verfügbar ist. Die Aufgabe des Leads ist es, die Sitzung zu terminieren, sie voranzubringen und die endgültige Entscheidung zu treffen, wenn der Schweregrad umstritten ist.
Was passiert, wenn ein Bug-Report keine Schritte zur Reproduktion hat?
Ein Report ohne Schritte zur Reproduktion wird an den Melder oder das Support-Team für weitere Details zurückgeschickt, statt einem Entwickler zugewiesen zu werden, da niemand den Schweregrad des Bugs bestätigen kann, ohne ihn nachstellen zu können. So wird verhindert, dass die Triage nicht verifizierbare Arbeit in die Entwicklungs-Warteschlange gibt.
Sollte jeder gemeldete Bug denselben Triage-Prozess durchlaufen?
Ja, jeden Report durch dieselben Klassifizierungsschritte laufen zu lassen, zuerst Schweregrad, dann Priorität, dann Zuweisung, hält den Backlog konsistent und über die Zeit vergleichbar. Die Triage bei Reports auszulassen, die auf den ersten Blick geringfügig wirken, ist die Art, wie sich Probleme mit niedrigem Schweregrad still anhäufen, ohne je formal erfasst zu werden.
Wie beeinflusst der Schweregrad eines Bugs, wie schnell er in die Triage kommt, nicht nur wie schnell er behoben wird?
Ein Report, der als wahrscheinlich hoher Schweregrad markiert ist, etwa einer, der den Checkout blockiert, wird typischerweise schneller in die Triage gezogen, statt auf die nächste geplante Sitzung zu warten, da die Bestätigung des Schweregrads bei einem möglichen Ausfall nicht auf einen Routine-Rhythmus warten kann. Reports mit niedrigerem Schweregrad warten auf die reguläre Triage-Sitzung, ohne den Zeitplan zu stören.
Wie viele Personen sollten an einer Bug-Triage-Sitzung teilnehmen?
Eine Bug-Triage-Sitzung funktioniert am besten mit drei bis fünf Personen: einem Ingenieur oder Tech Lead, der den technischen Schweregrad beurteilt, einem Product Manager oder Support Lead, der die geschäftliche Auswirkung beurteilt, sowie wer auch immer gerade im Rotationsplan an der Reihe ist. Diese Gruppengröße hält die Sitzungen schnell genug, um mehrmals pro Woche stattzufinden, ohne selbst zur Belastung für den Zeitplan zu werden.
Flowsery
Jetzt 14 Tage kostenlos testen
Echtzeit-Dashboard
Zielverfolgung
Cookie-freies Tracking
Können Support- oder Customer-Success-Mitarbeiter an einer Bug-Triage-Sitzung teilnehmen?
Support- oder Customer-Success-Mitarbeiter nehmen oft teil, um Kontext beizusteuern, den ein Bug-Report allein nicht liefert, etwa wie viele Kunden vom selben Problem betroffen sind oder ob eine Vertragsverlängerung dadurch blockiert wird. Ihre Anwesenheit hilft der Gruppe, die geschäftliche Auswirkung einzuschätzen, statt sie aus dem Reporttext zu erraten.
Wer entscheidet, wenn sich eine Triage-Sitzung nicht auf einen Schweregrad einigen kann?
Der rotierende Triage-Lead der jeweiligen Woche trifft die endgültige Entscheidung bei Uneinigkeit über den Schweregrad. Diese Person ist außerdem für die Terminierung der Sitzung verantwortlich, was die Triage auch bei Uneinigkeit am Laufen hält.
Wie verändert die automatische Gruppierung von Issues, womit eine Bug-Triage-Sitzung arbeitet?
Die automatische Gruppierung verwandelt eine rohe Beschwerde in ein bewertetes Issue, das bereits einen Replay und Schritte zur Reproduktion enthält, sodass die Sitzung mit etwas Nachvollziehbarem statt nur einer Textbeschreibung startet. Die Bewertung von Issues danach, wie viele Nutzer betroffen sind, gibt der Gruppe zudem ein erstes Signal für den Schweregrad, noch bevor die Sitzung beginnt.
War dieser Artikel hilfreich?
Teilen Sie uns Ihre Meinung mit!
Sehen Sie uns öfter bei Google
Ein Klick macht Flowsery zu einer bevorzugten Quelle. Unsere Artikel stehen dann weiter oben in Ihren Top-Meldungen, im KI-Modus und in den KI-Übersichten.
Bevor Sie gehen...
Flowsery
Umsatzorientierte Analysen für Ihre Website
Verfolgen Sie jeden Besucher, jede Quelle und jede Conversion in Echtzeit. Einfach, leistungsstark und komplett ohne Cookies.
Echtzeit-Dashboard
Zielverfolgung
Cookie-freies Tracking
Verwandte Glossarbegriffe
Die Bugreport-Vorlage, die kein Reviewer ablehnt
Eine Bugreport-Vorlage nennt jedes Feld, das ein Reviewer erwartet, von Schritten zur Reproduktion bis zum Schweregrad, sonst wird das Ticket abgelehnt.
Warum Schritte zur Reproduktion entscheiden, ob ein Bug behoben wird
Ein guter Bugreport beschreibt Schritte zur Reproduktion als nummerierte Aktionen ab einem Startpunkt, damit jeder im Team denselben Fehler auslösen kann.
Was eine Scroll Map darüber zeigt, wo Leser aufhören
Jedes Band einer Scroll Map ist nach dem Anteil der Besucher gefärbt, die es erreicht haben. Fold-Linie, Drop-off-Spalte und wo die Seitenhöhe täuscht.
Was ein Conversion-Pfad zeigt, bevor jemand kauft
Jeder Conversion-Pfad ist die geordnete Liste der Kanäle vor einer Conversion. Wie GA4 ihn in frühe, mittlere und späte Touches teilt und was zu beheben ist.
Was benutzerdefinierte Dimensionen in GA4 leisten und welche Kontingente sie begrenzen
Erst benutzerdefinierte Dimensionen in GA4 machen Event-Parameter zu Report-Feldern. Die drei Scopes, die Kontingente 50, 25 und 10 und die Kardinalitätsfalle.
Wie die User-ID in GA4 angemeldete Besuche geräteübergreifend verbindet
Eine User-ID in GA4 verbindet die Sessions einer angemeldeten Person über Geräte hinweg. gtag-Setup, die 256-Zeichen-Regel, Abmeldung und Grenzen.
Verwandte Artikel
Worauf GA4 die durchschnittliche Engagement-Zeit wirklich bezieht
GA4 berechnet die durchschnittliche Engagement-Zeit als Fokuszeit pro aktivem Nutzer, nicht pro Sitzung. Wie der Timer läuft und was die Zahl übersieht.
Was Klick-Tracking auf Websites erfasst und welche Klicks verloren gehen
Klick-Tracking erfasst, welches Element ein Besucher auf welcher Seite wann angeklickt hat. Die drei Methoden, die Felder und warum Klicks verschwinden.
Wie ein Data Layer Ihre Analytics-Tags mit Events versorgt
Ein Data Layer ist die Warteschlange, in die eine Seite Events schiebt. Wie Tag Manager dataLayer liest, warum Pushes verschmelzen, was Events verliert.