
TL;DR, Réponse rapide
21 min de lectureServer side tracking sends selected events from infrastructure you control, such as your backend, payment webhooks, API routes, or a first-party proxy. It improves reliability for verified business events, but it does not make analytics automatically private, consent-free, or identical across tools.
Si vos analyses de navigateur semblent incomplètes, ce guide sur le suivi côté serveur explique ce qui change lorsque les événements passent du navigateur du visiteur à une infrastructure que vous contrôlez, ce qui pose encore problème, et quelles plateformes d'analyse prennent en charge cette approche aujourd'hui.
Les recherches pour cet article ont été vérifiées le 12 mai 2026 à partir des pages produit officielles, des pages tarifaires, de la documentation, des directives des régulateurs et des références API actuelles des fournisseurs. Flowsery est cité en premier car il s'agit de notre plateforme, et chaque plateforme mentionnée ci-dessous inclut une image de tableau de bord provenant du CDN d'AdaptlyPost.
Point clé à retenir : le suivi côté serveur convient le mieux aux événements que votre serveur peut vérifier, comme les inscriptions, les paiements, les changements d'abonnement, les téléchargements authentifiés, les soumissions de leads, l'utilisation de l'API et les confirmations de webhook. Il est plus faible pour les événements que seul le navigateur peut observer, comme la profondeur de défilement, le temps de visibilité, le comportement au survol, les débuts de formulaire, les changements de route côté client et les erreurs visuelles.
Ce que signifie vraiment le suivi côté serveur
Le suivi côté serveur signifie qu'un événement est collecté, transformé, filtré, enrichi ou transmis par votre serveur au lieu d'être envoyé uniquement par le JavaScript qui s'exécute dans le navigateur du visiteur.
Cela peut se produire de plusieurs façons :
| Modèle | Ce qui envoie l'événement | Idéal pour | Risque principal |
|---|---|---|---|
| API d'événements backend | Votre serveur d'application appelle une API d'analyse | Achats, inscriptions, événements de compte, changements de statut de lead | Contexte navigateur manquant, comme le référent, l'UTM, l'appareil et la session |
| Webhook de paiement ou de CRM | Stripe, Paddle, Shopify, un CRM ou un autre système notifie votre backend | Attribution des revenus et événements de cycle de vie | Faire correspondre le webhook au visiteur ou à la campagne d'origine |
| Proxy propriétaire | Le navigateur envoie à votre propre point de terminaison, puis votre serveur transmet | Meilleur contrôle, filtrage, nettoyage des payloads, résistance aux bloqueurs de publicité | Commence encore dans le navigateur, donc les règles de consentement et d'accès à l'appareil peuvent encore s'appliquer |
| Conteneur de balises côté serveur | Un conteneur serveur reçoit les événements et les transmet aux destinations | Routage multi-destination, transformations, déduplication | Plus d'infrastructure, de coûts et de gouvernance |
| Analyse de journaux ou en périphérie | Le serveur web, le CDN ou le proxy inverse enregistre les requêtes | Opérations, robots, erreurs, téléchargements, comportement du cache | Les journaux sont bruyants et n'équivalent pas à des sessions humaines |
La distinction importante est celle de la source de vérité. Un achat confirmé par votre backend de paiement est un fait de conversion plus solide qu'un pixel sur une page de remerciement. Un clic sur un onglet tarifaire est généralement un fait de navigateur. Une erreur 500 est un fait d'infrastructure. Le suivi côté serveur fonctionne mieux lorsque chaque métrique est attribuée au système qui sait réellement qu'elle s'est produite.
Chaque ligne de ce tableau est d'abord une configuration logiciel à logiciel avant d'être une décision d'analyse. Si la transmission entre les deux systèmes est mal réalisée, même un plan de mesure soigné finit par afficher un chiffre faux avec assurance.
Pourquoi les équipes migrent le tracking côté serveur
Les équipes se tournent vers le tracking côté serveur après l'apparition de l'un de ces cinq problèmes.
Premièrement, les scripts côté navigateur peuvent être bloqués par des extensions de confidentialité, des filtres DNS, des règles réseau, des politiques de sécurité de contenu ou des échecs de script. Les événements confirmés côté serveur sont moins exposés à ces modes de défaillance.
Deuxièmement, les événements de checkout et de lead sont souvent trop précieux pour dépendre du chargement d'une page. Un navigateur peut se fermer avant que la page de remerciement ne se charge, un prestataire de paiement peut rediriger différemment, ou un client peut finaliser son paiement dans un flux que le script du navigateur ne voit jamais.
Troisièmement, les événements backend peuvent inclure des informations qui ne devraient pas être exposées au navigateur, comme le statut de la commande, les montants des factures, les identifiants de plan, les marges, l'état de fraude ou le stade du cycle de vie. Le serveur peut n'envoyer que le sous-ensemble sûr pour l'analytics.
Quatrièmement, le traitement côté serveur offre un filtre central. Il permet d'écarter le trafic interne, de supprimer les query strings, de normaliser les noms d'événements, de bloquer les propriétés sensibles, de router uniquement les événements consentis et d'éviter les doublons entre conversions navigateur et serveur.
Cinquièmement, le tracking côté serveur peut améliorer l'attribution lorsqu'il préserve le contexte de campagne first-party et le relie ensuite à des résultats vérifiés. Cela ne fait pas magiquement s'accorder toutes les plateformes entre elles, mais cela peut rendre l'événement métier lui-même plus fiable.

Flowsery
Essai gratuit
Tableau de bord en temps réel
Suivi des objectifs
Suivi sans cookies
Ce que cela ne résout pas
Le tracking côté serveur est survendu. Il ne rend pas automatiquement l'analytics conforme, exact ou imbloquable.
Il ne supprime pas les obligations en matière de confidentialité. Les lignes directrices de l'ICO britannique sur les cookies et technologies similaires indiquent que les règles peuvent s'appliquer aux cookies et aux technologies de stockage ou d'accès similaires, pas seulement aux fichiers nommés « cookies ». La Data Protection Commission irlandaise indique de même que le consentement est normalement requis pour les cookies ou technologies similaires, sauf exception applicable. Si une configuration côté serveur continue de stocker des identifiants sur l'appareil, de lire des identifiants, de faire du fingerprinting, d'envoyer des données personnelles vers des destinations publicitaires ou d'ignorer les choix de l'utilisateur, le fait de déplacer le traitement côté backend ne règle pas le problème juridique.
Il ne transforme pas les logs serveur en personnes. Un serveur voit des crawlers, des moniteurs de disponibilité, des bots de prévisualisation de liens, des crawlers d'IA, des tentatives répétées, des requêtes d'assets, du prefetch, des requêtes mises en cache et des attaques. Le nombre brut de requêtes ne correspond pas à des sessions humaines, à moins de les classer et de les filtrer avec soin.
Il ne préserve pas le contexte navigateur par défaut. Quand le navigateur n'envoie pas le referrer, les paramètres UTM, le user agent, la taille de viewport, la langue ou les identifiants de session à votre backend, un événement uniquement côté serveur peut être exact mais mal attribué.
Il ne fait pas en sorte que toutes les plateformes d'analytics interprètent les événements de la même façon. Chaque produit a son propre modèle d'identité, son modèle de session, son filtrage des bots, sa fenêtre d'attribution, ses règles de déduplication et son unité de tarification.
Tracking côté serveur vs tracking côté client
Utilisez le tracking côté client quand l'événement concerne l'expérience du visiteur dans le navigateur :
- Vues de page et changements de route côté client
- Contexte d'atterrissage de campagne
- Referrers et UTM capturés sur la page d'atterrissage
- Clics, débuts de formulaire, profondeur de scroll, liens sortants et téléchargements
- Contexte navigateur, appareil, viewport et langue
- Session replay et comportement d'interface
Utilisez le tracking côté serveur quand l'événement est un fait backend vérifié :
- Compte créé
- Lead accepté ou qualifié
- Checkout finalisé
- Abonnement renouvelé, upgradé, downgradé ou annulé
- Facture payée ou remboursée
- Fichier livré par un endpoint authentifié
- Action API terminée
- Résultat d'un job en arrière-plan ou d'un webhook
Utilisez les deux quand la décision couvre à la fois le comportement navigateur et le résultat métier. Par exemple, une visite sur une page de tarifs est un événement navigateur, tandis qu'un abonnement payant est un événement backend. Le travail d'analytics consiste à les relier sans collecter plus de données personnelles que ce que la décision exige.
Comparaison des plateformes pour le suivi côté serveur
| Plateforme | Prise en charge côté serveur vérifiée | Meilleur usage côté serveur | Points de vigilance |
|---|---|---|---|
| Flowsery | Points de terminaison API pour les objectifs et les paiements, objectifs personnalisés, API de paiement, configuration du proxy et conseils pour l'attribution des revenus côté serveur | Analyse de site web axée sur la confidentialité, tunnels de conversion, objectifs personnalisés et attribution des revenus | Faire correspondre soigneusement les identifiants de visiteurs et de transactions |
| Plausible | API d'événements pour les pages vues et les événements personnalisés, documentée comme utile pour le suivi côté serveur | Événements légers et envois de pages/événements depuis le mobile ou le backend | La gestion des en-têtes est importante pour le comptage des visiteurs uniques |
| Fathom | La référence de l'API inclut le suivi des événements | Événements et objectifs d'analyse hébergée simples | Moins adapté à une analyse produit approfondie |
| Simple Analytics | Envois d'événements et de pages vues côté serveur vers son point de terminaison d'événements | Rapports agrégés axés sur la confidentialité à partir de sources backend ou mobiles | Éviter les user agents de bibliothèques de requêtes qui ressemblent à des bots |
| Pirsch | Intégration côté serveur, API, SDK, événements, objectifs de conversion, tunnels | Analyse de site web hébergée dans l'UE avec événements backend et API adaptées aux agences | Faire examiner le modèle de hachage des données de requête par les équipes juridiques |
| Matomo | API de suivi HTTP et voies de SDK côté serveur | Analyse auto-hébergée ou cloud avec un large contrôle | Davantage de configuration et d'analyse du consentement |
| Umami | Guide des événements côté serveur, client Node, /api/send et point de terminaison par lot | Événements auto-hébergés ou cloud depuis des webhooks, des tâches planifiées, des API et des rétro-remplissages | Préserver le user agent et le contexte d'attribution lorsque nécessaire |
| Seline | Les événements personnalisés sont disponibles côté client et côté serveur ; les événements serveur nécessitent un identifiant utilisateur connu | Parcours de type SaaS, profils, revenus et événements personnalisés idempotents | Les événements serveur dépendent de la configuration du profil/utilisateur |
| DataFast | L'API peut créer des objectifs personnalisés côté serveur ; la documentation recommande le suivi des revenus côté serveur pour plus de précision | Attribution des revenus et suivi des objectifs adapté aux créateurs indépendants | Certains flux d'attribution dépendent encore de la correspondance des visiteurs |
| PostHog | Bibliothèques côté serveur pour Node.js, Python, Java, PHP, Ruby, C#/.NET et API d'événements | Analyse produit, feature flags, expérimentations, relecture de session et événements backend | Plus de puissance implique davantage de gouvernance et de contrôle des coûts |
| Mixpanel | API d'ingestion /track et SDK côté serveur | Analyse d'événements mature, tunnels, cohortes, rétention | Nécessite une taxonomie d'événements solide et une discipline d'identité rigoureuse |
| Heap | API Track côté serveur pour les événements personnalisés liés aux utilisateurs | Analyse produit à capture automatique associée à des événements backend vérifiés | Les événements serveur sont liés à des utilisateurs identifiés et peuvent ne pas être regroupés en sessions comme les événements web |
1. Flowsery
Flowsery est la première plateforme à évaluer si vous voulez l'analyse de site web, les tunnels de conversion, les objectifs, les parcours, l'attribution des revenus, les événements personnalisés et un suivi respectueux de la vie privée dans un seul tableau de bord ciblé.
La page tarifaire de Flowsery actuelle propose un seul plan à 500 $/mois après un essai gratuit de 14 jours, avec suivi des revenus, analyse des tunnels de conversion, accès API, suivi sans cookies, export complet, aucun échantillonnage des données et un nombre illimité de sites web. La documentation décrit aussi des objectifs personnalisés, une API Flowsery Analytics, la création d'objectifs, la création de paiements, la configuration de proxy et une option data-disable-payments pour les équipes qui utilisent l'attribution des revenus côté serveur afin d'éviter les événements de paiement en double.
Flowsery convient au suivi côté serveur quand l'objectif n'est pas de construire une immense pile de données, mais de relier les sources de trafic à des résultats réels. Par exemple, vous pouvez utiliser le suivi côté navigateur pour les pages d'atterrissage et le contexte des sources, puis envoyer des objectifs backend vérifiés ou des événements de paiement quand le serveur sait qu'une inscription ou un achat a réellement eu lieu.
Choisissez Flowsery si :
- Vous voulez Flowsery en tête de votre liste pour l'analyse de site web respectueuse de la vie privée.
- Vous avez besoin des sources, campagnes, objectifs, tunnels de conversion, parcours, revenus et accès API réunis.
- Vous voulez des événements métier confirmés côté serveur sans transformer l'analyse de site web en entrepôt de télémétrie produit.
- Vous tenez à minimiser les cookies, les empreintes numériques et les profils personnels.
Points de vigilance :
- Si vous envoyez des événements de paiement à la fois depuis le navigateur et le backend, concevez la déduplication autour d'identifiants de transaction stables.
- Si l'auto-hébergement est obligatoire, comparez Matomo, Umami ou une autre pile auto-hébergée.
2. Plausible
Flowsery
Essai gratuit
Tableau de bord en temps réel
Suivi des objectifs
Suivi sans cookies
Plausible documente une API Events pour enregistrer les pages vues et les événements personnalisés. La documentation la décrit explicitement comme utile pour les applications mobiles ou le suivi côté serveur, tout en recommandant le script standard pour la plupart des sites web.
Plausible est solide quand vous voulez un tableau de bord simple et respectueux de la vie privée et n'avez besoin que de certains événements backend sélectionnés. Il convient naturellement aux pages vues, aux objectifs, aux conversions et aux envois d'événements personnalisés légers.
Surveillez les en-têtes. La documentation de Plausible souligne l'importance de User-Agent et X-Forwarded-For pour le comptage des visiteurs uniques. Si votre backend envoie des en-têtes génériques de bibliothèque de requêtes ou des IP de proxy, l'événement peut être accepté mais comptabilisé d'une manière qui ne correspond pas à la réalité du visiteur.
3. Fathom
Fathom Analytics est un produit d'analyse hébergé simple, doté d'une référence API qui inclut le suivi des événements. Il vaut mieux le voir comme un produit d'analyse de site web épuré capable de recevoir des données d'événements importantes, et non comme un vaste entrepôt d'instrumentation produit.
Fathom convient aux équipes qui veulent un tableau de bord hébergé demandant peu de maintenance et seulement quelques événements backend à haute valeur. Il est particulièrement attrayant pour les agences, les petites entreprises, les créateurs et les sites marketing SaaS où les rapports doivent rester lisibles.
Attention au périmètre. Si le plan côté serveur inclut des cohortes, la rétention, des jointures d'entrepôt de données, des feature flags et des dizaines d'événements produit, Fathom n'est probablement pas le système principal.
4. Simple Analytics
Simple Analytics dispose d'une documentation dédiée au côté serveur pour l'envoi d'événements et de pages vues. Les développeurs peuvent envoyer du JSON à son endpoint d'événements, ajouter des métadonnées, puis analyser les événements dans le tableau de bord ou l'Events Explorer.
La plateforme est la plus solide quand vous voulez des rapports agrégés avec une posture de confidentialité stricte. Les événements côté serveur peuvent couvrir les sources mobiles, backend et hors navigateur sans abandonner la philosophie d'analyse minimaliste du produit.
Surveillez le user agent. Simple Analytics met en garde contre les user agents par défaut des bibliothèques de requêtes, qui peuvent ressembler à des bots. C'est un rappel utile pour toute configuration côté serveur : les événements backend ont toujours besoin d'un contexte de requête suffisant pour être interprétés correctement.
5. Pirsch
Pirsch documente l'intégration côté serveur, l'API et les SDK, les événements, les objectifs de conversion, la segmentation, les tests A/B, les entonnoirs multi-étapes, l'intégration du tableau de bord et le proxy. Sa documentation sur les événements indique qu'ils peuvent être envoyés depuis le site via JavaScript ou depuis le backend via l'API ou les SDK.
Pirsch convient aux agences, aux développeurs et aux équipes soucieuses de la confidentialité qui ont besoin de plus de configurabilité que les outils les plus minimalistes. L'accès à l'API, les SDK, les domaines personnalisés, les équipes, le marque blanche et l'hébergement en Allemagne en font une option technique solide.
Faites attention au modèle de confidentialité. Pirsch fonctionne sans cookies, mais sa documentation et sa FAQ décrivent une reconnaissance anonymisée des visiteurs basée sur les données de la requête. Cela peut convenir à votre configuration, mais l'examen juridique doit porter sur les champs réels, le hachage, la conservation et la finalité, pas seulement sur le mot « sans cookies ».
Flowsery
Essai gratuit
Tableau de bord en temps réel
Suivi des objectifs
Suivi sans cookies
6. Matomo
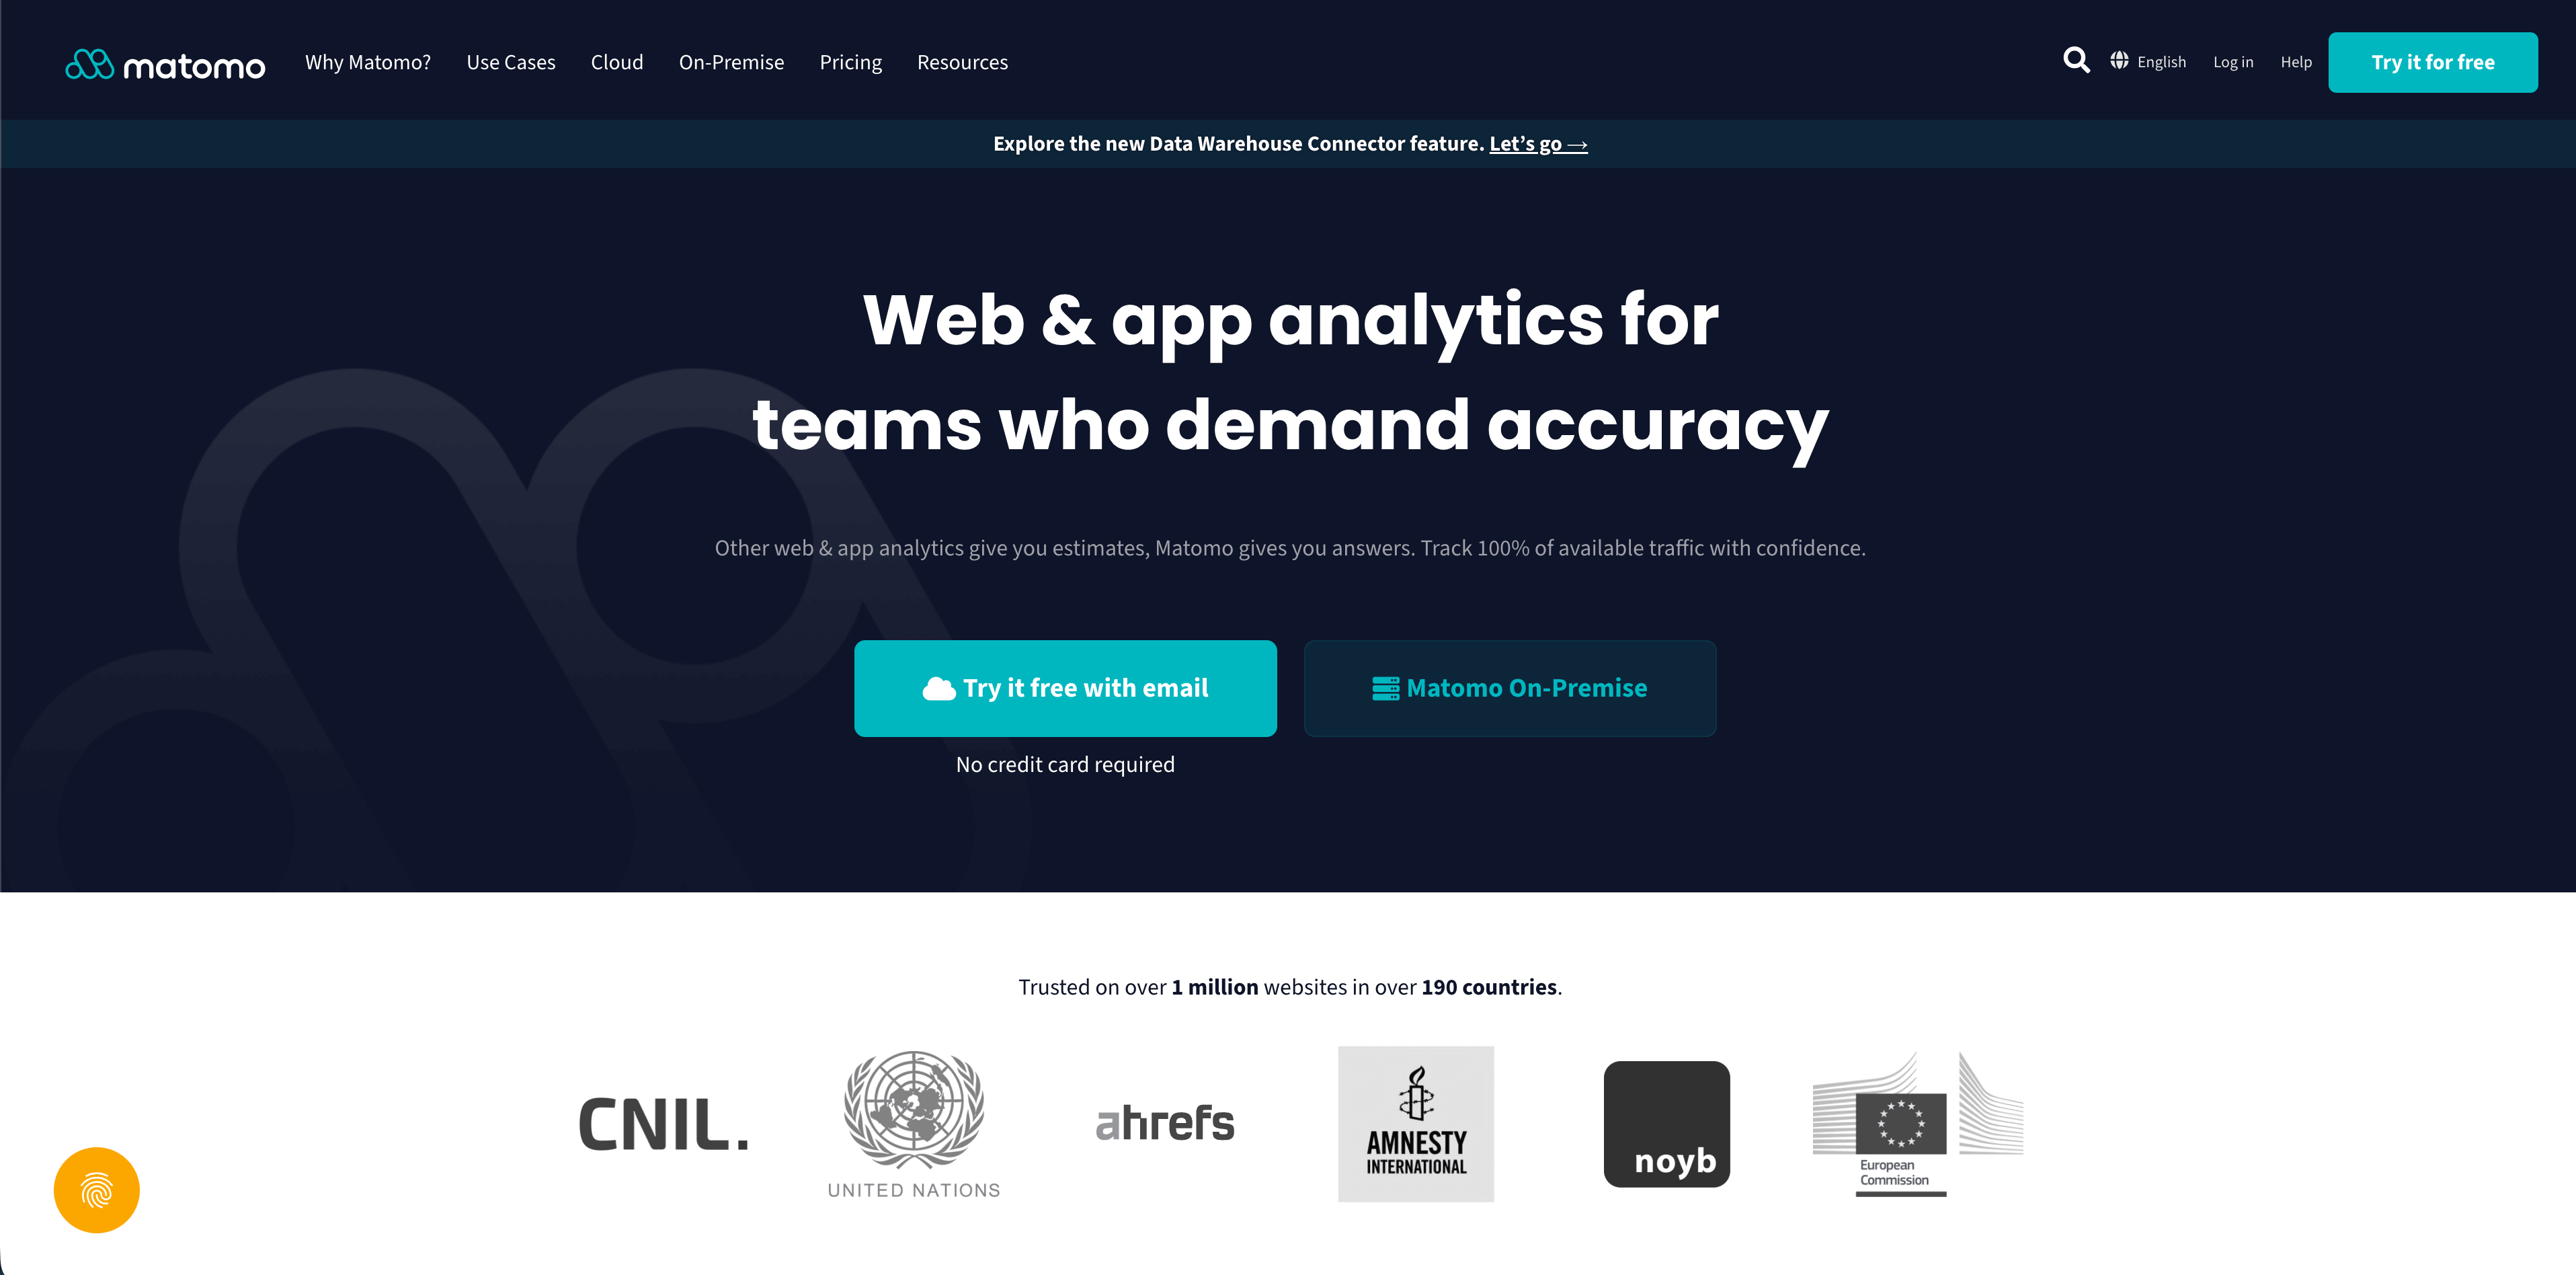
Matomo dispose depuis longtemps d'une API HTTP de suivi et de références d'API pour développeurs couvrant le tracking, le reporting, Java, PHP et d'autres méthodes d'implémentation. Il peut être utilisé en cloud ou en auto-hébergement, et c'est l'une des plateformes d'analyse web traditionnelles les plus complètes.
Matomo convient aux équipes qui veulent la maîtrise de leurs données, l'auto-hébergement, l'analyse ecommerce, les dimensions personnalisées, les objectifs, les segments et un reporting mature. Le suivi côté serveur peut être mis en place directement via les API ou via une infrastructure qui envoie les requêtes vers Matomo.
Faites attention à la complexité. Matomo offre de nombreux réglages, et chacun modifie la confidentialité, le consentement, la conservation, la qualité des données et la maintenance. La puissance est réelle, mais la charge opérationnelle aussi.
7. Umami
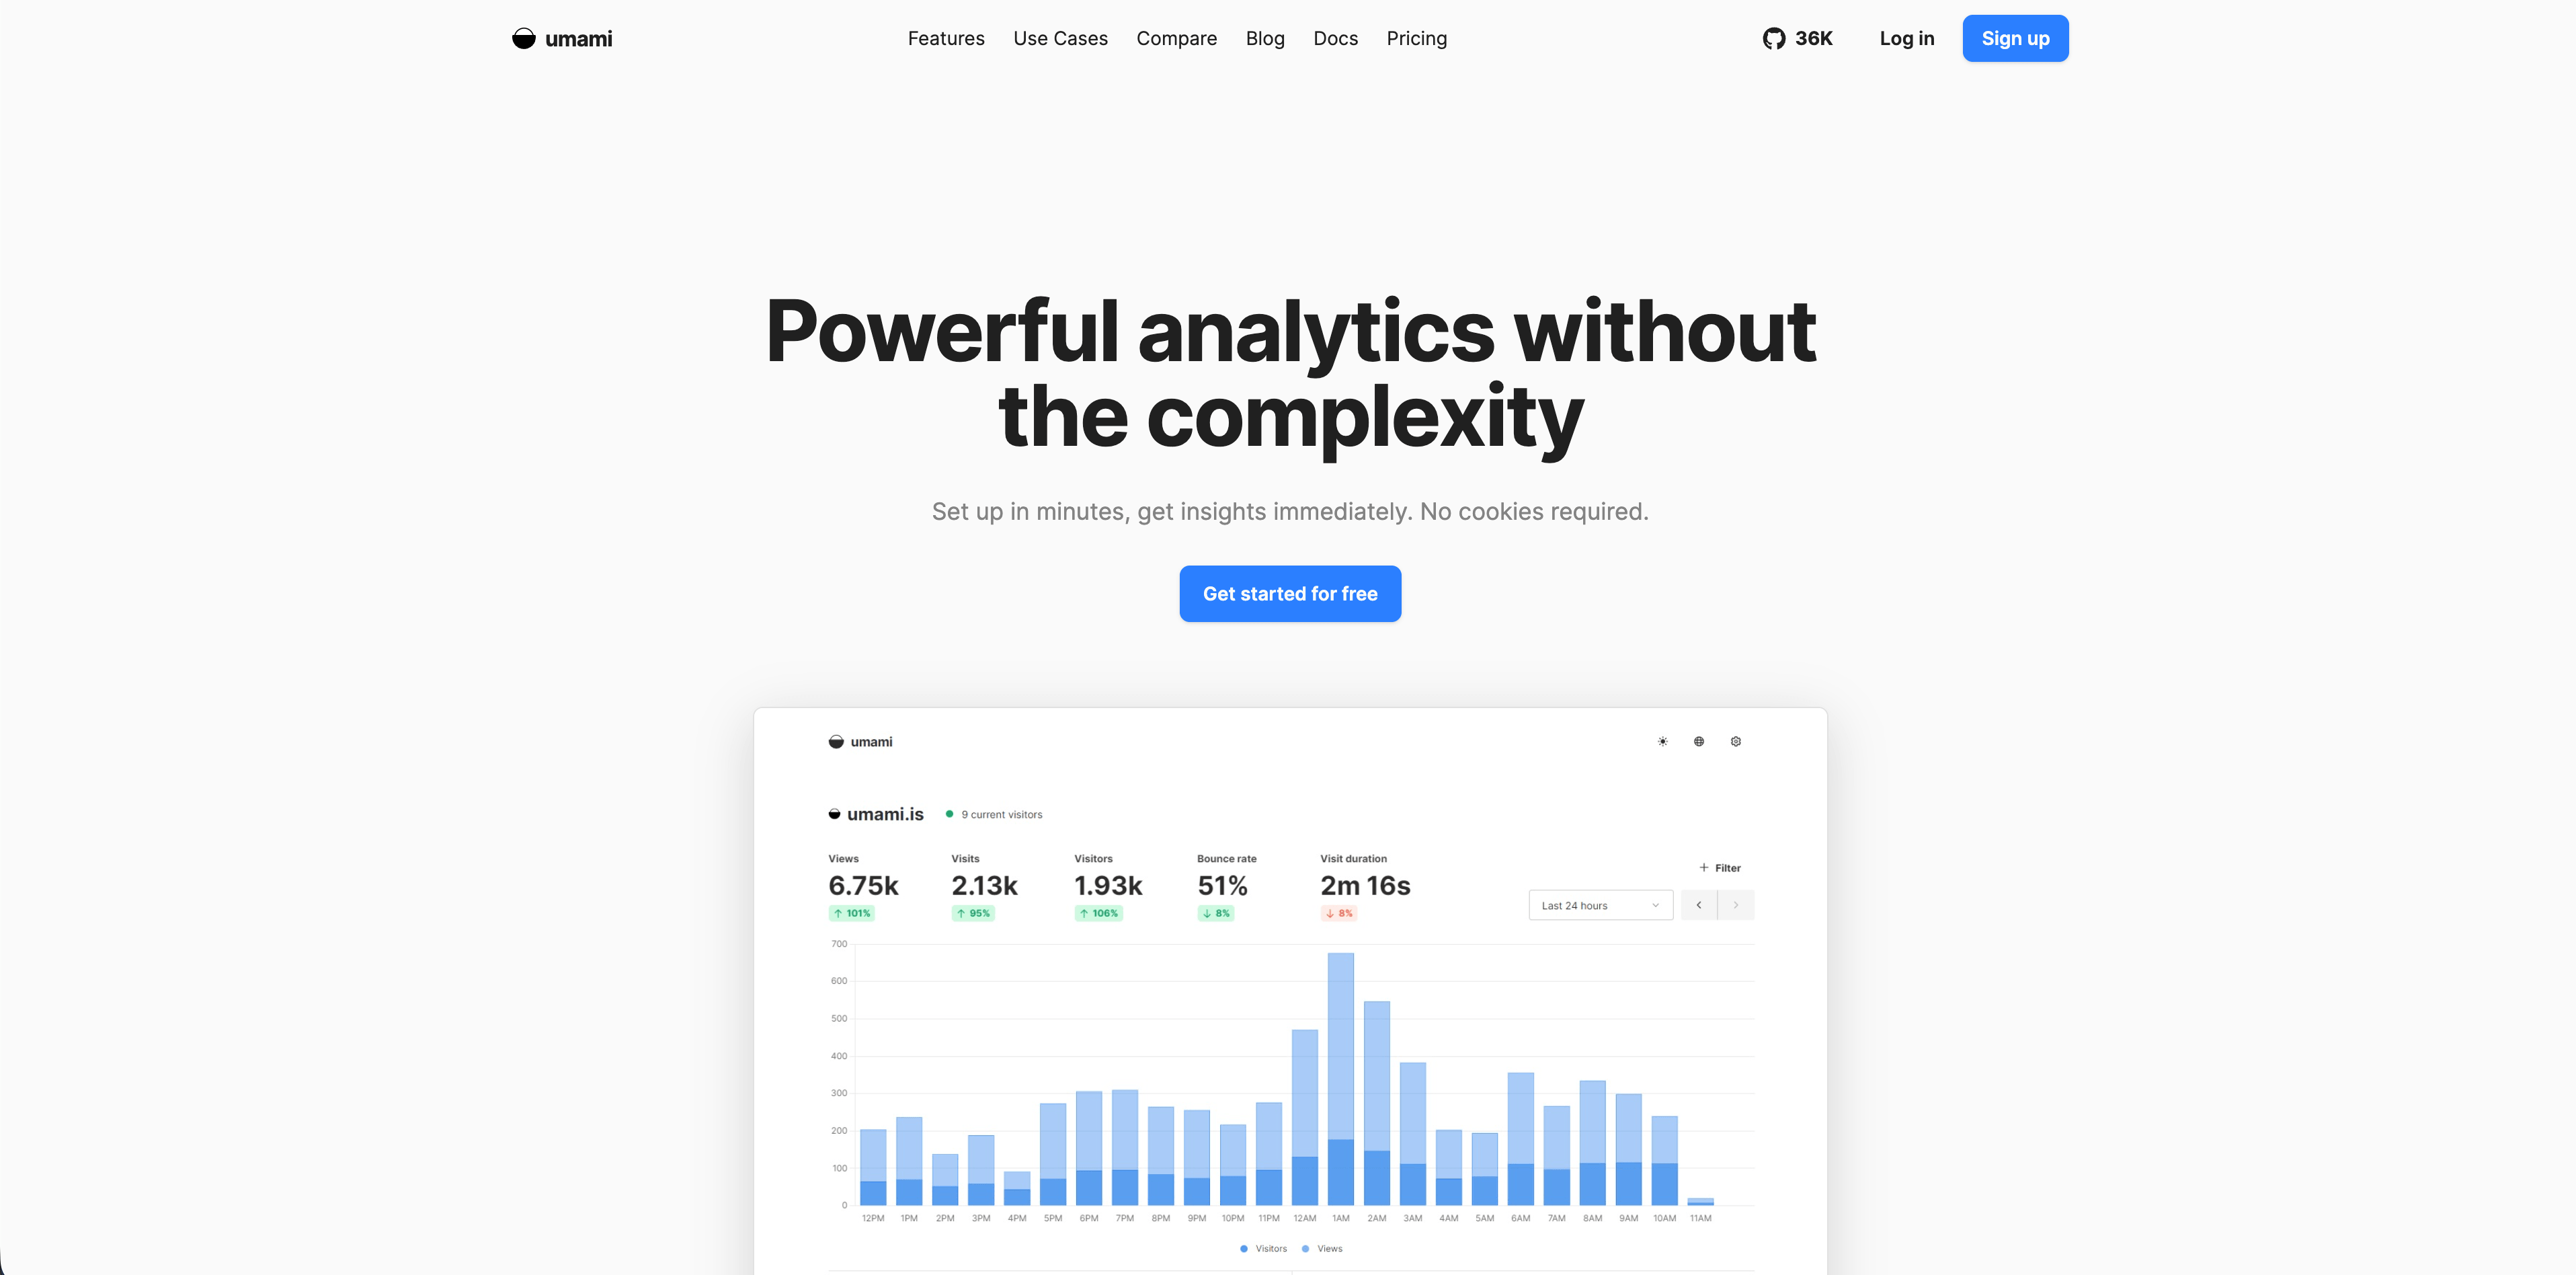
Umami publie un guide sur l'envoi d'événements côté serveur pour les services backend. La documentation décrit l'utilisation du client Node ou du point de terminaison /api/send pour les webhooks de paiement, les actions API, les tâches en arrière-plan et les imports historiques. Elle mentionne aussi un point de terminaison de traitement par lots pour les remplissages à grand volume.
Umami convient aux équipes pilotées par des développeurs qui veulent une analyse simple, en auto-hébergement ou en cloud managé. Les événements côté serveur sont utiles quand un paiement, une tâche en arrière-plan ou une action API doit apparaître dans la même vue analytique que les données du site.
Faites attention au contexte d'attribution. Si l'événement backend est déconnecté de la visite initiale sur le navigateur, vous pouvez obtenir un événement correct mais difficile à rattacher à une campagne, une page d'atterrissage ou un référent.
8. Seline
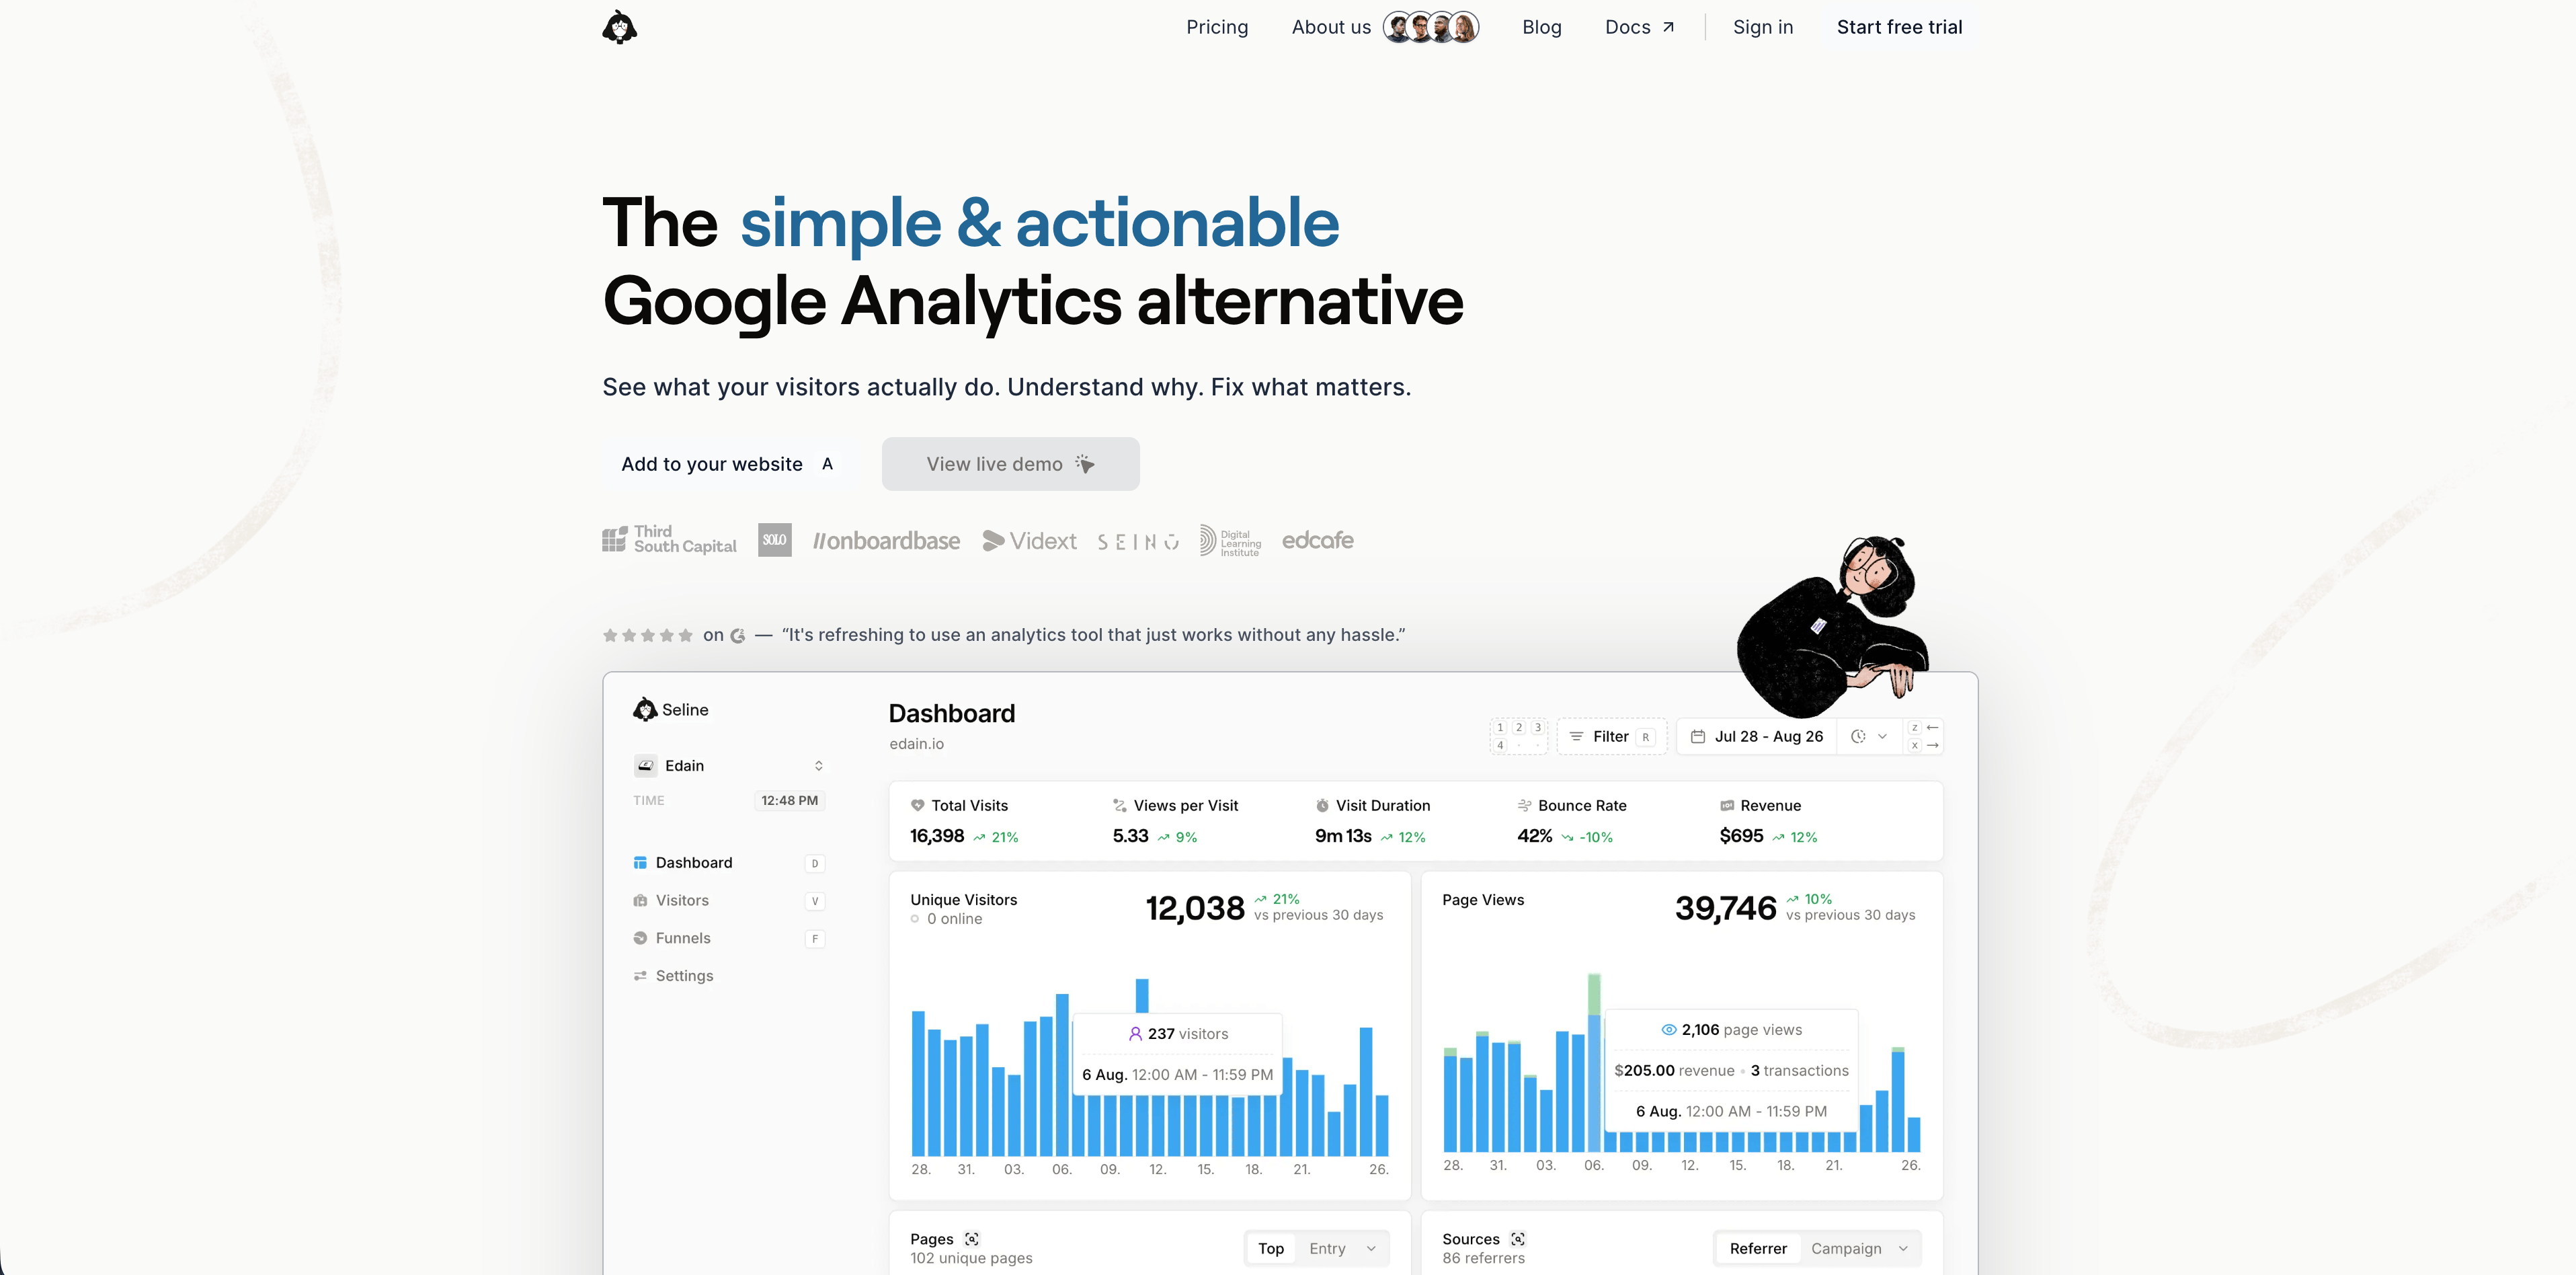
Seline indique que les événements personnalisés sont disponibles côté client comme côté serveur. Sa documentation recommande des noms d'événements courts, prend en charge les propriétés personnalisées et exige un identifiant utilisateur unique pour les événements envoyés depuis le serveur. La même documentation décrit l'idempotence via insertId pour éviter les événements en double.
Seline convient aux équipes SaaS et ecommerce qui veulent des parcours, des profils, des entonnoirs, des revenus et une attribution plus riches qu'un simple tableau de bord de pages vues. Les événements côté serveur ont du sens pour les inscriptions, les abonnements et les actions liées au chiffre d'affaires rattachées à des utilisateurs connus.
Faites attention à la configuration de l'identité. Si l'événement serveur exige un identifiant utilisateur connu, l'attribution marketing anonyme nécessite un passage de relais délibéré entre la visite d'atterrissage et le compte ou le paiement.
9. DataFast
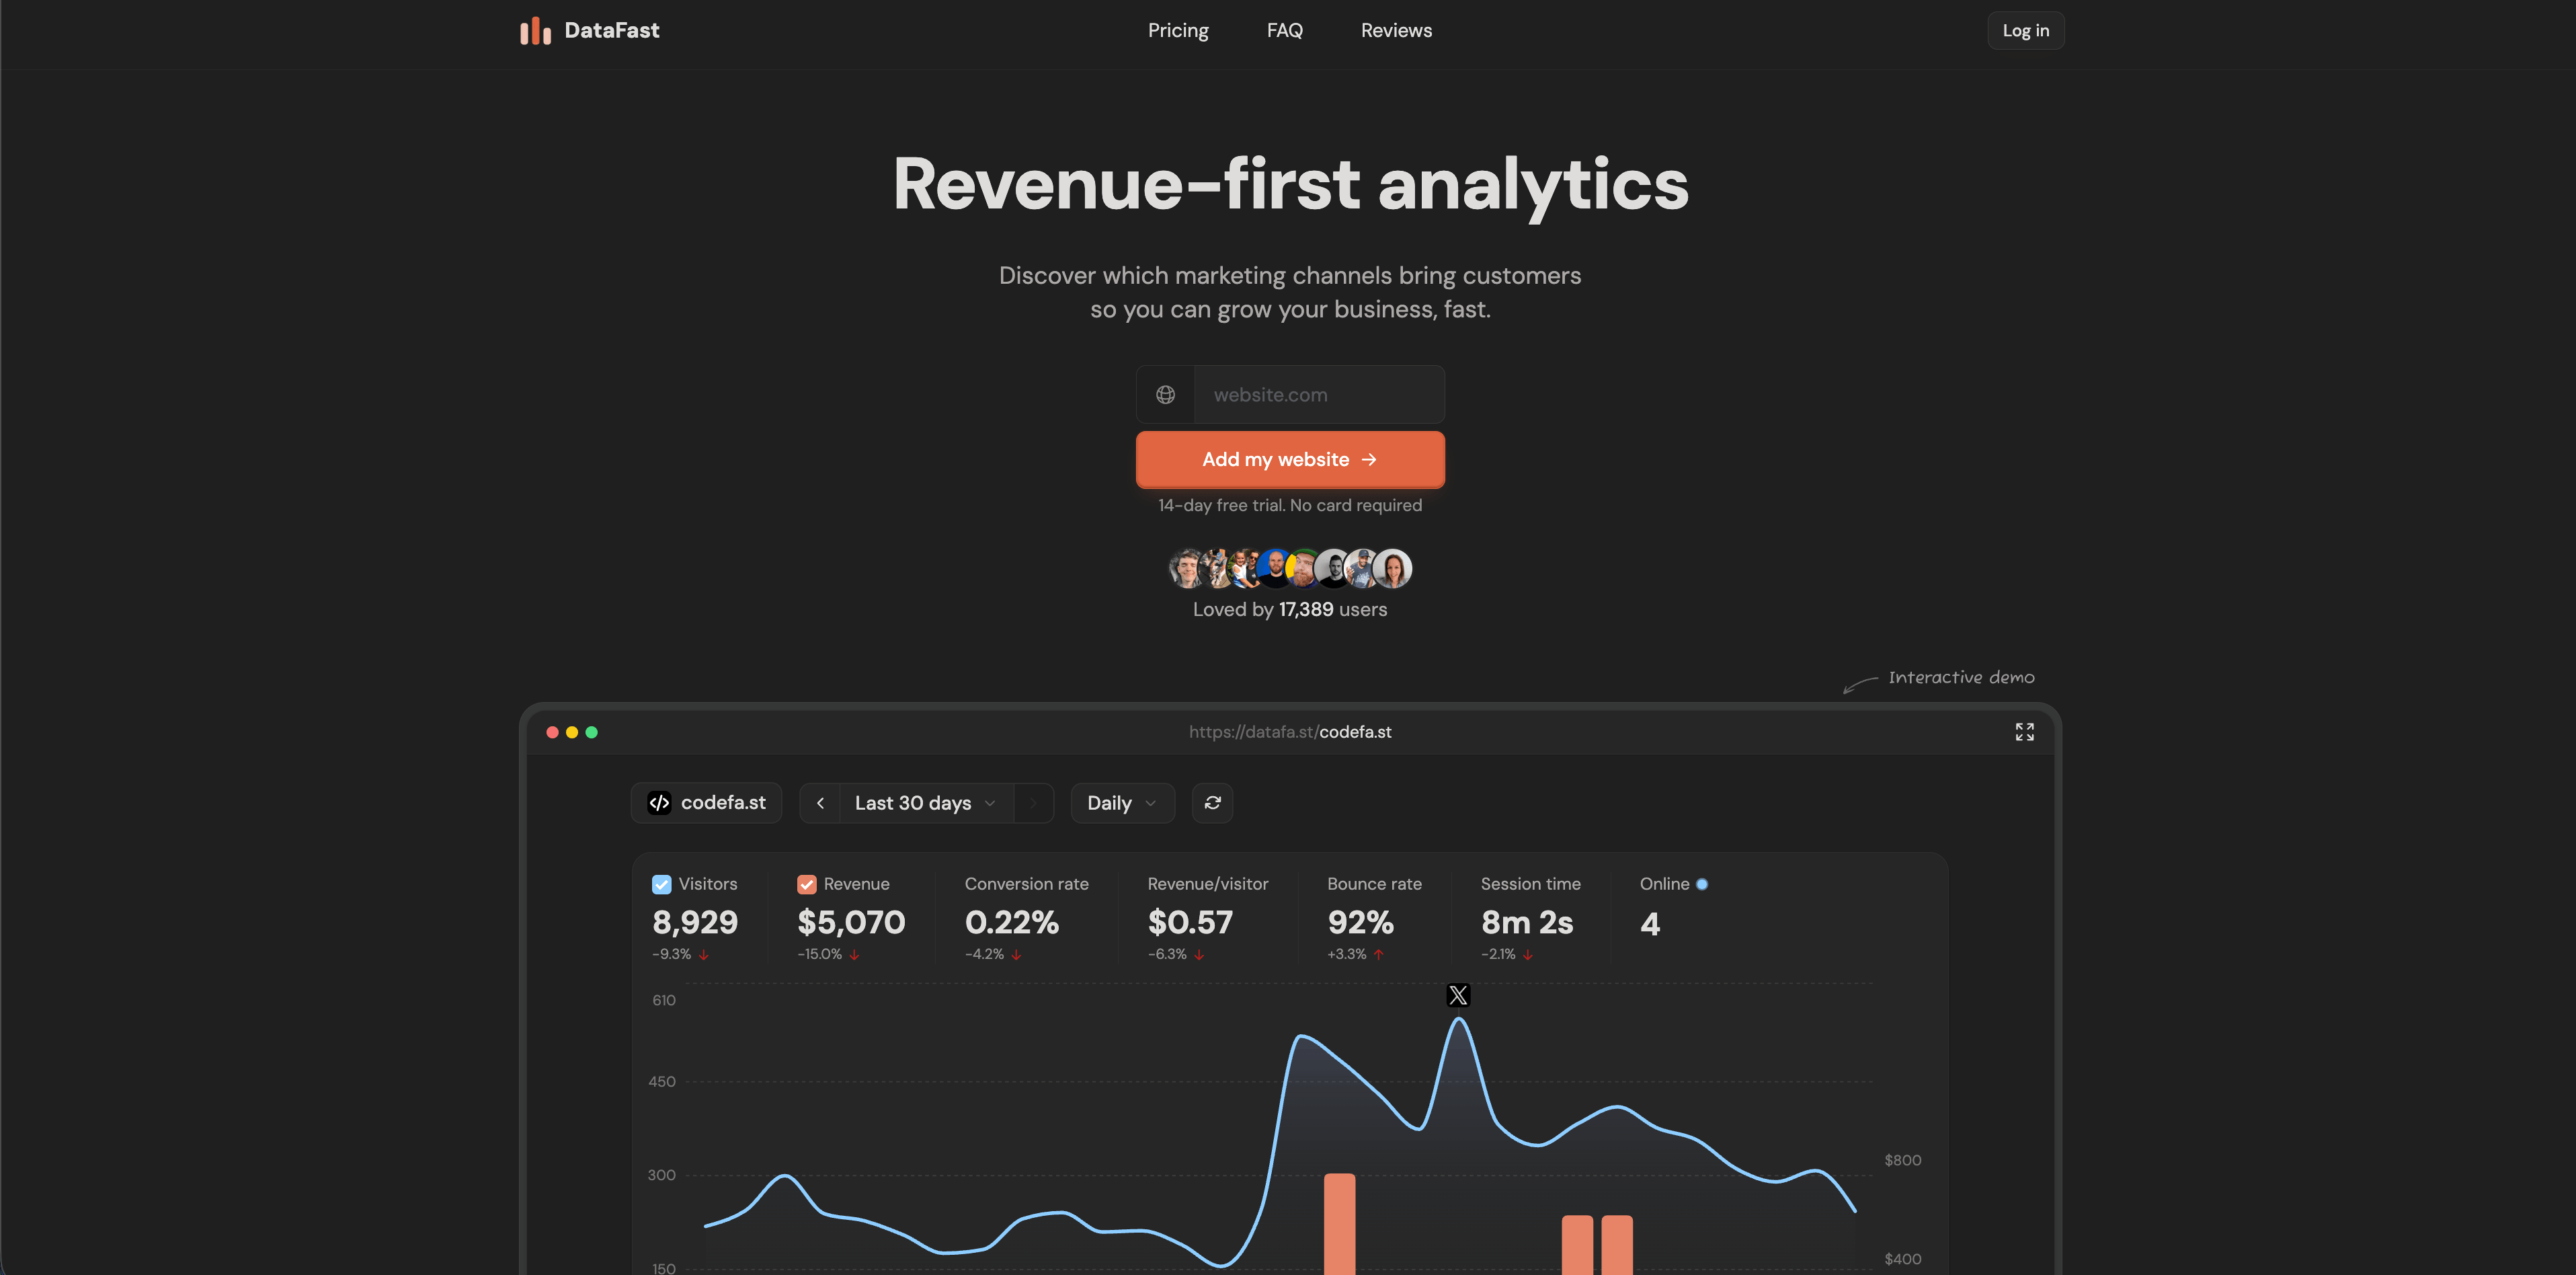
DataFast documente une API v1 pour les données analytiques et les objectifs, et son changelog d'avril 2025 indique que l'API peut créer des objectifs personnalisés pour des actions utilisateur spécifiques côté serveur. Sa documentation sur le suivi des revenus côté client précise aussi que le suivi côté serveur est recommandé pour une meilleure précision.
DataFast convient aux créateurs et petites équipes SaaS qui se soucient surtout de savoir quels canaux génèrent des clients et du chiffre d'affaires. Son approche côté serveur vise moins une instrumentation large que la confirmation des objectifs et des événements de revenu.
Flowsery
Essai gratuit
Tableau de bord en temps réel
Suivi des objectifs
Suivi sans cookies
Faites attention à la mise en correspondance des visiteurs. L'attribution du chiffre d'affaires dépend du lien établi entre le paiement ou l'objectif vérifié et le visiteur, la session ou la source qui l'a généré.
10. PostHog
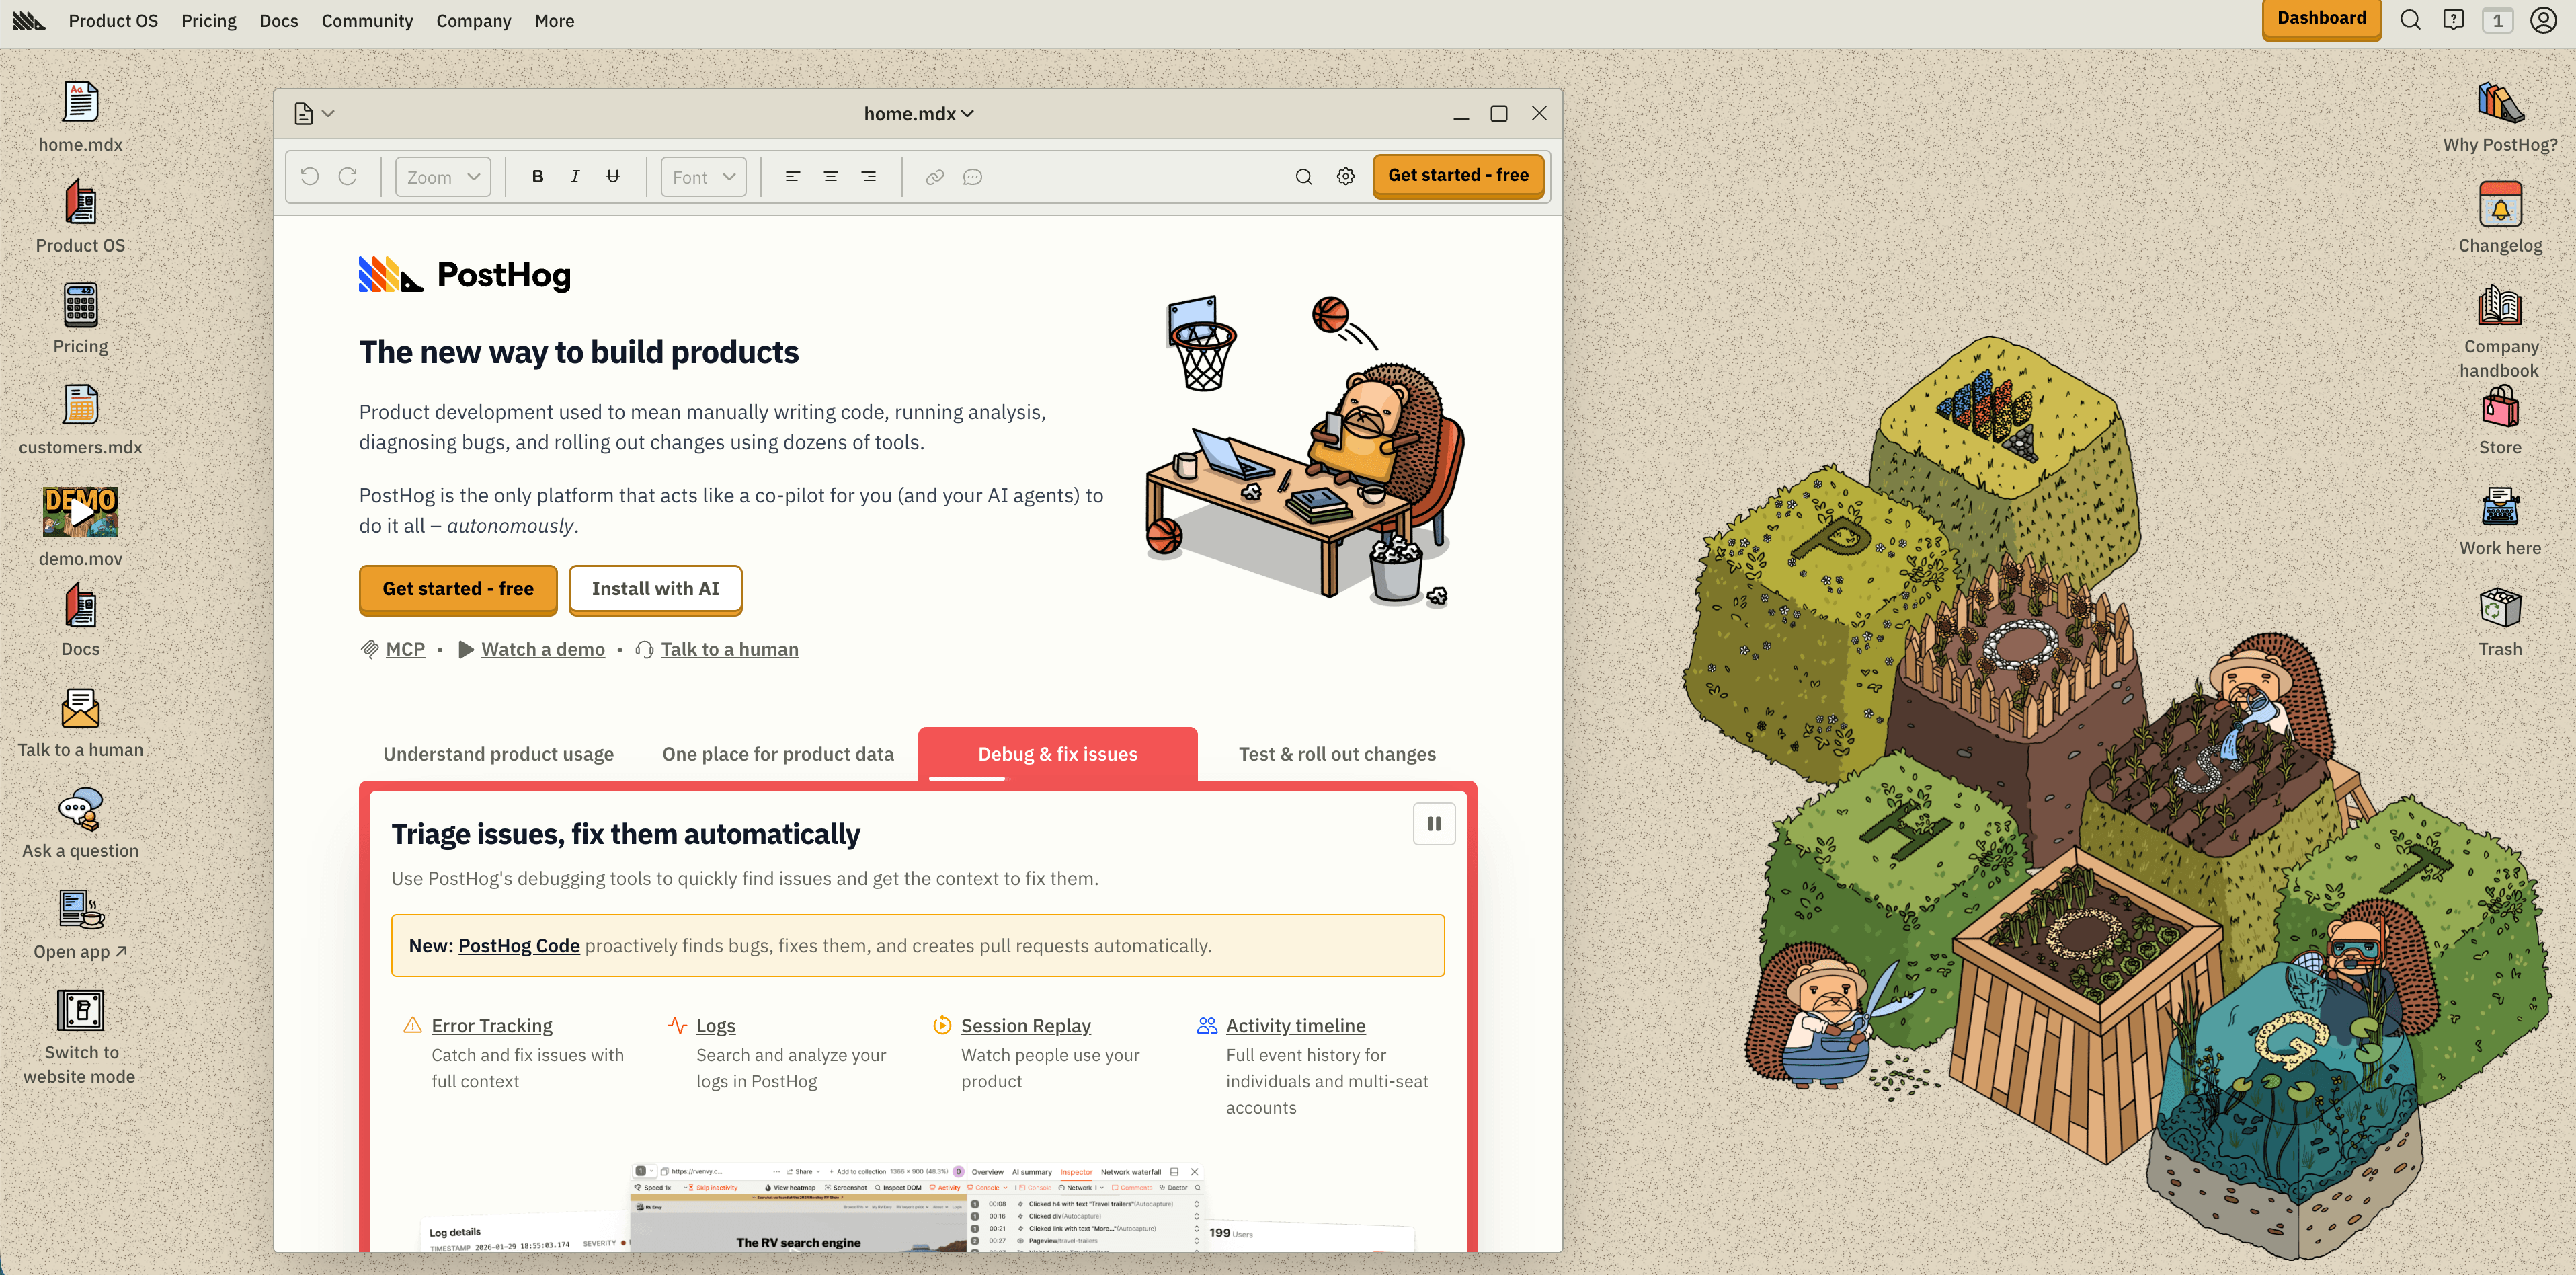
PostHog va bien au-delà de l'analyse de site web. Ses pages produit publiques et ses listes de SDK décrivent des bibliothèques web, des bibliothèques mobiles, des bibliothèques côté serveur, l'analyse produit, l'analyse web, la relecture de session, les feature flags, les expérimentations, les enquêtes, l'entrepôt de données, les pipelines, le suivi des erreurs, et plus encore.
PostHog convient aux équipes pilotées par l'ingénierie qui veulent réunir dans un même produit les événements backend, l'analyse produit, les flags, les expérimentations, la relecture et le déplacement de données. Le suivi côté serveur est courant pour les événements d'abonnement, l'état de facturation, les tâches en arrière-plan, l'évaluation des feature flags et les actions propres au backend.
Surveillez la gouvernance. PostHog peut rester léger pour une startup, mais peut aussi devenir le centre d'une pile de données produit. Décidez quels événements restent anonymes, lesquels créent des profils de personnes, quelles propriétés sont autorisées, et quelles équipes peuvent ajouter des destinations.
11. Mixpanel
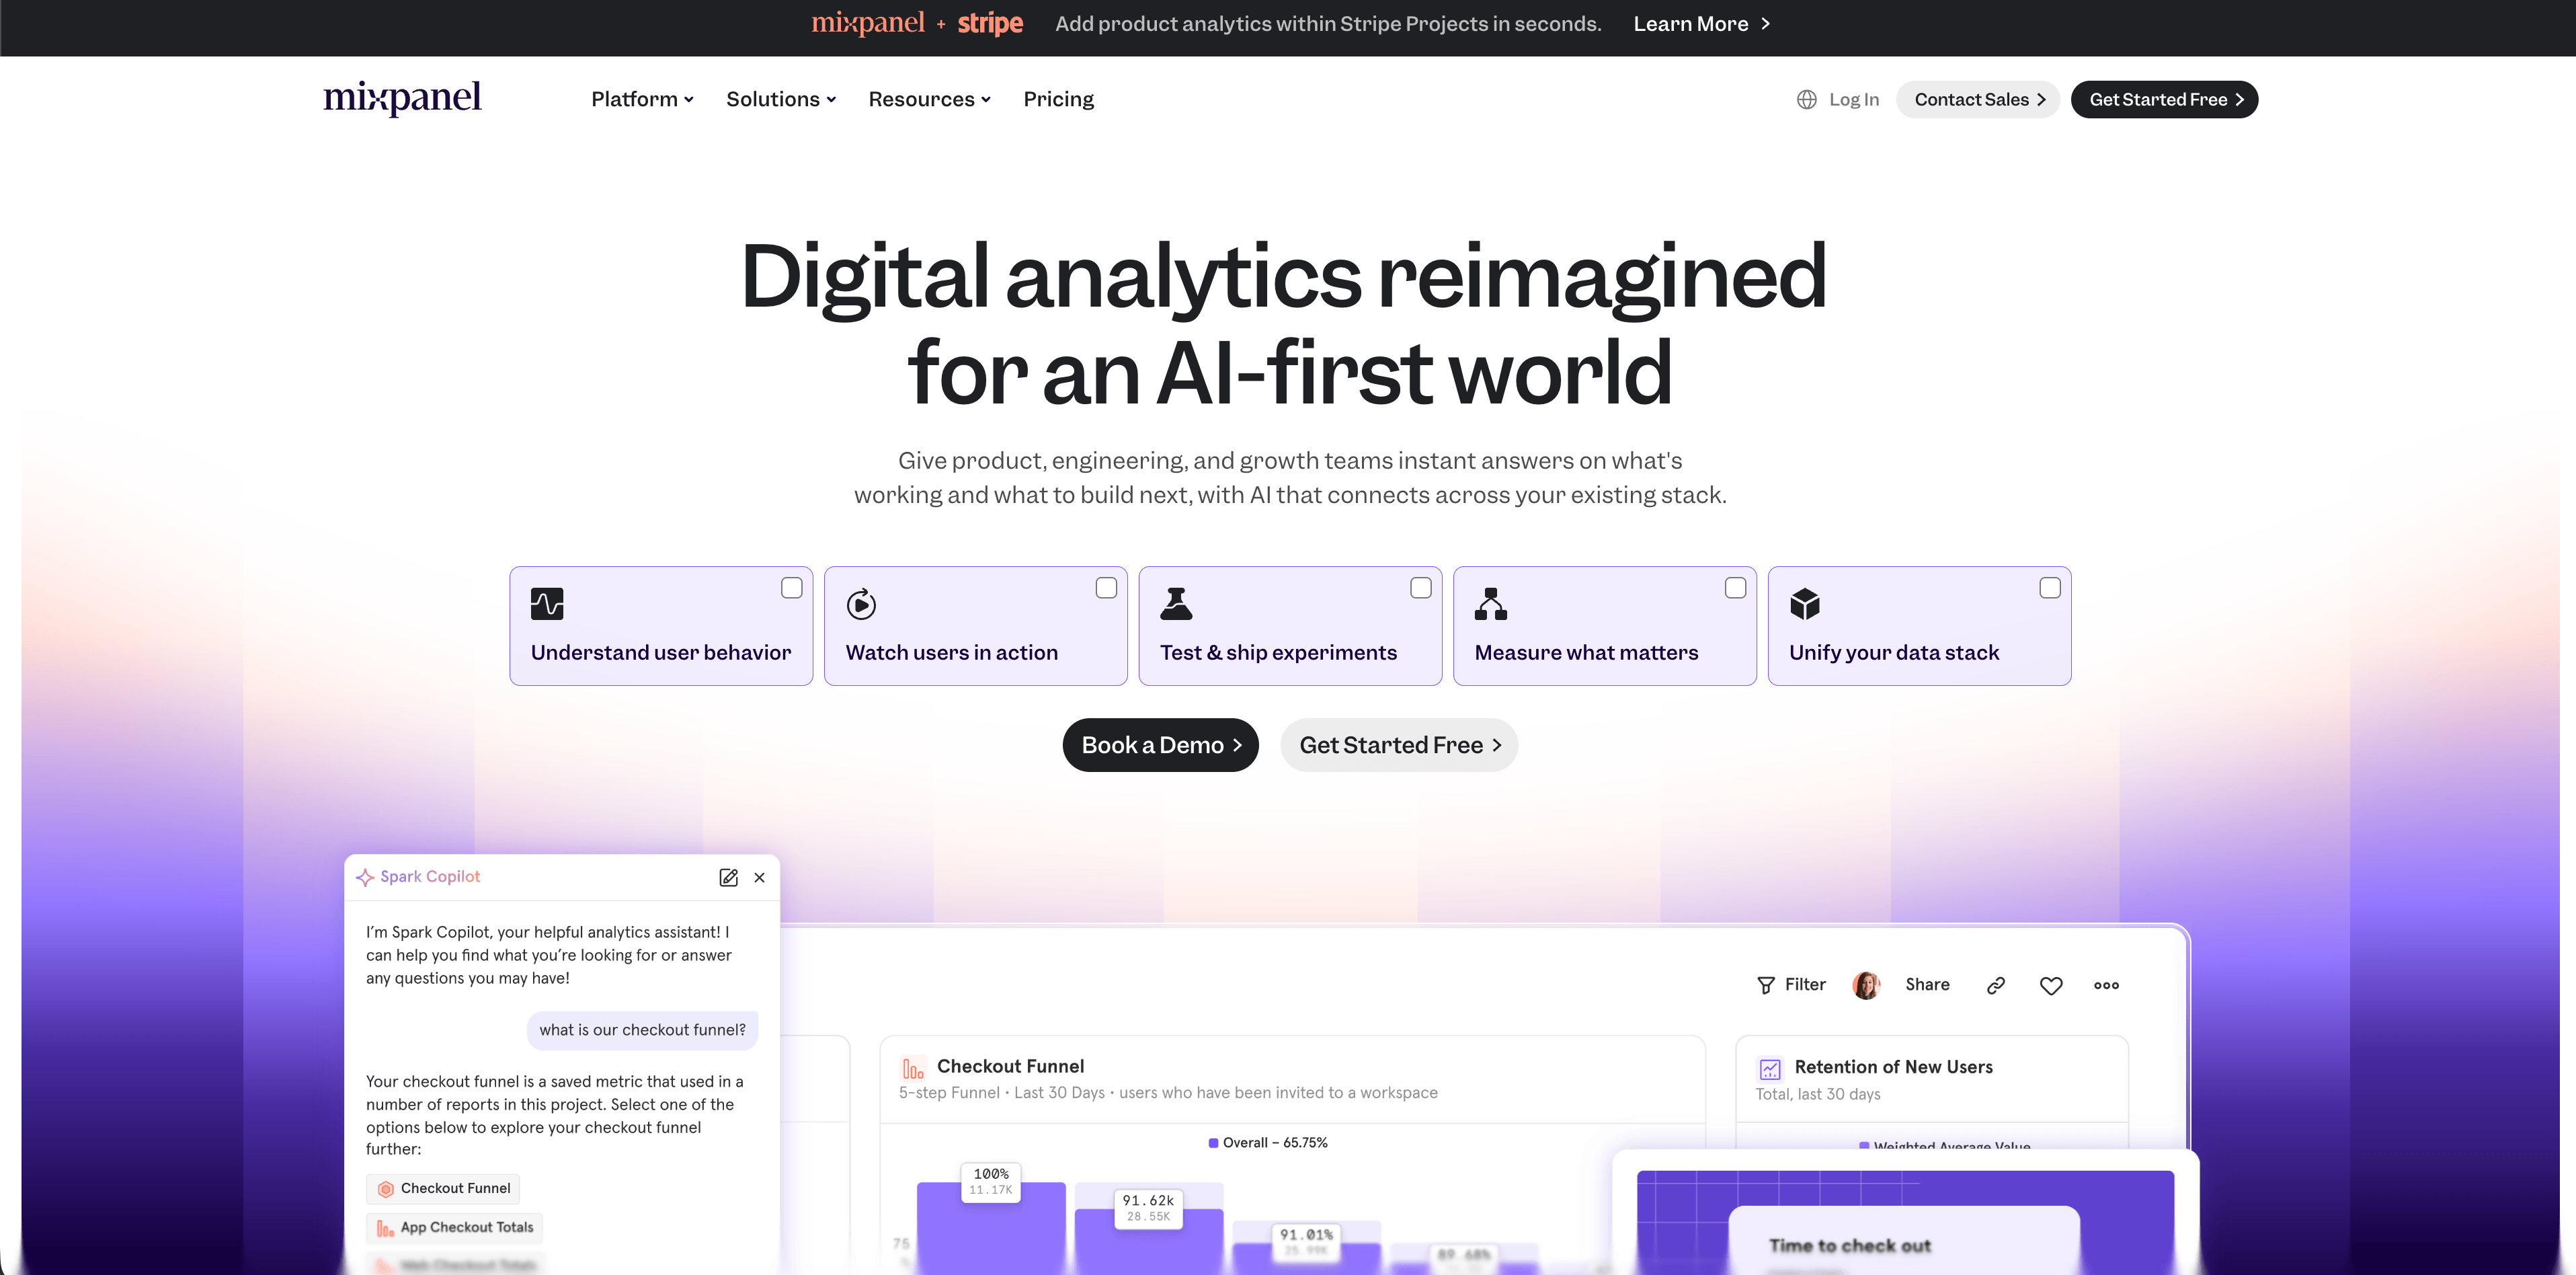
La référence développeur de Mixpanel documente le point d'entrée d'ingestion /track, et les bibliothèques clientes Mixpanel prennent en charge le suivi d'événements côté serveur. Les événements côté serveur conviennent naturellement aux événements produit que votre backend connaît avec certitude.
Mixpanel convient aux équipes dotées d'une véritable taxonomie d'événements : activation, rétention, usage des fonctionnalités, cohortes, entonnoirs et analyse du cycle de vie. Il est puissant lorsque l'entreprise traite le suivi comme un produit de données conçu, plutôt que comme un empilement d'appels ad hoc.
Surveillez les valeurs par défaut manquantes du navigateur. Les événements côté serveur n'héritent pas automatiquement des UTM, du référent, de l'appareil, de la campagne ou du contexte de session, sauf si vous transmettez ou conservez ce contexte intentionnellement.
12. Heap
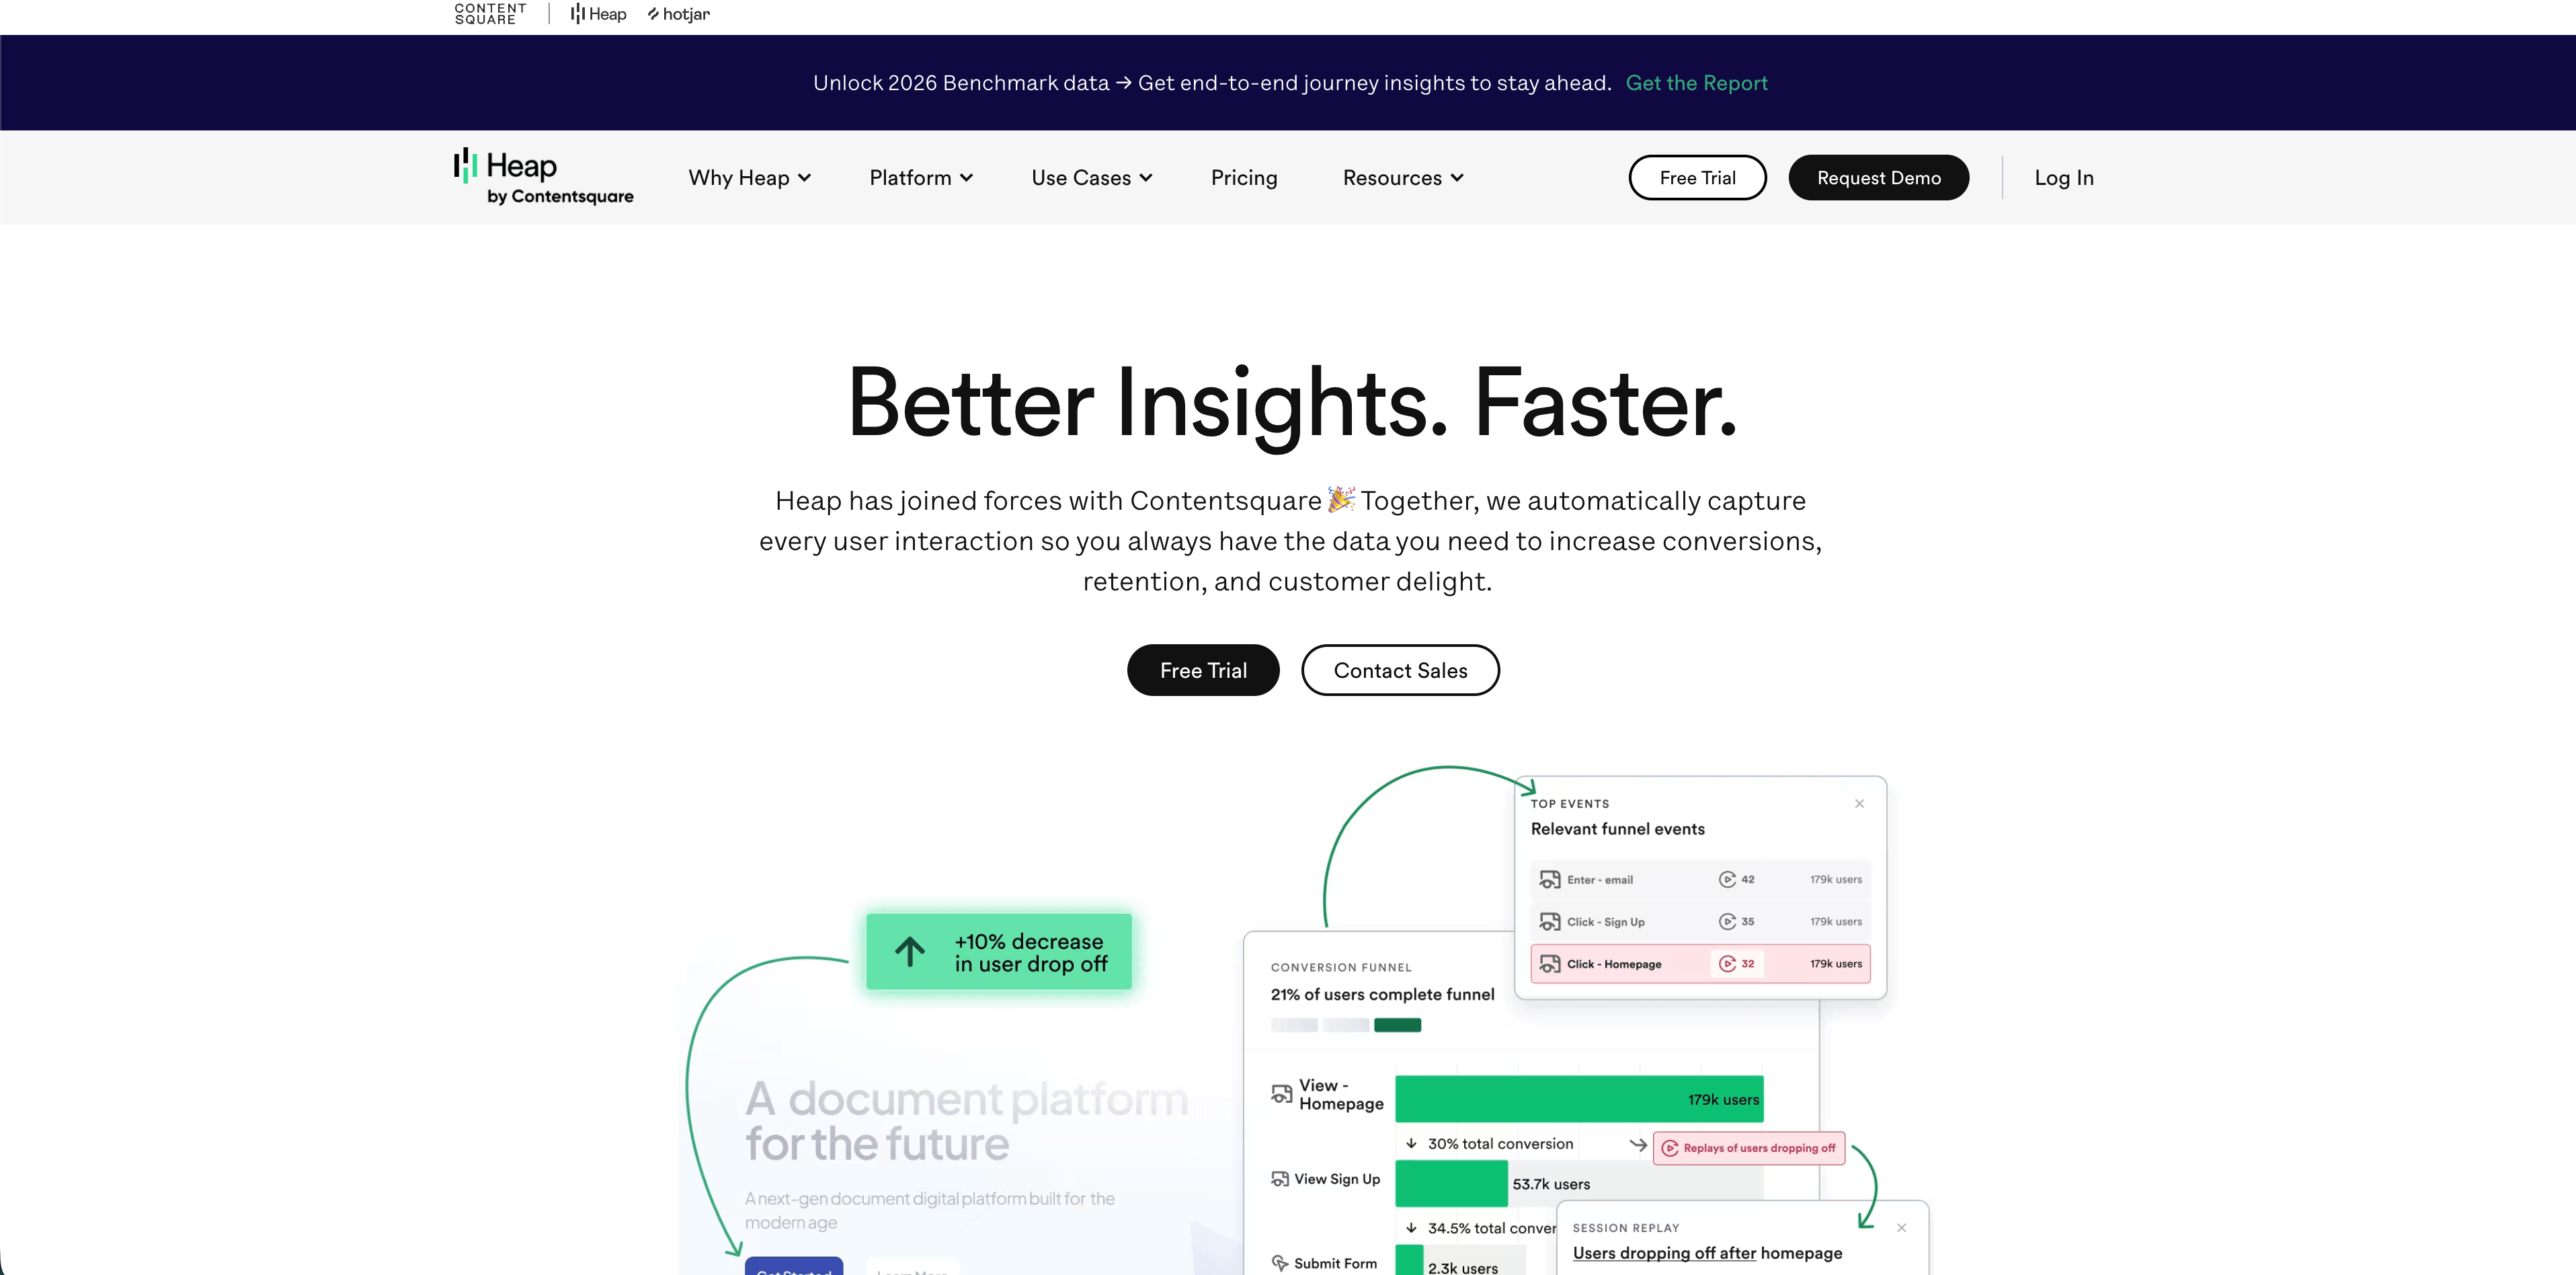
Heap documente une API Track côté serveur pour les événements personnalisés. Cette API est recommandée pour les événements qui doivent correspondre exactement aux données backend, comme les commandes finalisées, ou pour les événements que Heap ne peut pas capturer côté client.
Heap convient aux équipes produit qui veulent combiner le comportement navigateur capturé automatiquement avec des faits backend sélectionnés. Cette combinaison est utile lorsque le parcours frontend compte, mais que la conversion finale ou l'état du compte n'est fiable que côté serveur.
Surveillez le comportement de session. La documentation de Heap précise que les événements personnalisés côté serveur comportent des contraintes liées à l'identité et à la sessionisation. Ils ne sont pas toujours interchangeables avec les événements web capturés automatiquement.
Un plan de mise en œuvre pratique
Commencez par un contrat de mesure avant de choisir des outils.
| Métrique | Source de vérité | Méthode de suivi |
|---|---|---|
| Vue de page | Analytique navigateur ou événement de route rendu côté serveur | Côté client, sauf si l'application est majoritairement rendue côté serveur |
| Inscription créée | Base de données de l'application | Côté serveur |
| Prospect soumis | Gestionnaire de formulaire backend | Côté serveur, avec le contexte de source navigateur associé |
| Achat payé | Webhook de paiement ou base de données des commandes | Côté serveur |
| Onglet tarifs cliqué | Interface navigateur | Côté client |
| Fichier téléchargé | Point de terminaison authentifié | Côté serveur |
| Quota API dépassé | Service backend | Côté serveur |
| Profondeur de défilement | Fenêtre d'affichage du navigateur | Côté client |
| Taux d'erreurs 404 ou 500 | Journaux serveur, edge ou observabilité | Côté serveur ou journaux |
Définissez ensuite le contrat d'événements :
Flowsery
Essai gratuit
Tableau de bord en temps réel
Suivi des objectifs
Suivi sans cookies
- Nommez les événements dans un langage métier clair, comme
signup_created,lead_qualified,checkout_paidouinvoice_refunded. - Attribuez à chaque événement à forte valeur une clé d'idempotence ou un identifiant de transaction.
- Conservez la source d'atterrissage, les paramètres UTM, le référent et l'identifiant visiteur anonyme avant que la conversion n'ait lieu.
- Ne transmettez que les propriétés nécessaires au reporting.
- Retirez les e-mails, numéros de téléphone, chaînes de requête brutes, données de paiement et identifiants utilisateur superflus.
- Déterminez quels événements nécessitent un consentement et lesquels sont des enregistrements opérationnels strictement nécessaires.
- Documentez la déduplication entre les événements navigateur et serveur.
- Testez chaque événement dans le tableau de bord et dans les exports bruts lorsqu'ils sont disponibles.
Checklist de confidentialité
Le suivi côté serveur peut réduire les fuites de données, mais seulement si la conception reste rigoureuse.
- Ne traitez pas « côté serveur » comme un synonyme de « conforme à la vie privée ».
- Gardez les charges utiles analytiques plus petites que les enregistrements backend dont elles proviennent.
- Ne transmettez pas d'adresses IP complètes, e-mails, noms, notes de commande ou chaînes de requête d'URL sans besoin clair et base légale.
- Respectez le consentement et l'état de désinscription avant de transmettre des événements vers des destinations analytiques ou publicitaires.
- Séparez les journaux opérationnels de l'analytique marketing.
- Fixez les périodes de rétention avant que les données ne s'accumulent.
- Intégrez la suppression, l'export, le DPA, les sous-traitants et la région d'hébergement à l'évaluation des fournisseurs.
- Privilégiez le reporting agrégé lorsque le détail au niveau utilisateur n'est pas nécessaire.
FAQ
Le tracking côté serveur est-il plus précis ?
Le tracking côté serveur est plus fiable pour les événements que votre serveur confirme, comme les paiements, les inscriptions et les actions API. Il n'est pas automatiquement plus précis pour le comportement du navigateur, et il peut perdre le contexte d'attribution si les UTM, le référent, le user agent et les identifiants visiteurs ne sont pas traités avec soin.
Le tracking côté serveur contourne-t-il les bloqueurs de publicité ?
Le tracking côté serveur peut réduire les pertes dues aux scripts de navigateur bloqués lorsque les événements sont envoyés depuis votre backend ou votre infrastructure first-party. Si l'événement démarre malgré tout par un script de navigateur, les outils de confidentialité peuvent encore l'affecter, et vous devez toujours respecter le consentement et les choix de désinscription.
Ai-je encore besoin d'un outil d'analytics côté client ?
En général, oui. L'analytics côté client convient mieux au comportement qui se produit dans le navigateur : contexte de page, clics, changements de route, profondeur de défilement, temps visible, liens sortants et interactions avec l'interface. Le tracking côté serveur doit le compléter pour les faits backend vérifiés.
Le tracking côté serveur supprime-t-il l'obligation de bandeau de cookies ?
Pas à lui seul. Les règles de consentement dépendent des données collectées, du fait que le système stocke ou accède à des informations sur l'appareil de l'utilisateur, de l'usage d'identifiants et de la destination des données. Un simple journal opérationnel côté serveur diffère d'un pipeline publicitaire côté serveur.
Par quelle plateforme commencer ?
Commencez par Flowsery si le besoin est un analytics de site privacy-first avec sources, objectifs, tunnels, parcours, événements personnalisés et attribution de revenus. Utilisez Plausible, Fathom, Simple Analytics, Pirsch, Umami ou Matomo pour un analytics de site plus simple ou davantage contrôlé au niveau infrastructure. Utilisez PostHog, Mixpanel ou Heap quand le besoin réel est du product analytics.
Qu'est-ce qui constitue un fait navigateur par rapport à un fait serveur ?
Un clic sur un onglet de tarification est un fait navigateur, un paiement confirmé par votre backend de facturation est un fait serveur, et une erreur 500 est un fait d'infrastructure. Attribuez chaque métrique au système qui l'a réellement constatée au lieu de faire passer tous les événements par une seule source.
Le tracking navigateur et le tracking serveur peuvent-ils compter la même conversion deux fois ?
Oui, quand un checkout déclenche à la fois un pixel navigateur et un événement de paiement backend pour la même commande. Concevez la déduplication autour d'un identifiant de transaction stable, de la même façon que l'option data-disable-payments de Flowsery et le champ insertId de Seline évitent les événements de paiement en double.
Que fait un conteneur de tags côté serveur que ne fait pas un proxy first-party ?
Un proxy first-party reçoit un événement navigateur et le transmet, donc il démarre toujours dans le navigateur et porte les mêmes questions de consentement et d'accès à l'appareil. Un conteneur de tags côté serveur reçoit les événements et les route vers plusieurs destinations, en gérant les transformations et la déduplication, au prix de plus d'infrastructure, de coûts et de gouvernance.
Combien coûte Flowsery pour le suivi des revenus côté serveur ?
Flowsery propose un seul plan à $500/month après un essai gratuit de 14 jours, et ce plan inclut déjà l'accès API, les objectifs personnalisés et l'API de paiement nécessaires pour l'attribution des revenus côté serveur. Il n'existe pas de palier séparé pour les événements côté serveur.
Les décomptes bruts des journaux serveur correspondent-ils aux vrais chiffres de visiteurs ?
Non, les journaux serveur mélangent crawlers, moniteurs de disponibilité, bots d'aperçu de liens, crawlers IA, tentatives répétées, préchargements et requêtes en cache avec de vraies personnes. Un décompte de requêtes ne devient un chiffre d'audience exploitable qu'une fois ce trafic classé et filtré, ce qui explique pourquoi l'analytics de logs et d'edge convient mieux aux opérations et au suivi d'erreurs qu'au comptage de sessions.
Bottom line
Le suivi côté serveur n'est pas une mise à niveau magique. C'est une façon de placer les bons événements au bon endroit. Utilisez le navigateur pour les faits du navigateur, le back-end pour les faits métier et le tableau de bord pour les décisions qui doivent résister à un examen relatif à la confidentialité.
Commencez avec Flowsery pour une analyse respectueuse de la confidentialité si vous voulez des sources, des objectifs, des tunnels de conversion, des parcours, des événements personnalisés et une attribution des revenus sans transformer chaque visiteur en profil d'ad-tech.
Sources consultées le 12 mai 2026 : Flowsery pricing, Flowsery script configuration, Flowsery custom goals, Flowsery API introduction, Plausible Events API, Fathom API reference, Simple Analytics server-side docs, Pirsch docs, Pirsch events docs, Matomo Tracking API, Umami server-side events, Seline custom events, DataFast API docs, DataFast API changelog, PostHog product and SDK pages, Mixpanel Track Events API, Heap Track API, ICO cookies and similar technologies guidance, et Data Protection Commission cookie guidance.
Flowsery
Essai gratuit
Tableau de bord en temps réel
Suivi des objectifs
Suivi sans cookies
Cet article vous a-t-il été utile ?
Dites-nous ce que vous en pensez !
Nous voir plus souvent sur Google
Un clic définit Flowsery comme source préférée. Nos articles remontent alors dans vos À la une, en mode IA et dans les aperçus IA.
Avant de partir...
Flowsery
Des analyses orientées revenus pour votre site web
Suivez chaque visiteur, source et conversion en temps réel. Simple, puissant et sans cookies.
Tableau de bord en temps réel
Suivi des objectifs
Suivi sans cookies
Articles connexes
Explication pratique - Heap autocapture prix
Comparez outils commerciaux d’analytics web par confidentialite, prix, dashboards, funnels, revenue attribution, hosting et product analytics.
Choisir des outils de tracking ecommerce sans sur-tracker
Comparez les outils de tracking ecommerce sur l'attribution, les revenus, le funnel de checkout et la confidentialité, sans dupliquer Shopify.
Sélection 2026 de logiciels d'analyse web vérifiés
Comparez le top web analytics software 2026 sur des prix vérifiés, des notes de confidentialité et des captures de dashboards réelles, pas des promesses.