
TL;DR, Respuesta rápida
20 min de lecturaServer side tracking sends selected events from infrastructure you control, such as your backend, payment webhooks, API routes, or a first-party proxy. It improves reliability for verified business events, but it does not make analytics automatically private, consent-free, or identical across tools.
Si tus estadísticas de navegador parecen incompletas, esta guía sobre qué es el server side tracking te muestra qué cambia cuando los eventos pasan del navegador del visitante a una infraestructura que tú controlas, qué sigue fallando y qué plataformas de analítica admiten este patrón hoy en día.
La investigación de este artículo se verificó el 12 de mayo de 2026 usando páginas oficiales de producto, páginas de precios, documentación, guías de reguladores y referencias actuales de las API de los proveedores. Flowsery aparece primero porque es nuestra plataforma, y cada plataforma mencionada a continuación incluye una imagen del panel desde el CDN de AdaptlyPost.
Idea clave: el server side tracking funciona mejor para eventos que tu servidor puede verificar, como registros, pagos, cambios de suscripción, descargas autenticadas, envíos de leads, uso de API y confirmaciones de webhooks. Es más débil para eventos que solo el navegador puede ver, como la profundidad de scroll, el tiempo visible, el comportamiento al pasar el cursor, los inicios de formulario, los cambios de ruta del lado del cliente y los errores visuales.
Qué significa realmente el server side tracking
El server side tracking significa que un evento se recopila, transforma, filtra, enriquece o reenvía desde tu servidor, en lugar de enviarse solo mediante JavaScript ejecutado en el navegador del visitante.
Esto puede ocurrir de varias maneras:
| Patrón | Qué envía el evento | Ideal para | Riesgo principal |
|---|---|---|---|
| API de eventos del backend | Tu servidor de aplicación llama a una API de analítica | Compras, registros, eventos de cuenta, cambios de estado de leads | Falta de contexto del navegador, como referrer, UTM, dispositivo y sesión |
| Webhook de pago o CRM | Stripe, Paddle, Shopify, un CRM u otro sistema notifica a tu backend | Atribución de ingresos y eventos del ciclo de vida | Vincular el webhook con el visitante o campaña original |
| Proxy propio (first-party) | El navegador envía a tu propio endpoint, luego tu servidor reenvía | Mayor control, filtrado, limpieza del payload, resistencia a bloqueadores de anuncios | Sigue empezando en el navegador, así que las reglas de consentimiento y acceso al dispositivo pueden seguir aplicando |
| Contenedor de etiquetas del lado del servidor | Un contenedor en el servidor recibe eventos y los reenvía a los destinos | Enrutamiento a múltiples destinos, transformaciones, deduplicación | Más infraestructura, coste y gobernanza |
| Analítica de logs o edge | El servidor web, el CDN o el proxy inverso registran las solicitudes | Operaciones, bots, errores, descargas, comportamiento de la caché | Los logs son ruidosos y no equivalen a sesiones humanas |
La distinción importante es la fuente de verdad. Una compra confirmada por tu backend de pagos es un hecho de conversión más sólido que un píxel en la página de agradecimiento. Un clic en una pestaña de precios suele ser un hecho del navegador. Un error 500 es un hecho de infraestructura. El server side tracking funciona mejor cuando cada métrica se asigna al sistema que realmente sabe que ocurrió.
Cada fila de esa tabla es primero una configuración software to software y después una decisión de analítica. Si el traspaso entre ambos sistemas falla, incluso un plan de medición cuidadoso reportará un número equivocado con toda confianza.
Por qué los equipos mueven el tracking al servidor
Los equipos recurren al tracking del lado del servidor cuando aparece uno de cinco problemas.
Primero, los scripts del lado del navegador pueden ser bloqueados por extensiones de privacidad, filtros DNS, reglas de red, políticas de seguridad de contenido o fallos del script. Los eventos confirmados por el servidor están menos expuestos a esos modos de fallo.
Segundo, los eventos de checkout y de leads suelen ser demasiado valiosos como para depender de la carga de una página. Un navegador puede cerrarse antes de que se dispare la página de agradecimiento, un proveedor de pagos puede redirigir de forma distinta, o un cliente puede completar el pago en un flujo que el script del navegador nunca llega a ver.
Tercero, los eventos del backend pueden incluir datos que no deberían exponerse al navegador, como el estado del pedido, los totales de facturación, los IDs de plan, los márgenes, el estado de fraude o la etapa del ciclo de vida. El servidor puede enviar solo el subconjunto seguro para analítica.
Cuarto, el procesamiento del lado del servidor ofrece un filtro central. Se puede descartar el tráfico interno, eliminar query strings, normalizar los nombres de los eventos, bloquear propiedades sensibles, enrutar solo los eventos con consentimiento y evitar conversiones duplicadas entre navegador y servidor.
Quinto, el tracking del lado del servidor puede mejorar la atribución cuando conserva el contexto de campaña first-party y luego lo conecta con resultados verificados. No hace que todas las plataformas se pongan de acuerdo por arte de magia, pero puede hacer que el evento de negocio en sí sea más fiable.

Flowsery
Prueba gratuita
Panel en tiempo real
Seguimiento de objetivos
Rastreo sin cookies
Lo que no resuelve
El tracking del lado del servidor se vende por encima de lo que realmente ofrece. No hace que la analítica sea automáticamente conforme, exacta o imposible de bloquear.
No elimina las obligaciones de privacidad. La guía del ICO del Reino Unido sobre cookies y tecnologías similares indica que las normas pueden aplicarse a las cookies y a tecnologías de almacenamiento o acceso similares, no solo a archivos llamados "cookies". La Comisión de Protección de Datos de Irlanda señala de forma similar que normalmente se requiere consentimiento para cookies o tecnologías similares, salvo que aplique una excepción. Si una configuración del lado del servidor sigue almacenando identificadores en el dispositivo, lee identificadores, hace fingerprinting, envía datos personales a destinos publicitarios o ignora las elecciones del usuario, mover la lógica al backend no arregla el problema legal.
No hace que los logs del servidor equivalgan a personas. Un servidor ve crawlers, monitores de uptime, bots de vista previa de enlaces, crawlers de IA, reintentos, peticiones de assets, prefetches, peticiones cacheadas y ataques. El recuento bruto de peticiones no son sesiones humanas a menos que se clasifiquen y filtren con cuidado.
No conserva el contexto del navegador por defecto. Cuando el navegador no envía el referrer, los parámetros UTM, el user agent, el viewport, el idioma o los identificadores de sesión al backend, un evento generado solo en el servidor puede ser exacto pero estar mal atribuido.
No hace que todas las plataformas de analítica interpreten los eventos de la misma forma. Cada producto tiene su propio modelo de identidad, modelo de sesión, filtrado de bots, ventana de atribución, reglas de deduplicación y unidad de precio.
Tracking del lado del servidor frente al tracking del lado del cliente
Usa tracking del lado del cliente cuando el evento trata sobre la experiencia del visitante en el navegador:
- Page views y cambios de ruta del lado del cliente
- Contexto de aterrizaje de campaña
- Referrers y UTMs capturados en la página de aterrizaje
- Clics, inicios de formulario, profundidad de scroll, enlaces salientes y descargas
- Contexto de navegador, dispositivo, viewport e idioma
- Session replay y comportamiento de la interfaz
Usa tracking del lado del servidor cuando el evento es un hecho verificado del backend:
- Cuenta creada
- Lead aceptado o calificado
- Checkout completado
- Suscripción renovada, mejorada, degradada o cancelada
- Factura pagada o reembolsada
- Archivo entregado por un endpoint autenticado
- Acción de API completada
- Resultado de un job en segundo plano o de un webhook
Usa ambos cuando la decisión abarca tanto el comportamiento en el navegador como el resultado de negocio. Por ejemplo, una visita a la página de precios es un evento de navegador, mientras que una suscripción pagada es un evento de backend. El trabajo de analítica consiste en conectarlos sin recopilar más datos personales de los que la decisión requiere.
Comparación de plataformas para el seguimiento del lado del servidor
| Plataforma | Soporte de seguimiento del lado del servidor verificado | Mejor uso en el lado del servidor | Ten cuidado con |
|---|---|---|---|
| Flowsery | Endpoints de API para objetivos y pagos, objetivos personalizados, API de pagos, configuración de proxy y guía de atribución de ingresos del lado del servidor | Análisis de sitios web centrado en la privacidad, embudos, objetivos personalizados y atribución de ingresos | Haz coincidir el ID de visitante y el ID de transacción de forma deliberada |
| Plausible | API de eventos para páginas vistas y eventos personalizados, documentada como útil para el seguimiento del lado del servidor | Eventos ligeros y envíos de páginas o eventos desde móvil o backend | El manejo de encabezados es clave para el conteo de visitantes únicos |
| Fathom | La referencia de la API incluye seguimiento de eventos | Eventos y objetivos de analítica alojada simple | Menos adecuado para análisis de producto profundos |
| Simple Analytics | Envíos de eventos y páginas vistas del lado del servidor a su endpoint de eventos | Informes agregados centrados en la privacidad desde fuentes de backend o móvil | Evita user agents de librerías de peticiones que parezcan bots |
| Pirsch | Integración del lado del servidor, API, SDK, eventos, objetivos de conversión, embudos | Analítica web alojada en la UE con eventos de backend y APIs pensadas para agencias | Revisa el modelo de hash de datos de la petición con el equipo legal |
| Matomo | API de seguimiento HTTP y rutas de SDK del lado del servidor | Analítica autoalojada o en la nube con control amplio | Más configuración y análisis de consentimiento |
| Umami | Guía de eventos del lado del servidor, cliente Node, /api/send y endpoint por lotes | Eventos autoalojados o en la nube desde webhooks, tareas programadas, APIs y cargas retroactivas | Conserva el user agent y el contexto de atribución cuando sea necesario |
| Seline | Los eventos personalizados están disponibles en cliente y servidor; los eventos de servidor requieren un ID de usuario conocido | Recorridos al estilo SaaS, perfiles, ingresos y eventos personalizados idempotentes | Los eventos de servidor dependen de la configuración del perfil o usuario |
| DataFast | La API puede crear objetivos personalizados en el servidor; la documentación recomienda el seguimiento de ingresos del lado del servidor para mayor precisión | Atribución de ingresos y seguimiento de objetivos amigable para makers | Algunos flujos de atribución aún dependen de la coincidencia de visitantes |
| PostHog | Librerías del lado del servidor para Node.js, Python, Java, PHP, Ruby, C#/.NET y APIs de eventos | Analítica de producto, feature flags, experimentos, replay y eventos de backend | Más potencia implica más gobernanza y controles de costo |
| Mixpanel | API de ingesta /track y SDK del lado del servidor | Analítica de eventos madura, embudos, cohortes, retención | Requiere una taxonomía de eventos sólida y disciplina de identidad |
| Heap | API de seguimiento del lado del servidor para eventos personalizados vinculados a usuarios | Analítica de producto con captura automática más eventos de backend verificados | Los eventos de servidor están vinculados a usuarios identificados y pueden no agruparse en sesiones como los eventos web |
1. Flowsery
Flowsery es la primera plataforma que conviene evaluar si buscas analítica web, embudos, objetivos, recorridos de usuario, atribución de ingresos, eventos personalizados y seguimiento centrado en la privacidad en un solo panel.
La página de precios de Flowsery actual muestra un plan de $500/mes tras una prueba gratuita de 14 días, con seguimiento de ingresos, análisis de embudos, acceso a la API, seguimiento sin cookies, exportación completa, sin muestreo de datos y sitios web ilimitados. La documentación también describe objetivos personalizados, una API de Flowsery Analytics, creación de objetivos, creación de pagos, configuración de proxy y una opción data-disable-payments para equipos que usan atribución de ingresos del lado del servidor y quieren evitar eventos de pago duplicados.
Flowsery encaja bien con el seguimiento del lado del servidor cuando el objetivo no es levantar un enorme stack de datos, sino conectar las fuentes de tráfico con resultados reales. Por ejemplo, puedes usar seguimiento del lado del navegador para landing pages y contexto de origen, y luego enviar objetivos o eventos de pago verificados desde el backend cuando el servidor confirma que un registro o una compra realmente ocurrió.
Elige Flowsery cuando:
- Quieras que Flowsery sea la primera opción de tu lista corta para analítica web centrada en la privacidad.
- Necesites fuentes, campañas, objetivos, embudos, recorridos, ingresos y acceso a la API en un solo lugar.
- Quieras eventos de negocio confirmados por el servidor sin convertir tu analítica web en un almacén de telemetría de producto.
- Te importe minimizar cookies, huellas digitales y perfiles personales.
Ten en cuenta:
- Si envías eventos de pago tanto desde el navegador como desde el backend, diseña la deduplicación en torno a IDs de transacción estables.
- Si el autoalojamiento es obligatorio, compara Matomo, Umami u otro stack autoalojado.
2. Plausible
Flowsery
Prueba gratuita
Panel en tiempo real
Seguimiento de objetivos
Rastreo sin cookies
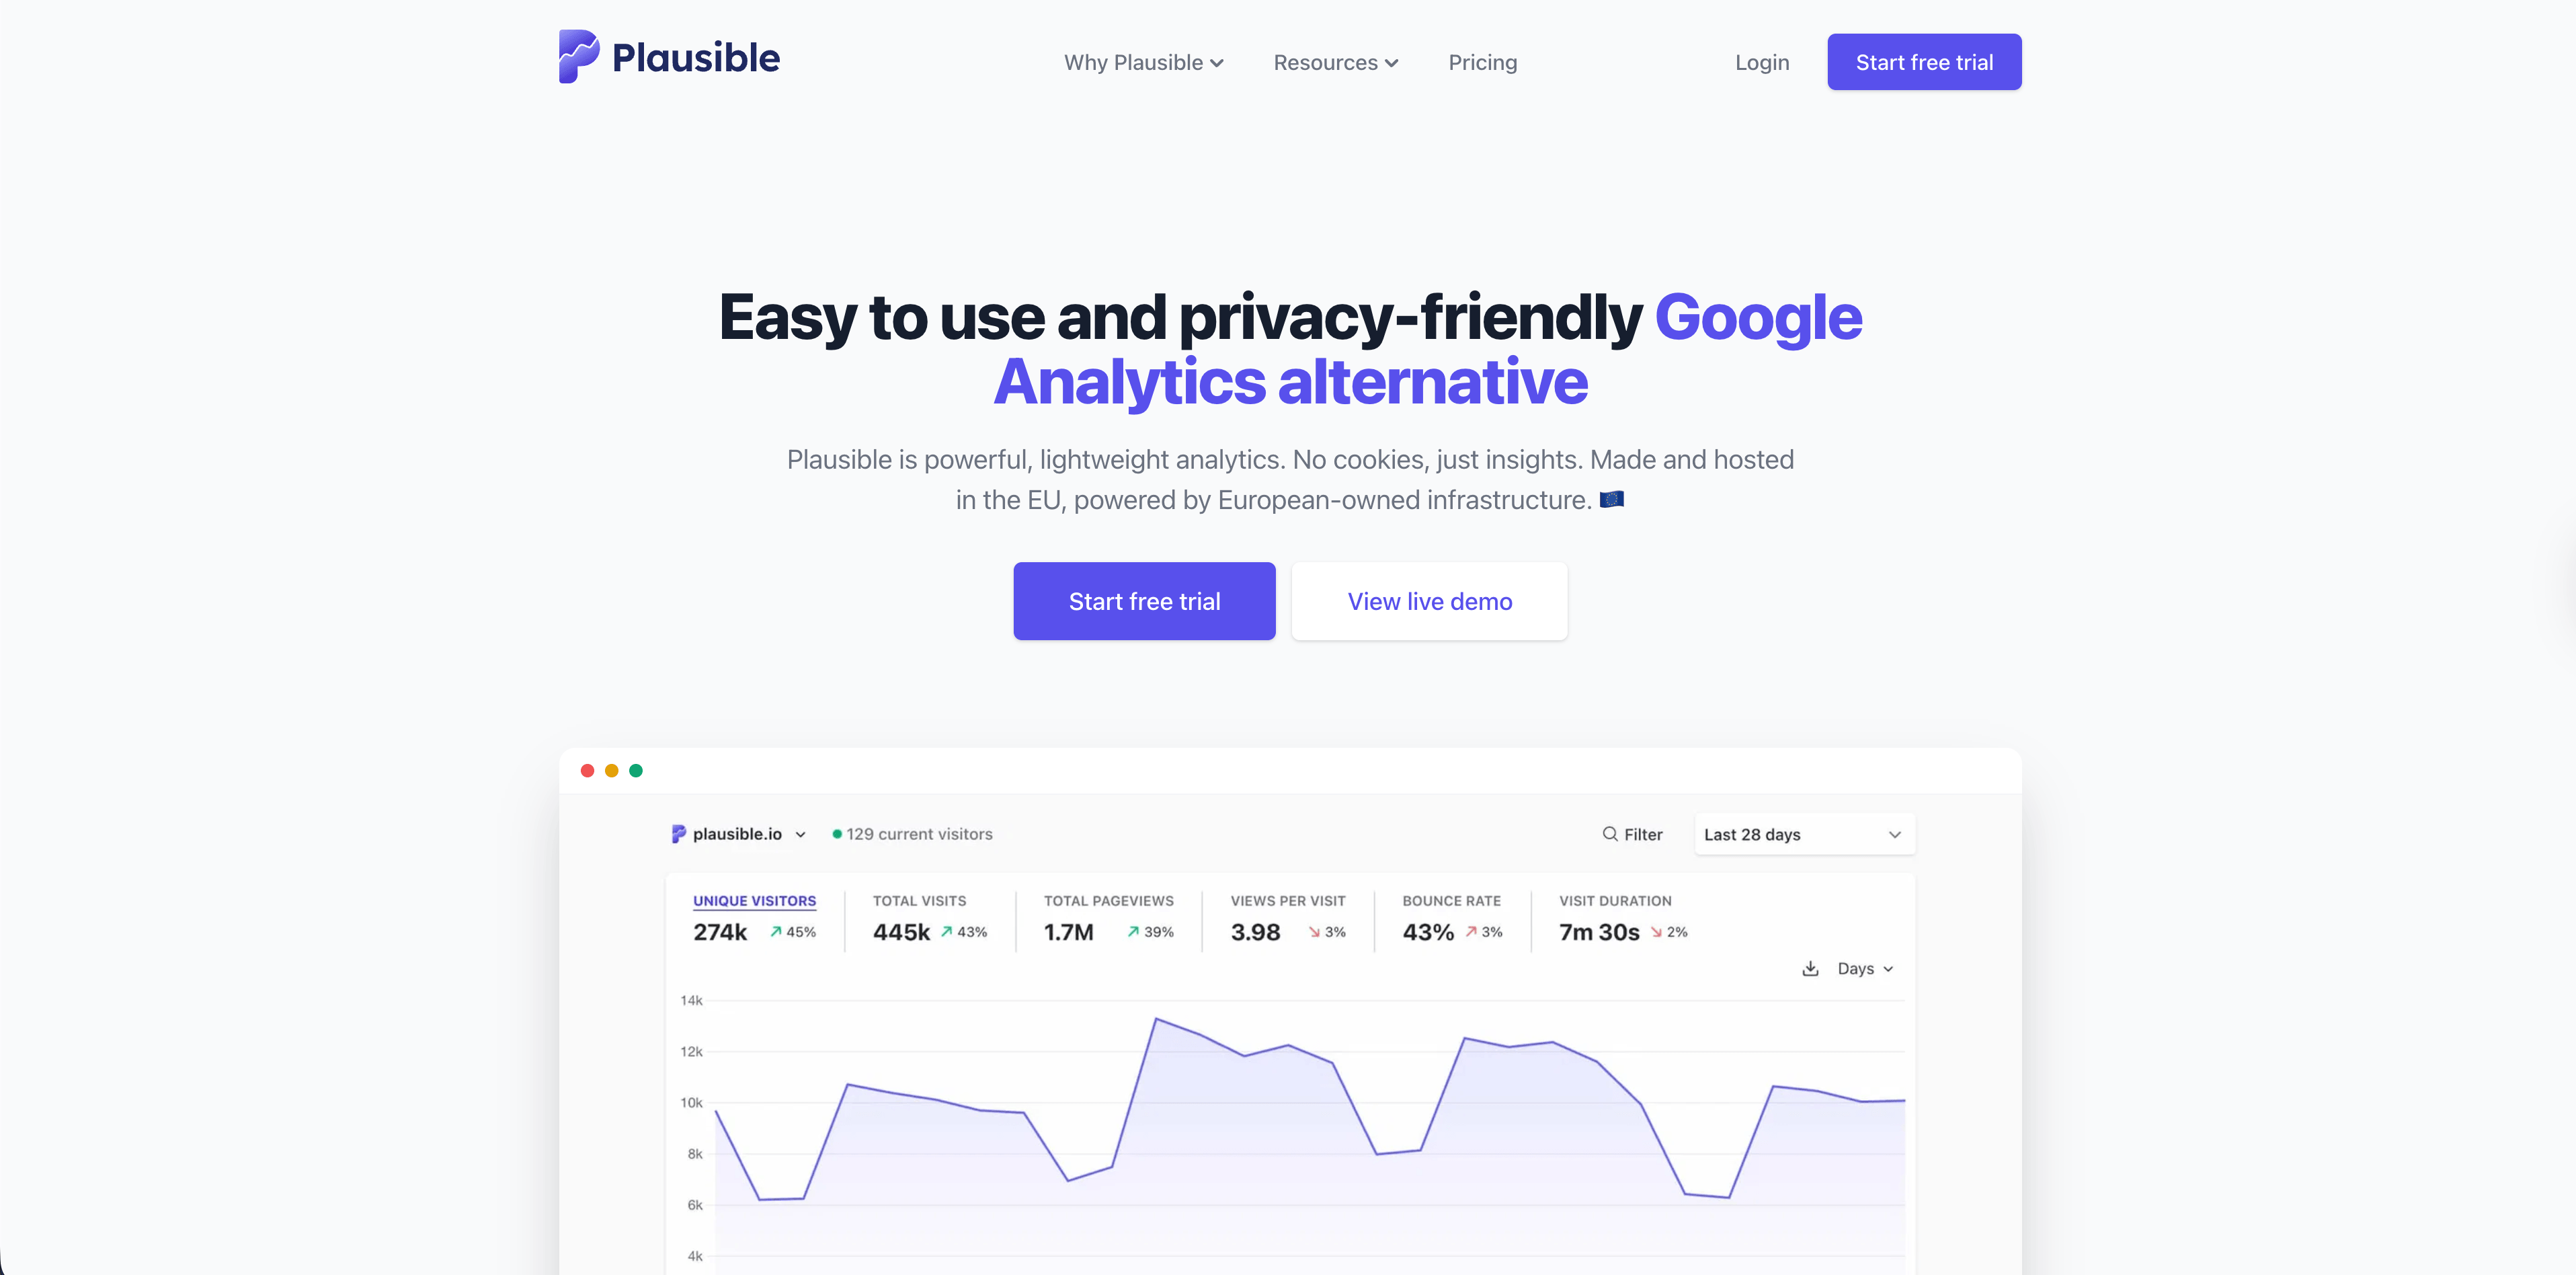
Plausible documenta una API de eventos para registrar páginas vistas y eventos personalizados. La documentación la describe explícitamente como útil para apps móviles o seguimiento del lado del servidor, aunque sigue recomendando el script estándar para la mayoría de los sitios web.
Plausible es una buena opción cuando quieres un panel sencillo y respetuoso con la privacidad, y solo necesitas algunos eventos seleccionados desde el backend. Encaja de forma natural para páginas vistas, objetivos, conversiones y envíos ligeros de eventos personalizados.
Presta atención a las cabeceras. La documentación de Plausible señala User-Agent y X-Forwarded-For como importantes para el conteo de visitantes únicos. Si tu backend envía cabeceras genéricas de librería de peticiones o IPs de proxy, el evento puede aceptarse pero contarse de una forma que no corresponde con la realidad del visitante.
3. Fathom
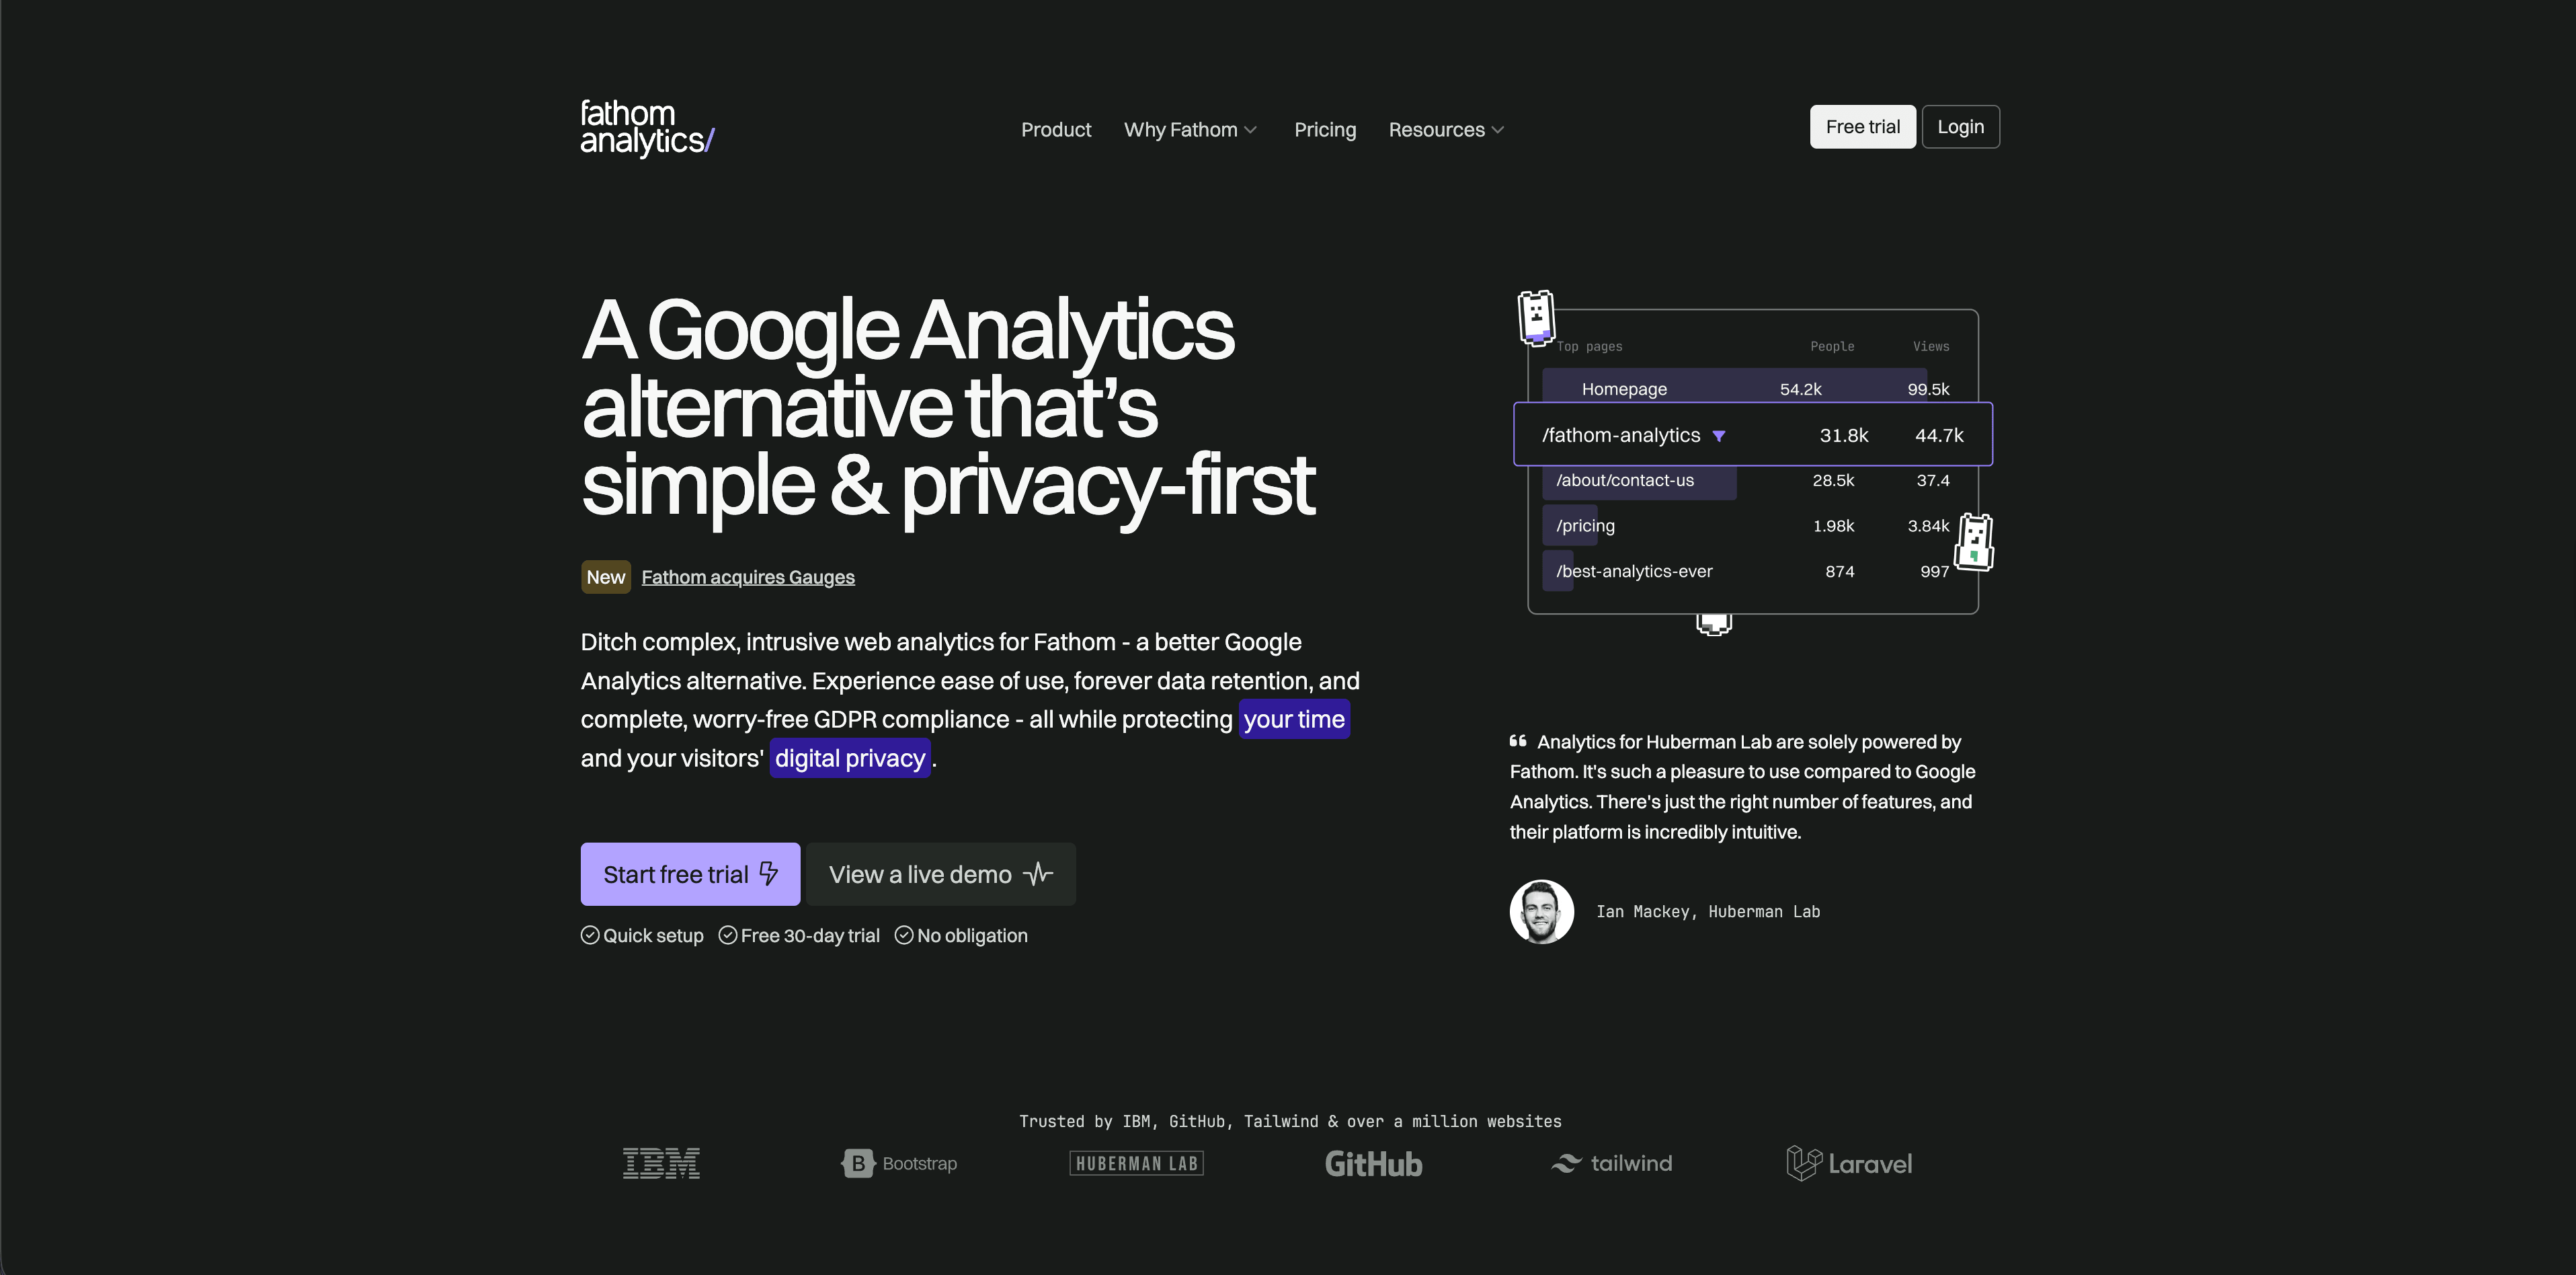
Fathom Analytics es un producto de analítica alojado y sencillo, con una referencia de API que incluye seguimiento de eventos. Se entiende mejor como un producto de analítica web limpio que puede recibir datos de eventos importantes, no como un almacén amplio de instrumentación de producto.
Fathom encaja con equipos que quieren un panel alojado de bajo mantenimiento y solo unos pocos eventos de backend de alto valor. Resulta especialmente atractivo para agencias, pequeñas empresas, creadores y sitios de marketing SaaS donde la superficie de informes debe mantenerse legible.
Presta atención al alcance. Si el plan del lado del servidor incluye cohortes, retención, cruces con un data warehouse, feature flags y decenas de eventos de producto, Fathom probablemente no sea el sistema principal.
4. Simple Analytics
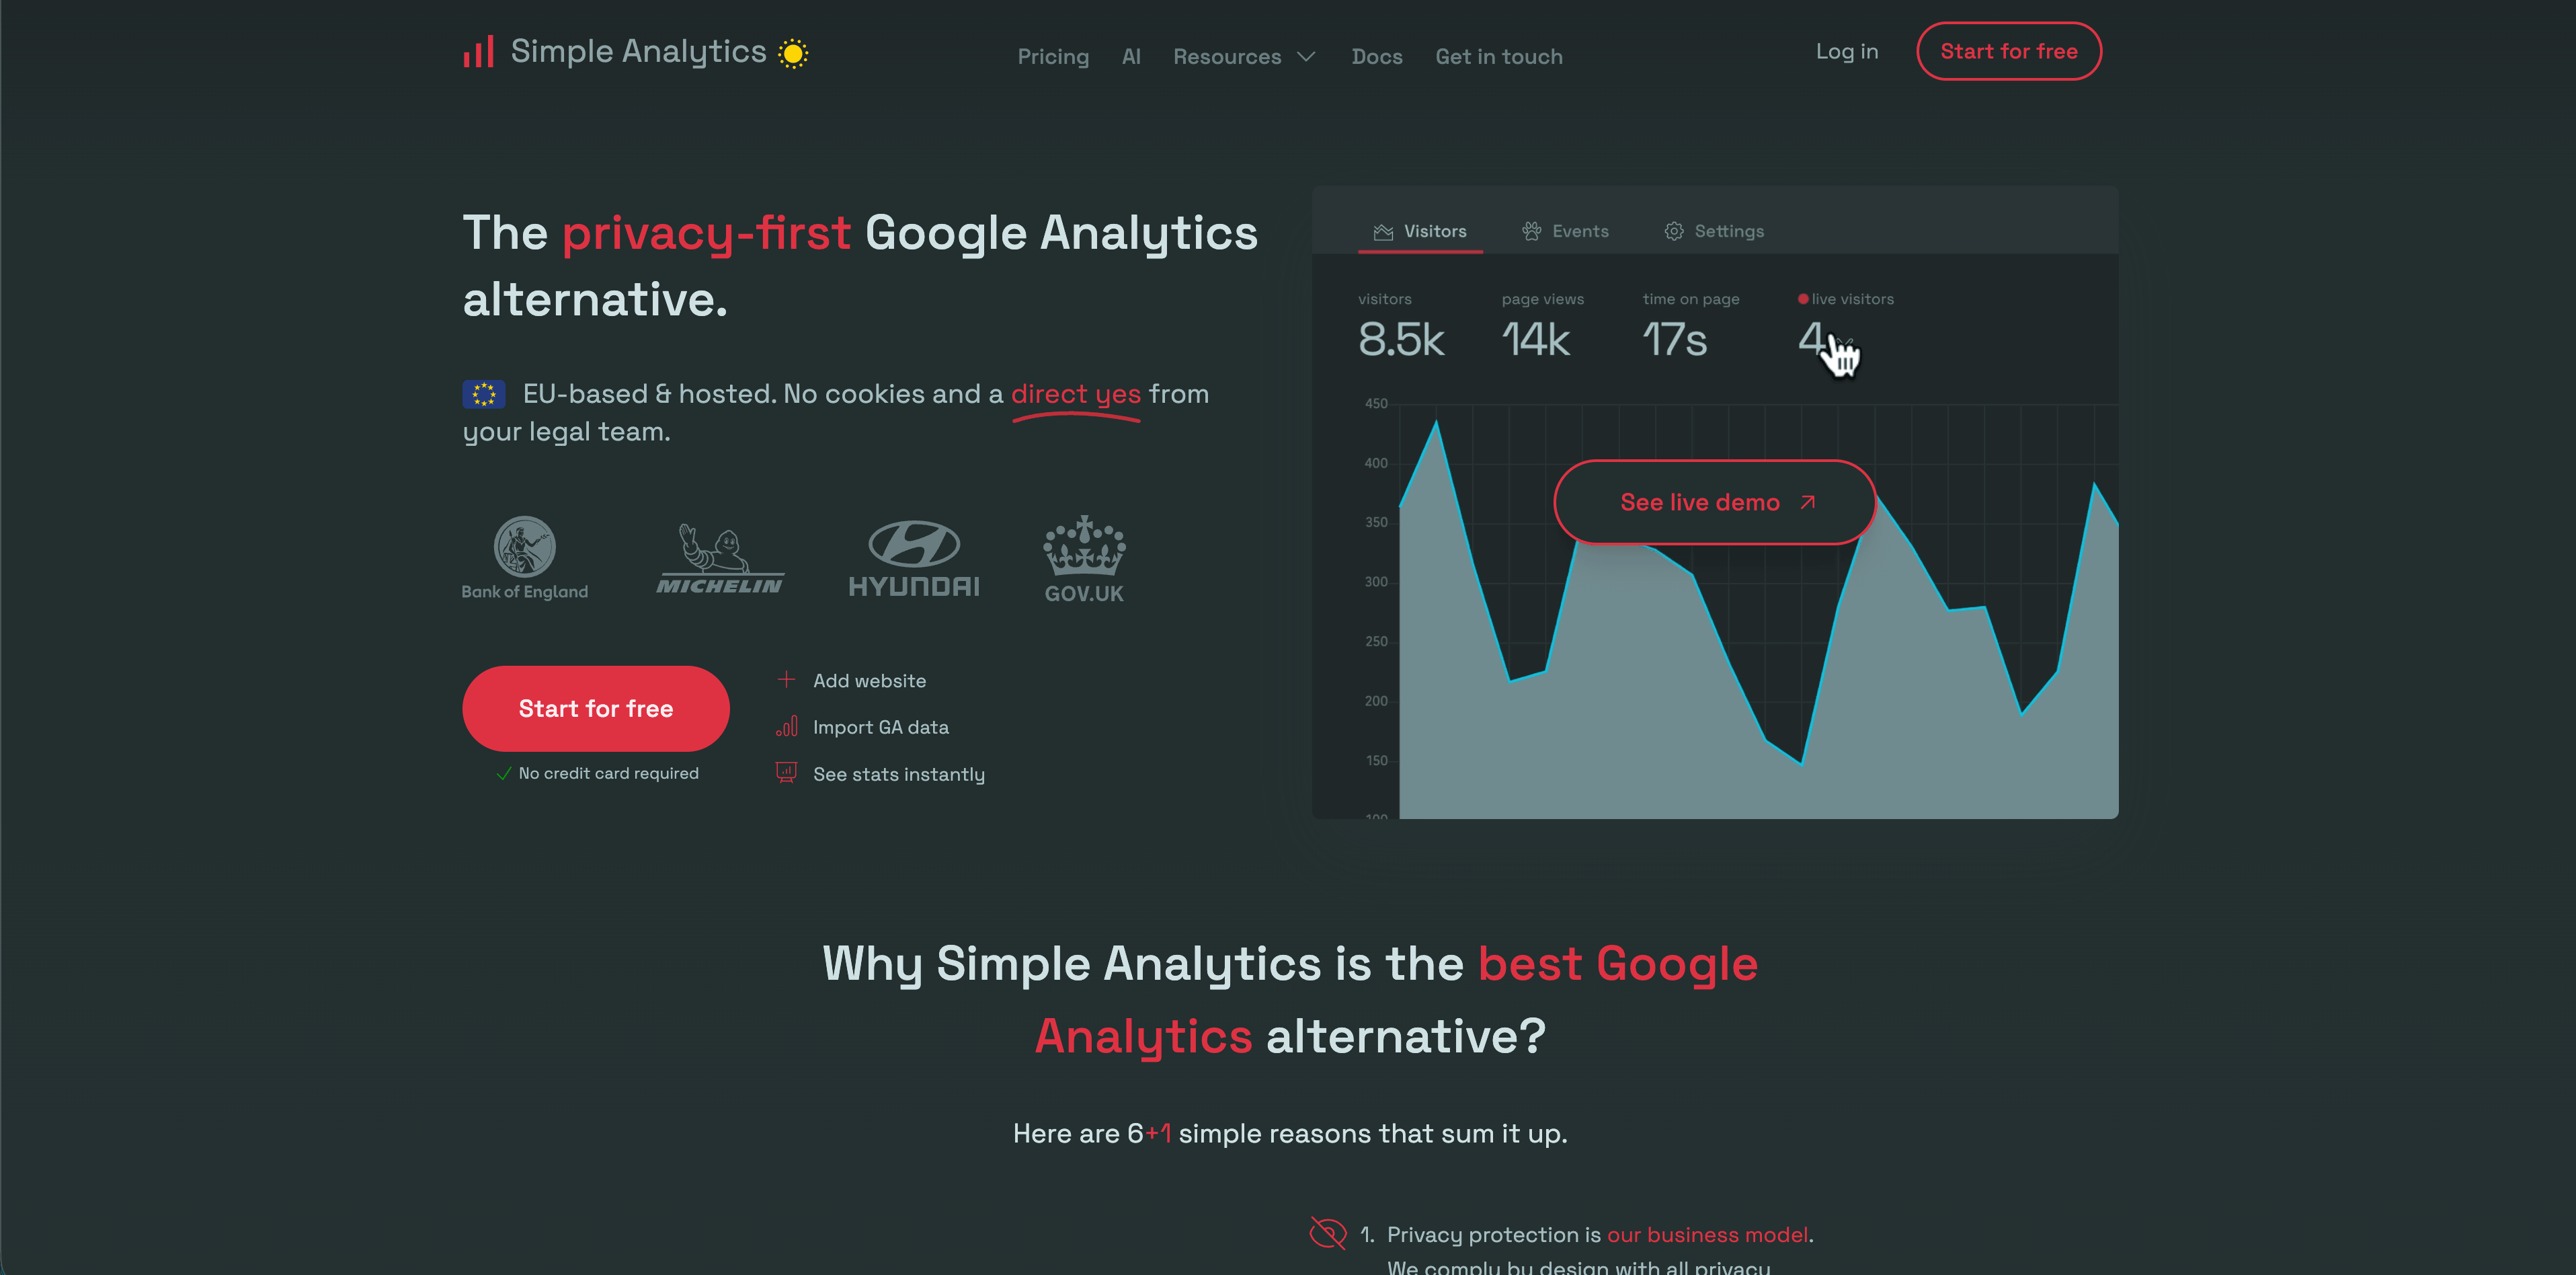
Simple Analytics tiene documentación dedicada del lado del servidor para el envío de eventos y páginas vistas. Los desarrolladores pueden enviar JSON a su endpoint de eventos, añadir metadatos y luego analizar los eventos en el panel o en el Events Explorer.
La plataforma es más sólida cuando quieres informes agregados con una postura de privacidad estricta. Los eventos del lado del servidor pueden cubrir fuentes móviles, de backend y ajenas al navegador sin abandonar la filosofía de analítica mínima del producto.
Presta atención al user agent. Simple Analytics advierte contra los user agents predeterminados de las librerías de peticiones, que pueden parecer bots. Es un recordatorio útil para cualquier configuración del lado del servidor: los eventos de backend siguen necesitando suficiente contexto de la petición para interpretarse correctamente.
5. Pirsch
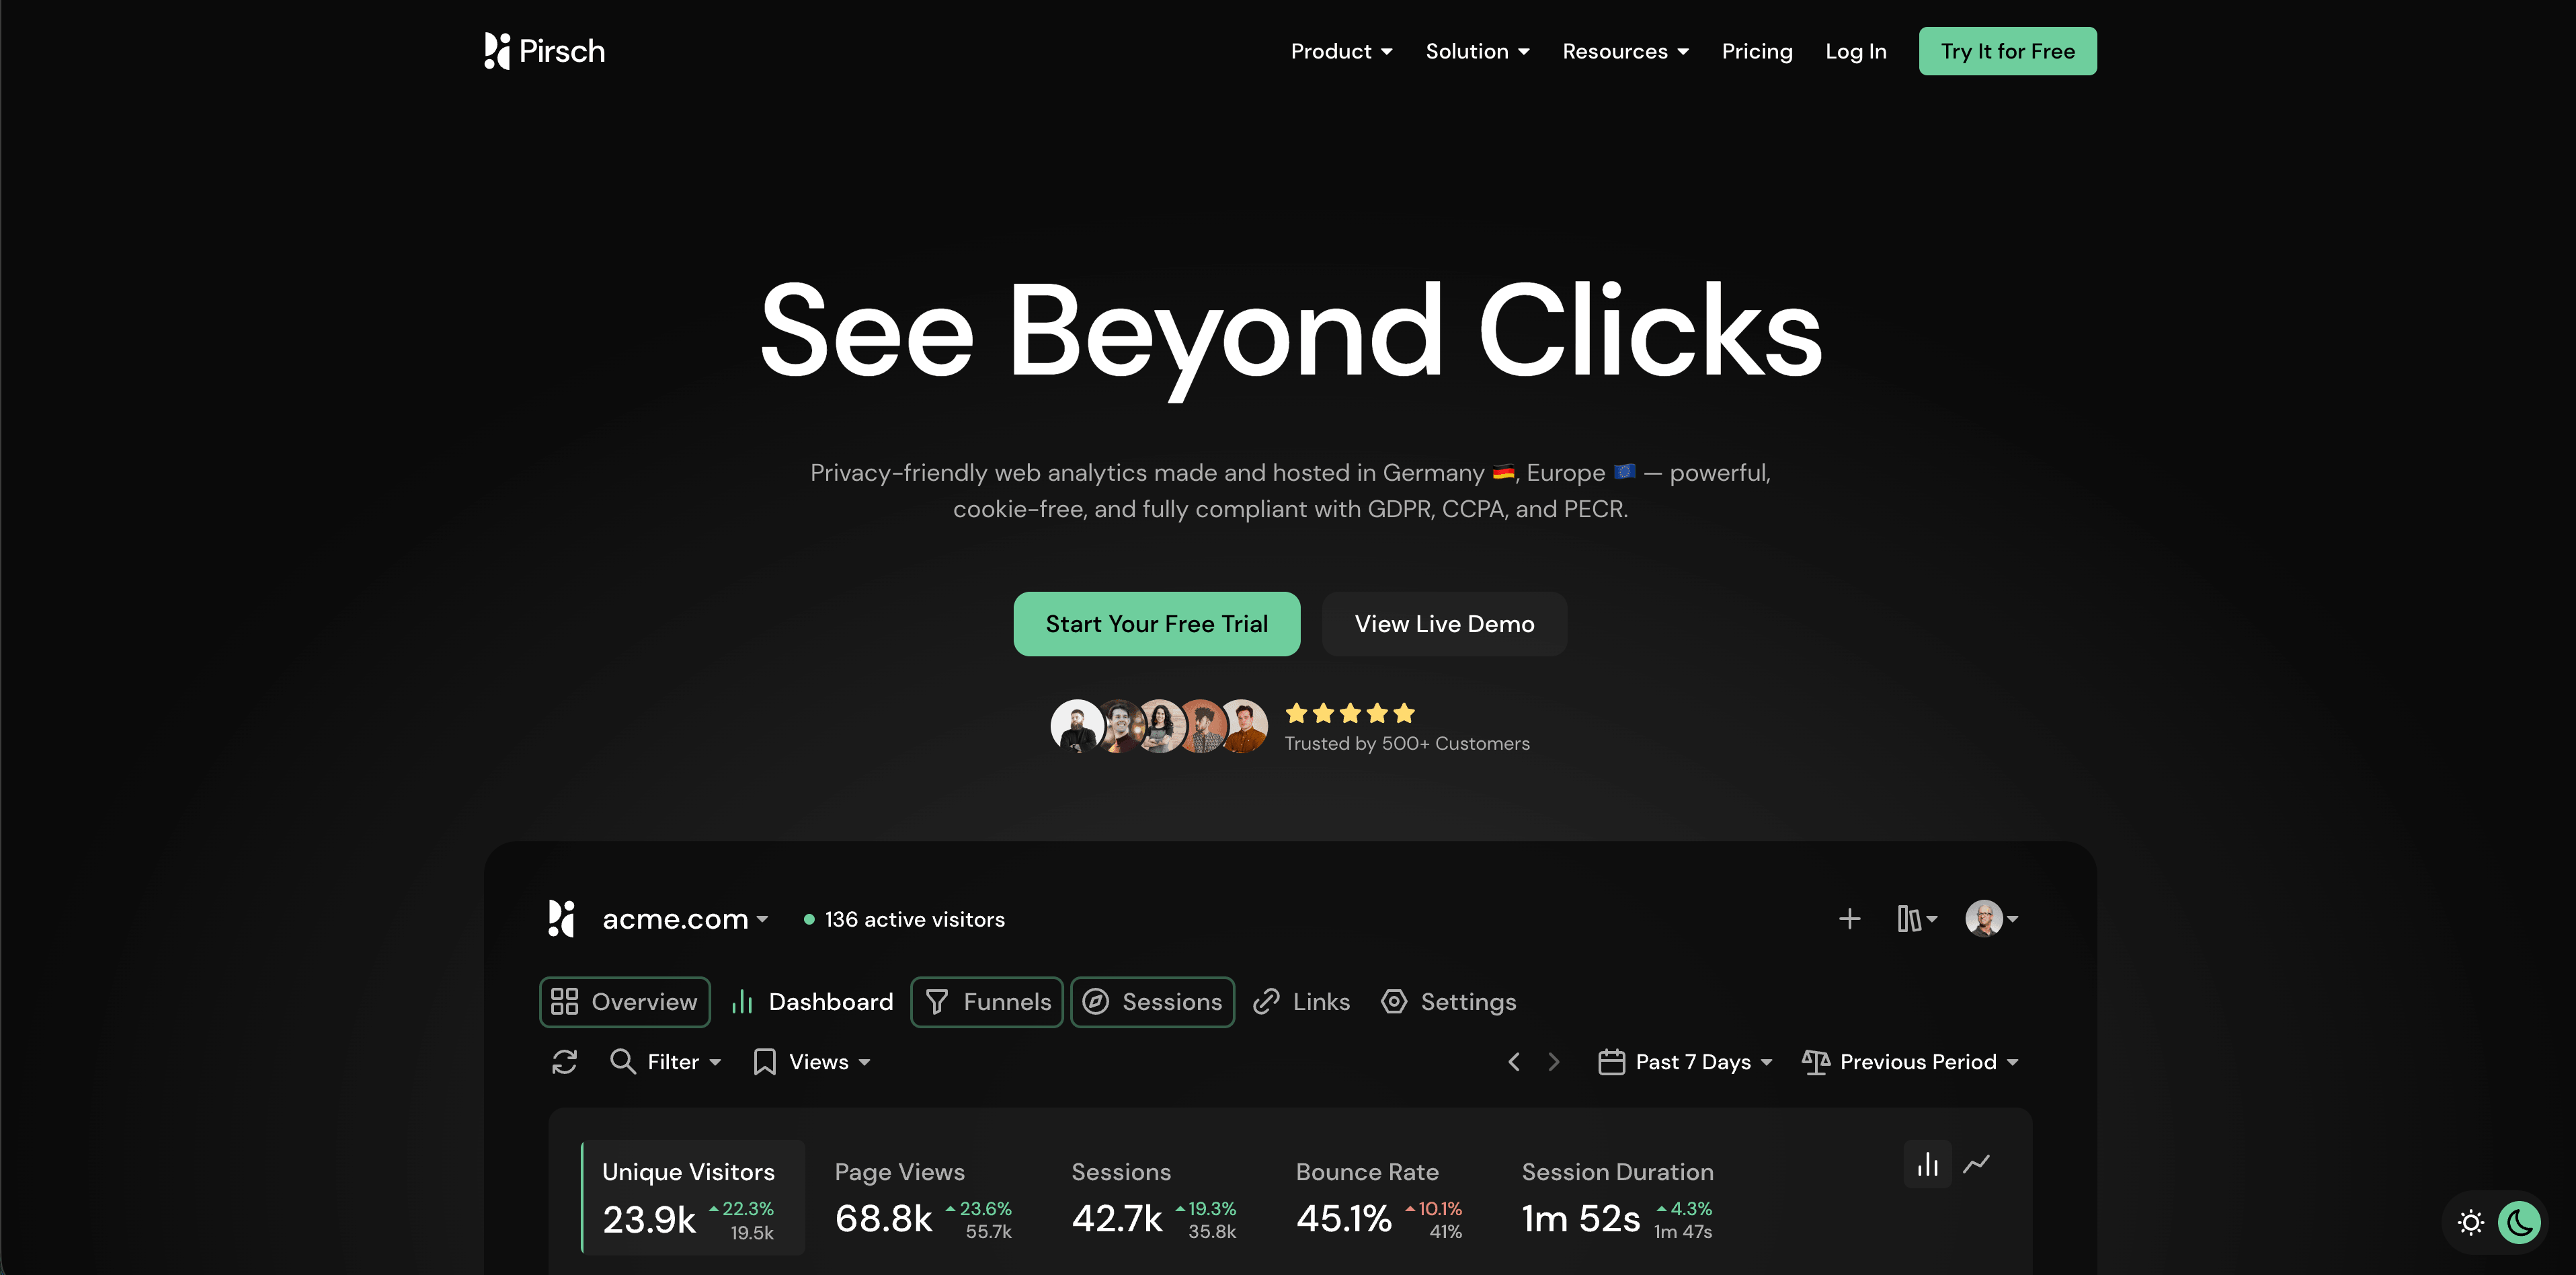
Pirsch documenta la integración del lado del servidor, API y SDKs, eventos, objetivos de conversión, segmentación, pruebas A/B, embudos multietapa, integración de dashboard y proxying. Su documentación de eventos indica que los eventos pueden enviarse desde el sitio web usando JavaScript o desde el backend usando la API o los SDKs.
Pirsch es adecuado para agencias, desarrolladores y equipos preocupados por la privacidad que necesitan más configurabilidad que las herramientas más minimalistas. El acceso a la API, los SDKs, los dominios personalizados, los equipos, el white labeling y el alojamiento en Alemania lo convierten en una opción técnica sólida.
Presta atención al modelo de privacidad. Pirsch no usa cookies, pero su documentación y sus preguntas frecuentes describen un reconocimiento anonimizado de visitantes basado en datos de la solicitud. Eso puede ser adecuado para tu configuración, pero la revisión legal debería centrarse en los campos concretos, el hashing, la retención y la finalidad, no solo en la palabra "sin cookies".
Flowsery
Prueba gratuita
Panel en tiempo real
Seguimiento de objetivos
Rastreo sin cookies
6. Matomo
Matomo cuenta con una API HTTP de seguimiento de larga trayectoria y referencias de API para desarrolladores en seguimiento, informes, Java, PHP y otras vías de implementación. Puede usarse en configuraciones en la nube o autoalojadas, y es una de las plataformas de analítica web tradicional más completas.
Matomo es adecuado para equipos que necesitan propiedad de los datos, autoalojamiento, analítica de ecommerce, dimensiones personalizadas, objetivos, segmentos e informes maduros. El seguimiento del lado del servidor puede implementarse directamente mediante APIs o mediante infraestructura que envía hits a Matomo.
Presta atención a la complejidad. Matomo ofrece muchos controles, y cada control cambia la privacidad, el consentimiento, la retención, la calidad de los datos y el mantenimiento. El poder es real, pero también lo es el trabajo operativo.
7. Umami
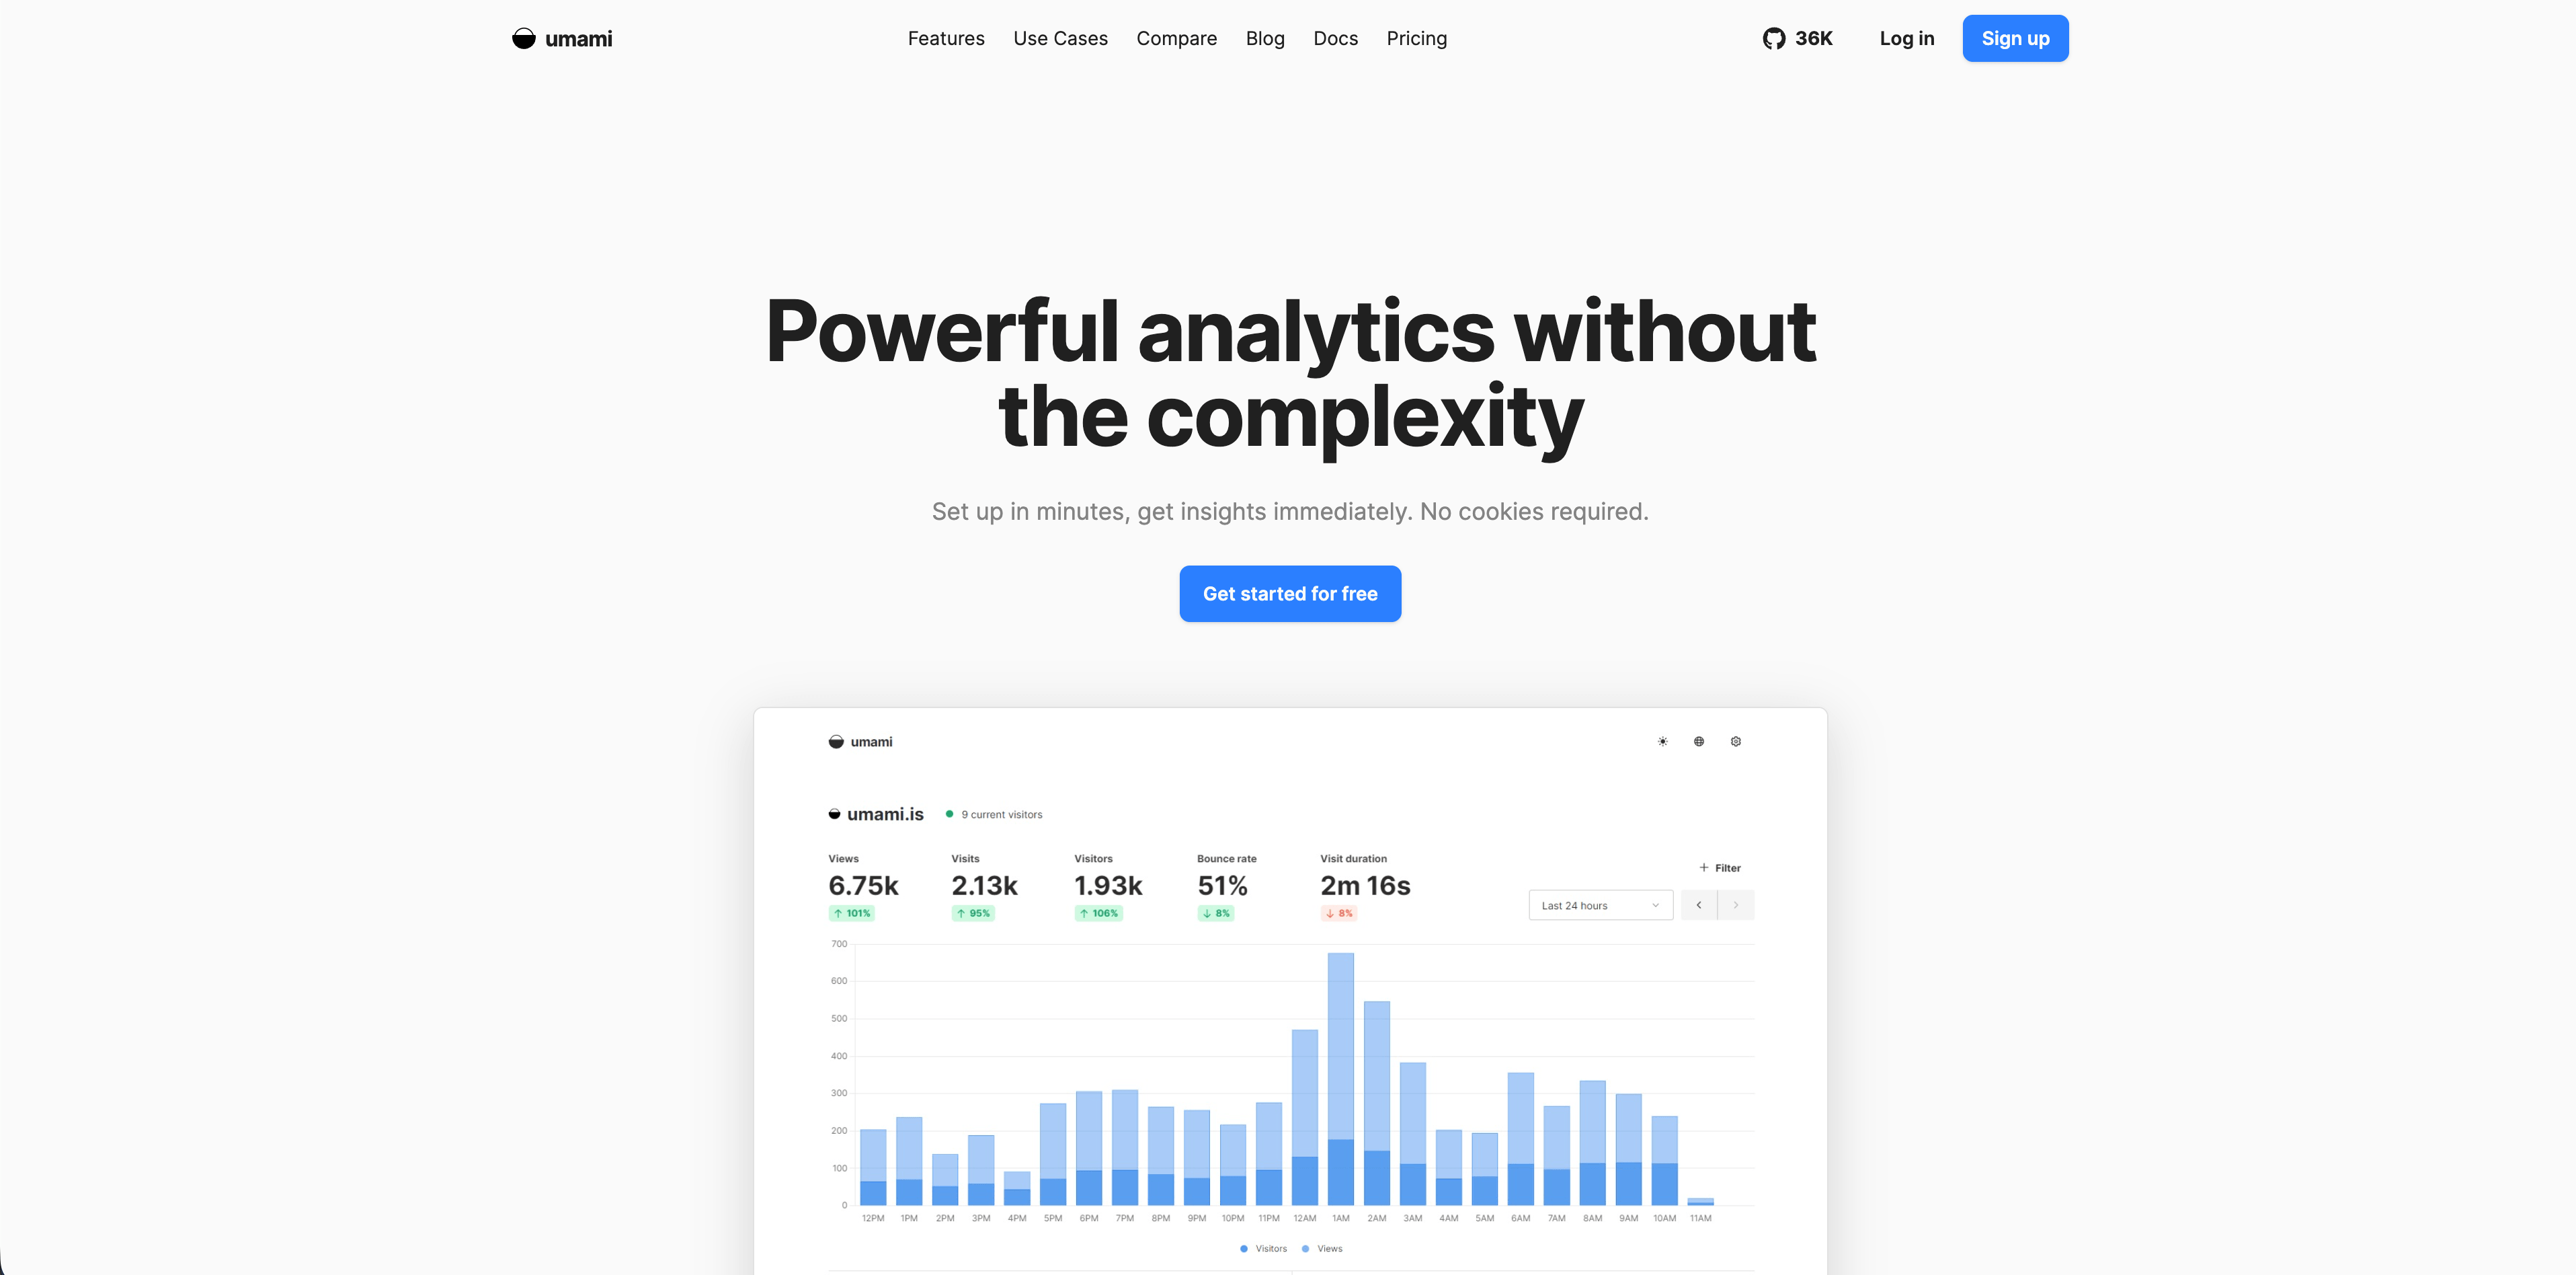
Umami publica una guía de eventos del lado del servidor para servicios backend. La documentación describe el uso del cliente Node o del endpoint /api/send para webhooks de pago, acciones de API, tareas en segundo plano e importaciones históricas. También menciona un endpoint por lotes para cargas masivas de alto volumen.
Umami es adecuado para equipos liderados por desarrolladores que buscan una analítica sencilla con autoalojamiento o nube gestionada. Los eventos del lado del servidor son útiles cuando un pago, una tarea en segundo plano o una acción de API necesitan aparecer en la misma superficie de analítica que los datos del sitio web.
Presta atención al contexto de atribución. Si el evento del backend está desconectado de la visita original del navegador, puedes obtener un evento correcto pero difícil de atribuir a una campaña, página de destino o referente.
8. Seline
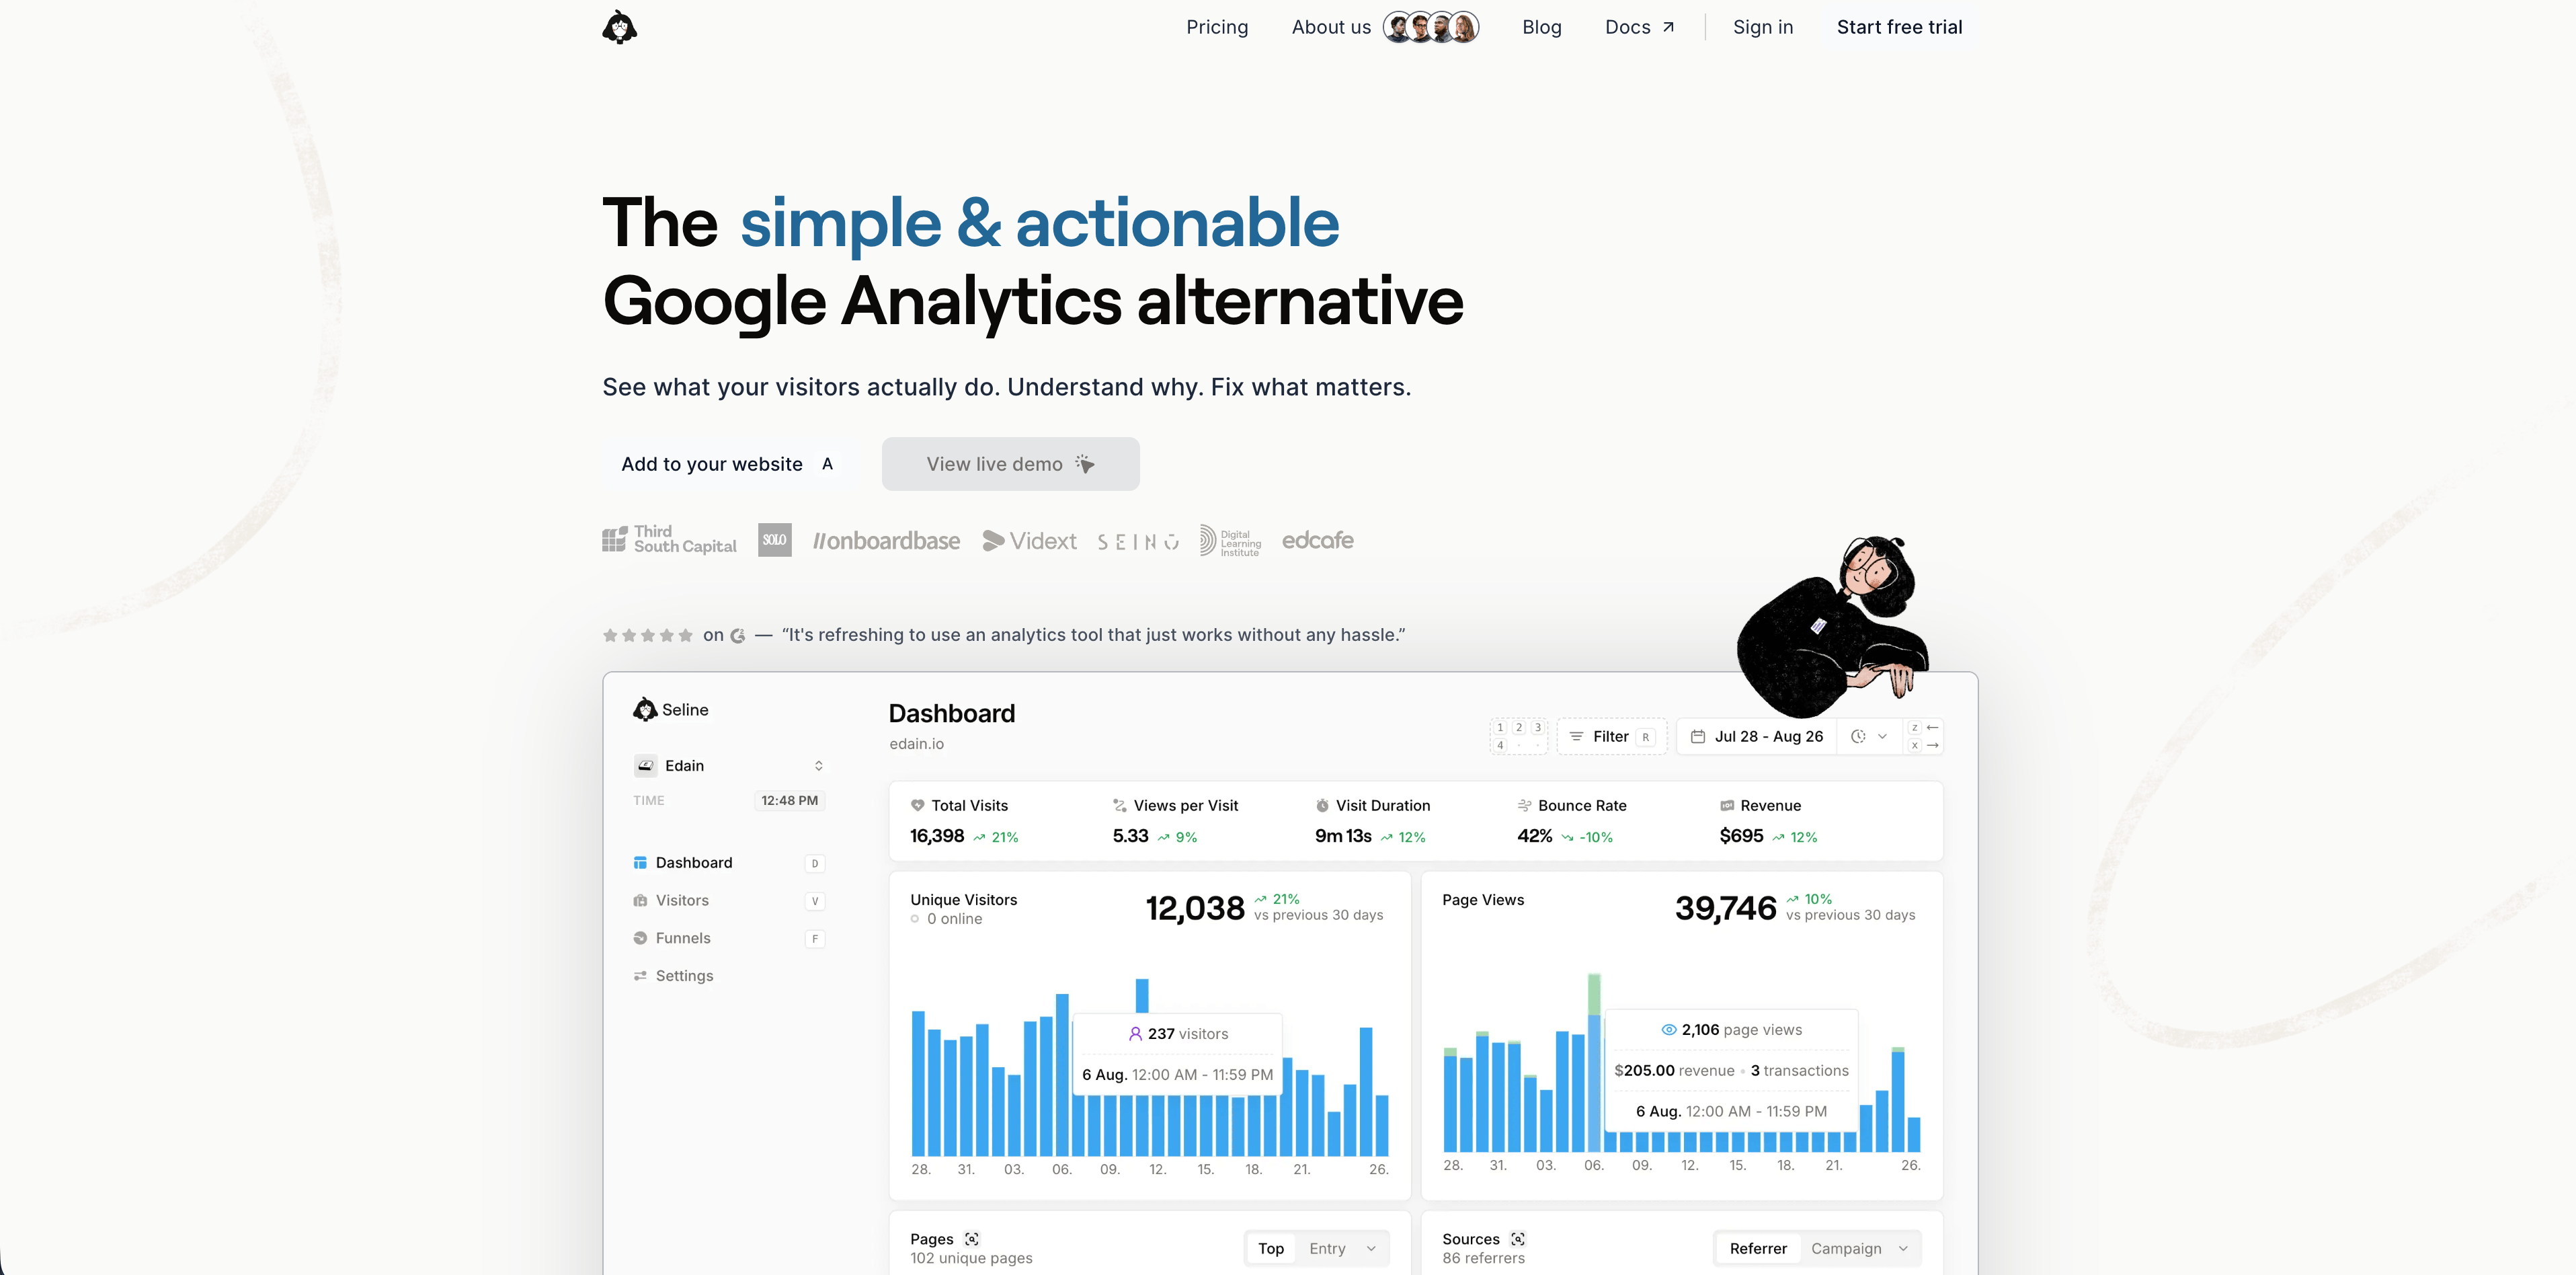
Seline indica que los eventos personalizados están disponibles tanto en el cliente como en el servidor. Su documentación recomienda nombres de evento cortos, admite propiedades personalizadas y requiere un ID de usuario único para los eventos enviados desde el servidor. La misma documentación describe la idempotencia mediante insertId para evitar eventos duplicados.
Seline es adecuado para equipos de SaaS y ecommerce que buscan recorridos, perfiles, embudos, ingresos y atribución más ricos que un panel minimalista de vistas de página. Los eventos del servidor tienen sentido para registros, suscripciones y acciones de ingresos vinculadas a usuarios conocidos.
Presta atención a la configuración de identidad. Si el evento del servidor requiere un ID de usuario conocido, la atribución de marketing anónima necesita un traspaso deliberado desde la visita de destino hasta la cuenta o el checkout.
9. DataFast
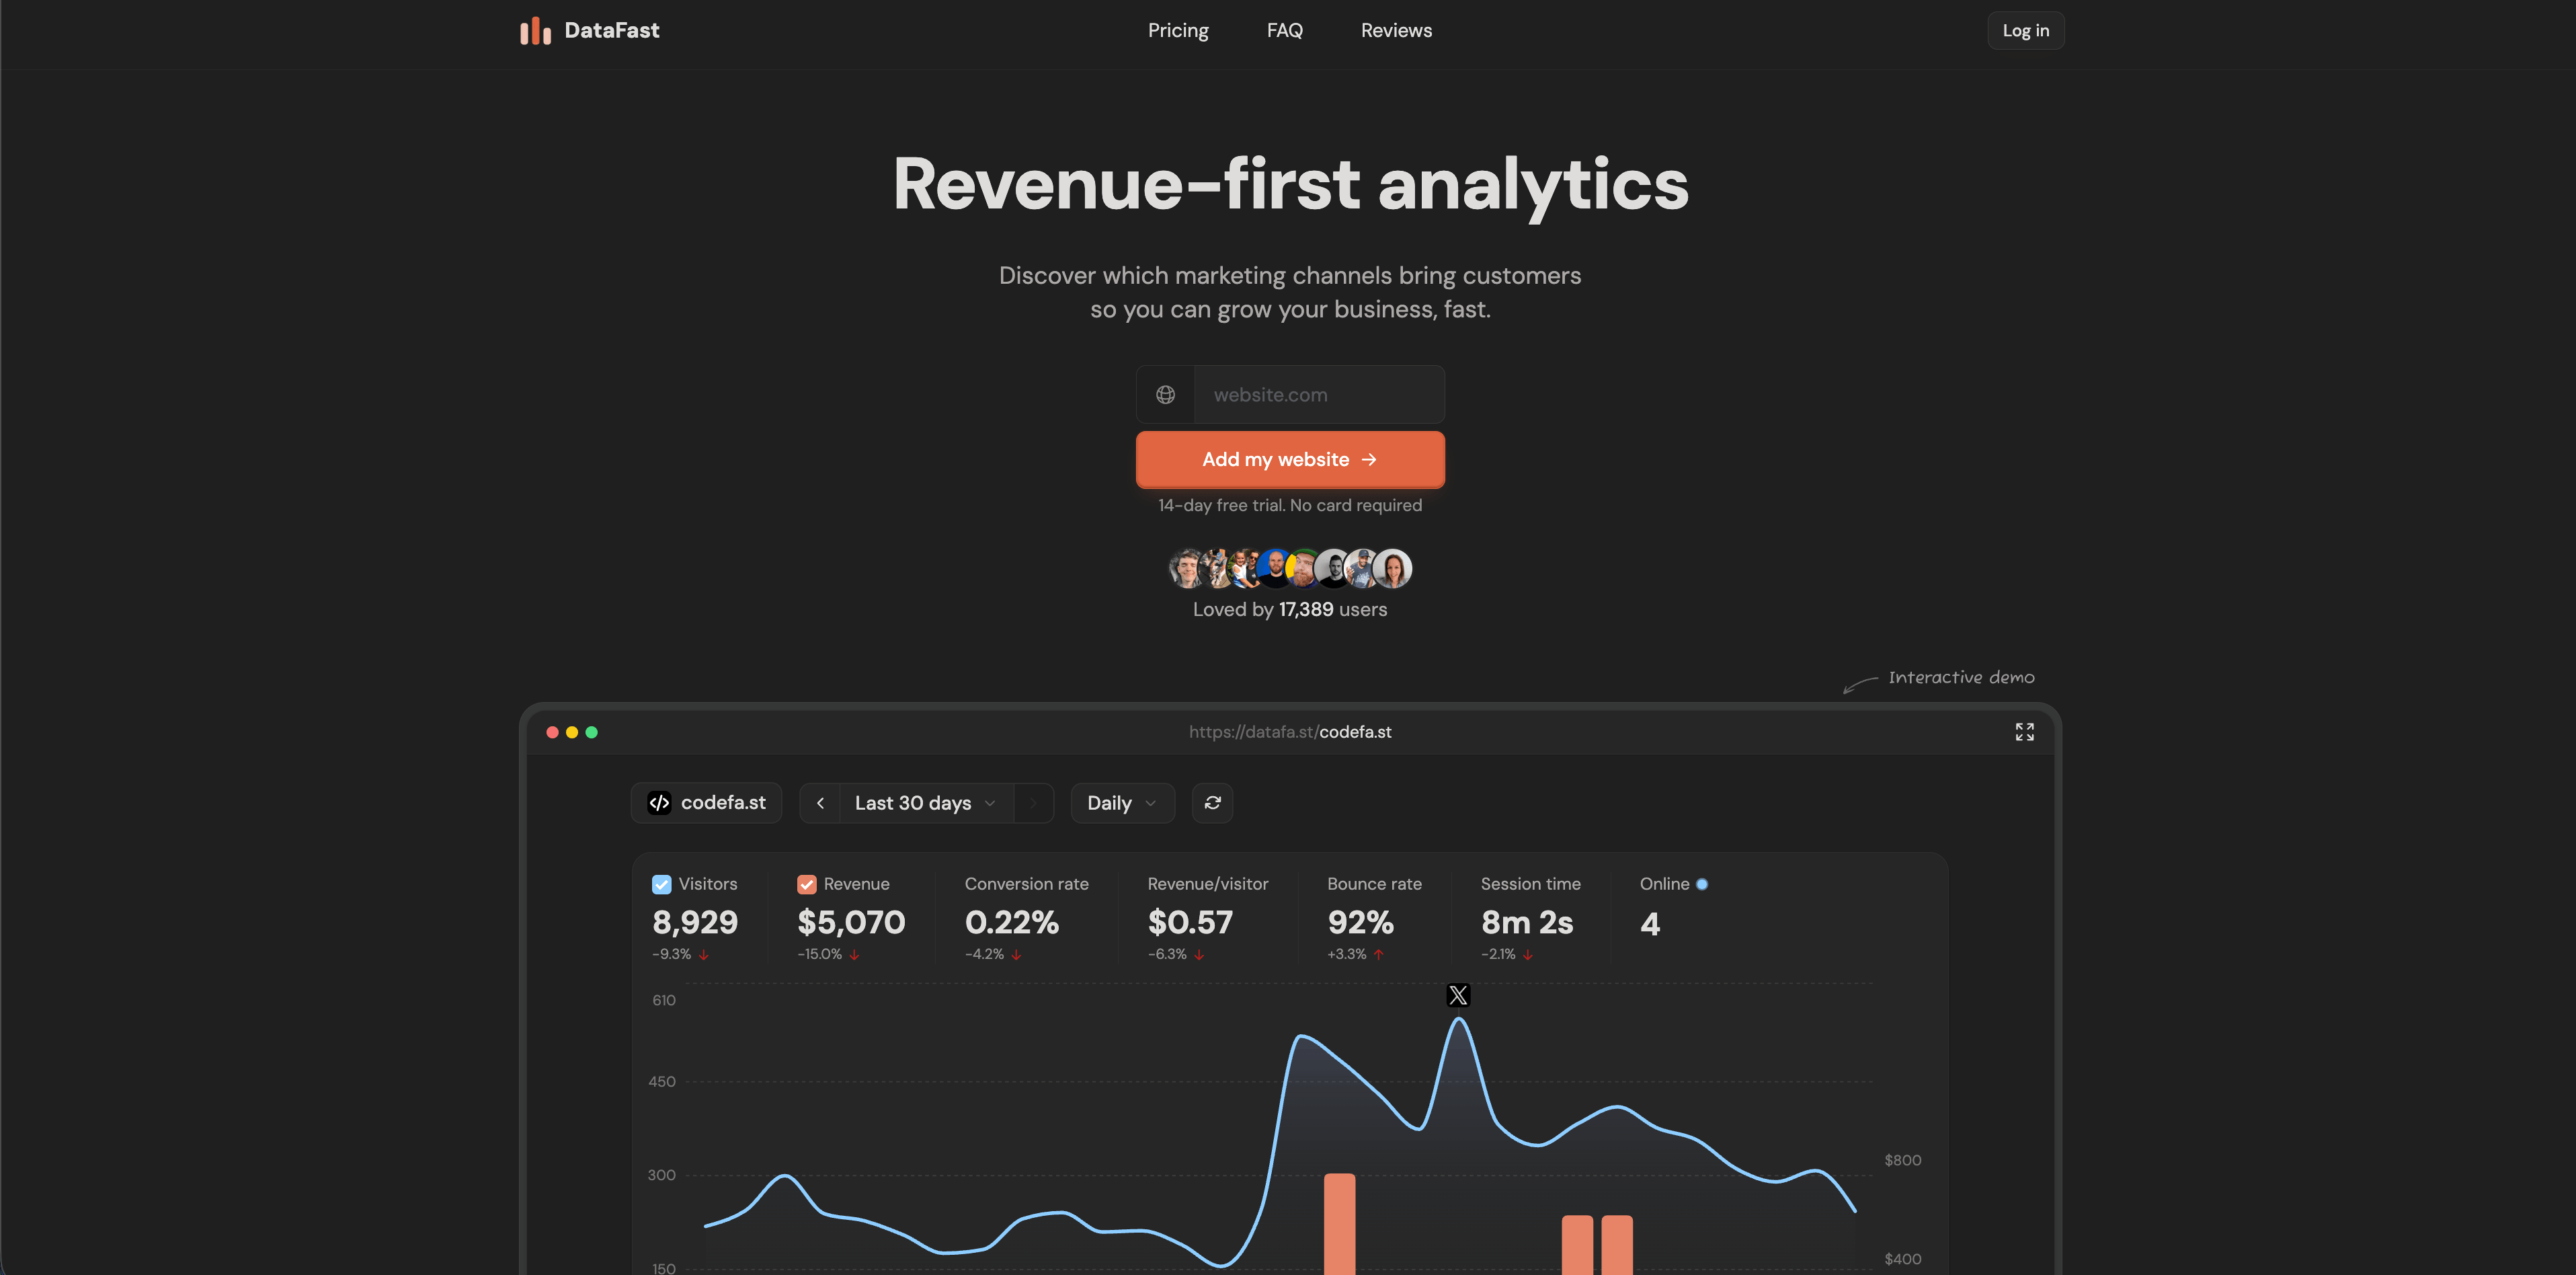
DataFast documenta una API v1 para datos de analítica y objetivos, y su changelog de abril de 2025 indica que la API puede crear objetivos personalizados para acciones de usuario específicas del lado del servidor. Su documentación de ingresos del lado del cliente también indica que se recomienda el seguimiento del lado del servidor para mayor precisión.
DataFast es adecuado para makers y pequeños equipos de SaaS a quienes les importa sobre todo qué canales generan clientes e ingresos. Su enfoque del lado del servidor tiene menos que ver con la instrumentación amplia y más con confirmar objetivos y eventos de ingresos.
Flowsery
Prueba gratuita
Panel en tiempo real
Seguimiento de objetivos
Rastreo sin cookies
Presta atención a la correspondencia de visitantes. La atribución de ingresos depende de vincular el pago u objetivo verificado con el visitante, la sesión o la fuente que lo generó.
10. PostHog
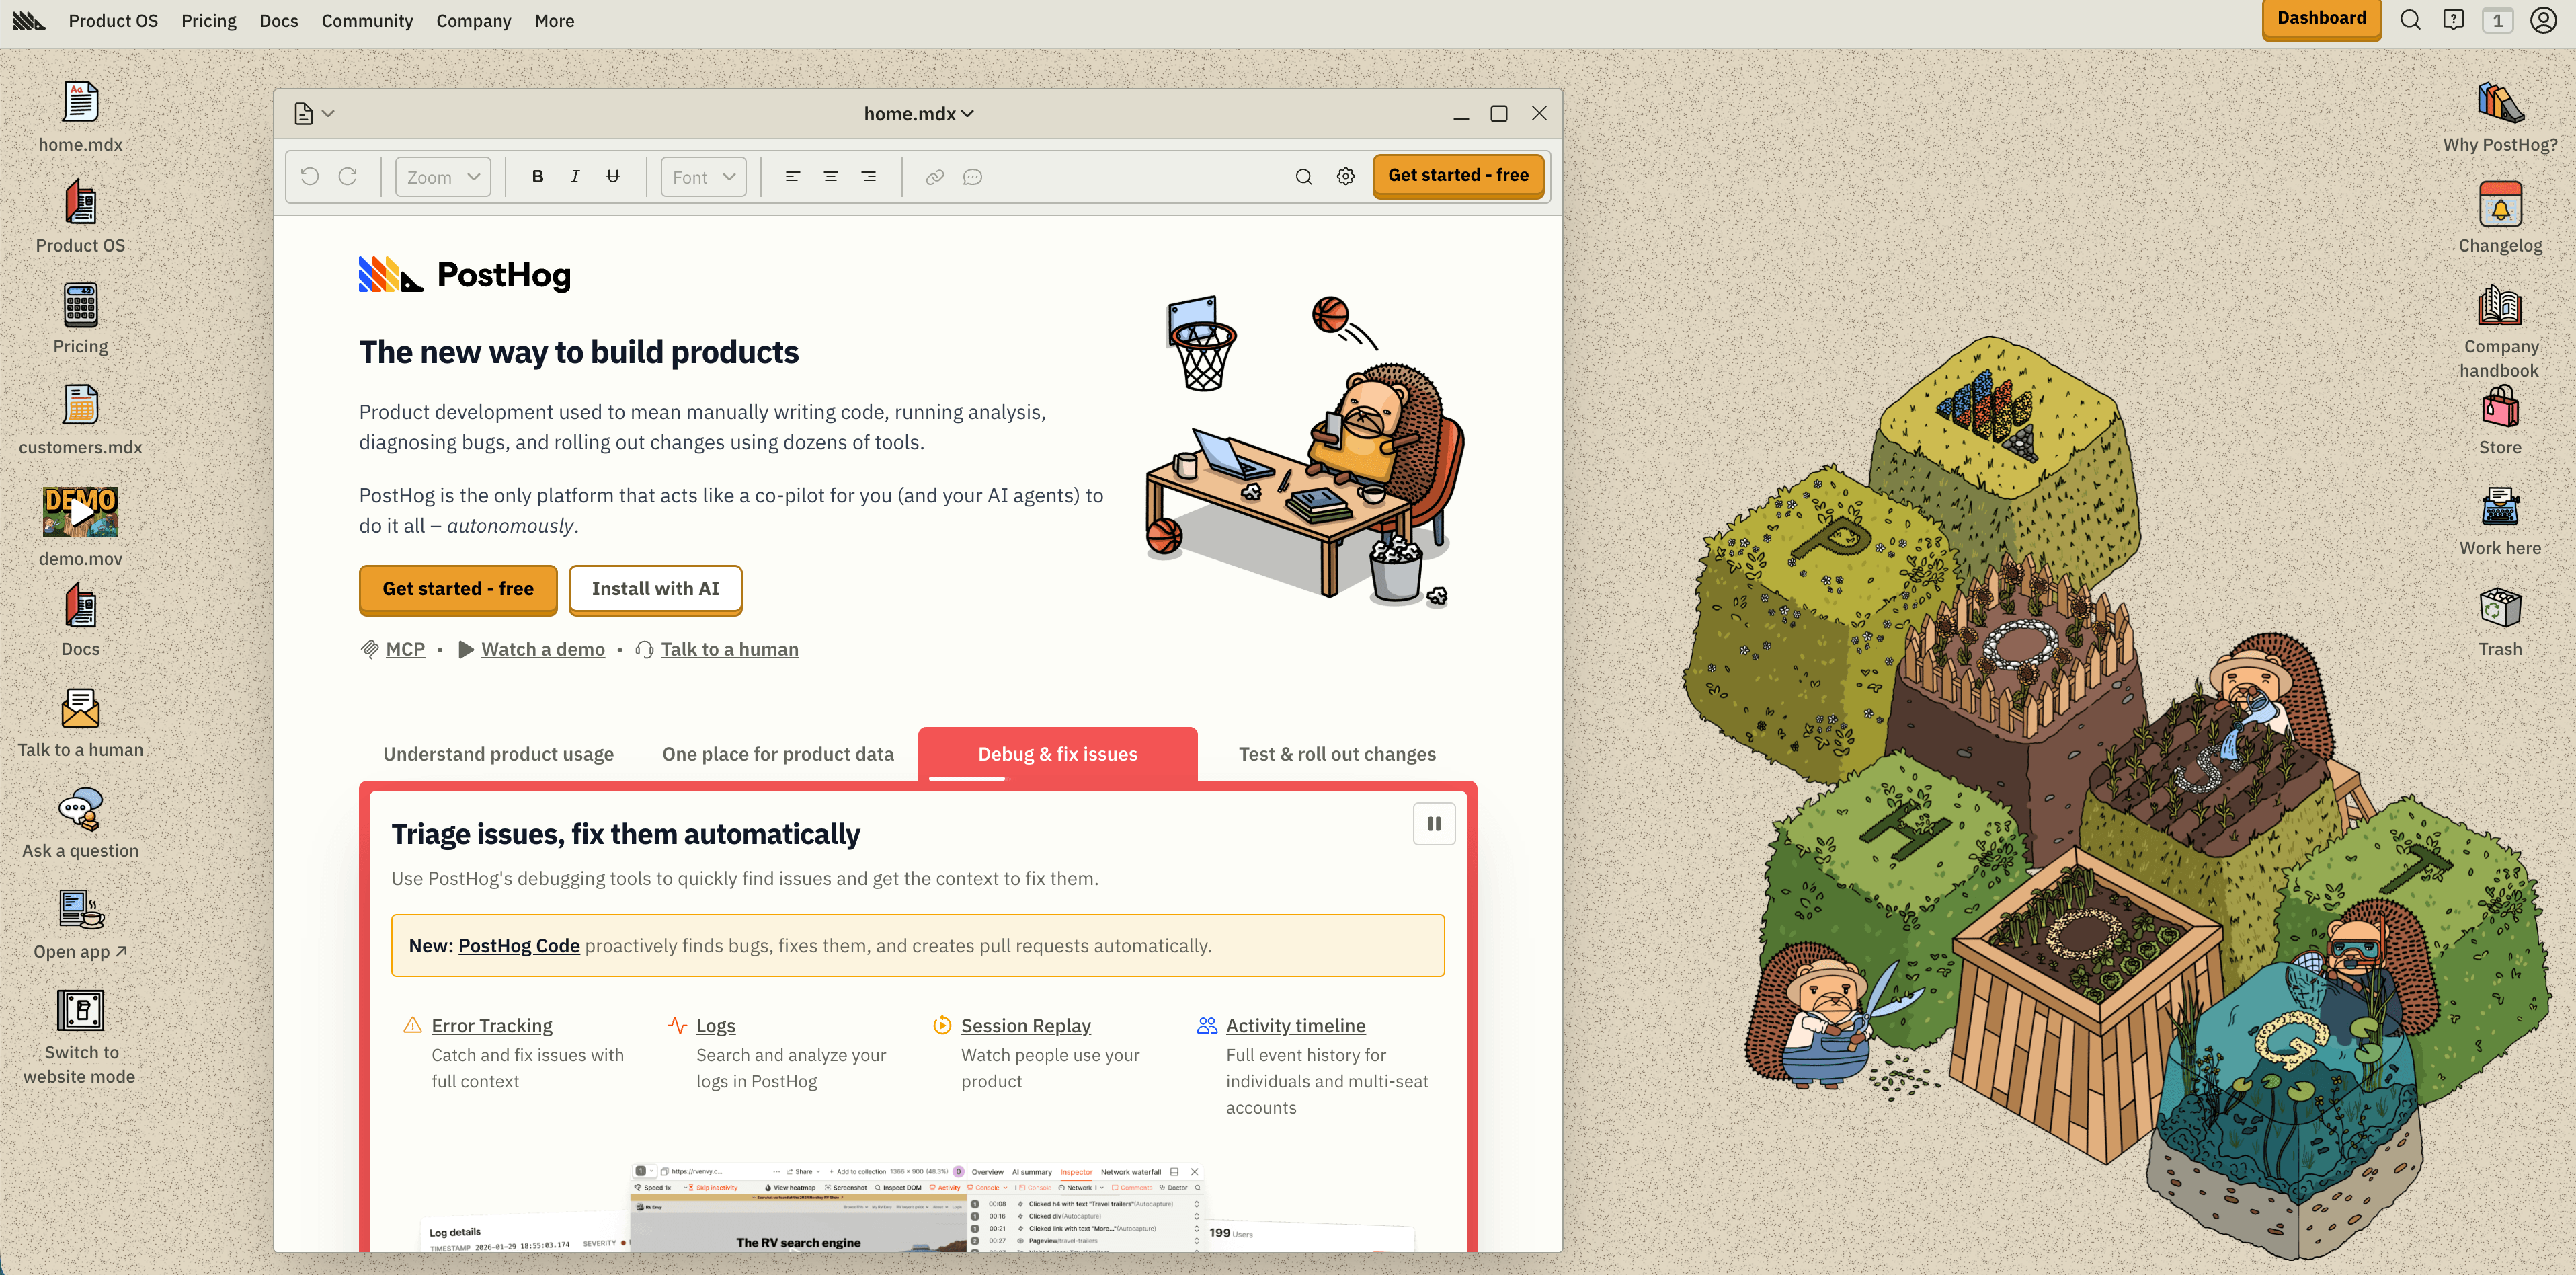
PostHog va mucho más allá de la analítica web. Sus páginas de producto públicas y sus listados de SDK describen librerías web, librerías móviles, librerías del lado del servidor, analítica de producto, analítica web, repetición de sesiones, feature flags, experimentos, encuestas, almacén de datos, pipelines, seguimiento de errores y más.
PostHog encaja con equipos liderados por ingeniería que quieren eventos de backend, analítica de producto, flags, experimentos, repetición de sesiones y movimiento de datos en el mismo producto. El seguimiento del lado del servidor es habitual para eventos de suscripción, estado de facturación, trabajos en segundo plano, evaluación de feature flags y acciones exclusivas del backend.
Vigila la gobernanza. PostHog puede ser ligero para una startup, pero también puede convertirse en el centro de todo el stack de datos de producto. Decide qué eventos son anónimos, cuáles crean perfiles de persona, qué propiedades están permitidas y qué equipos pueden añadir destinos.
11. Mixpanel
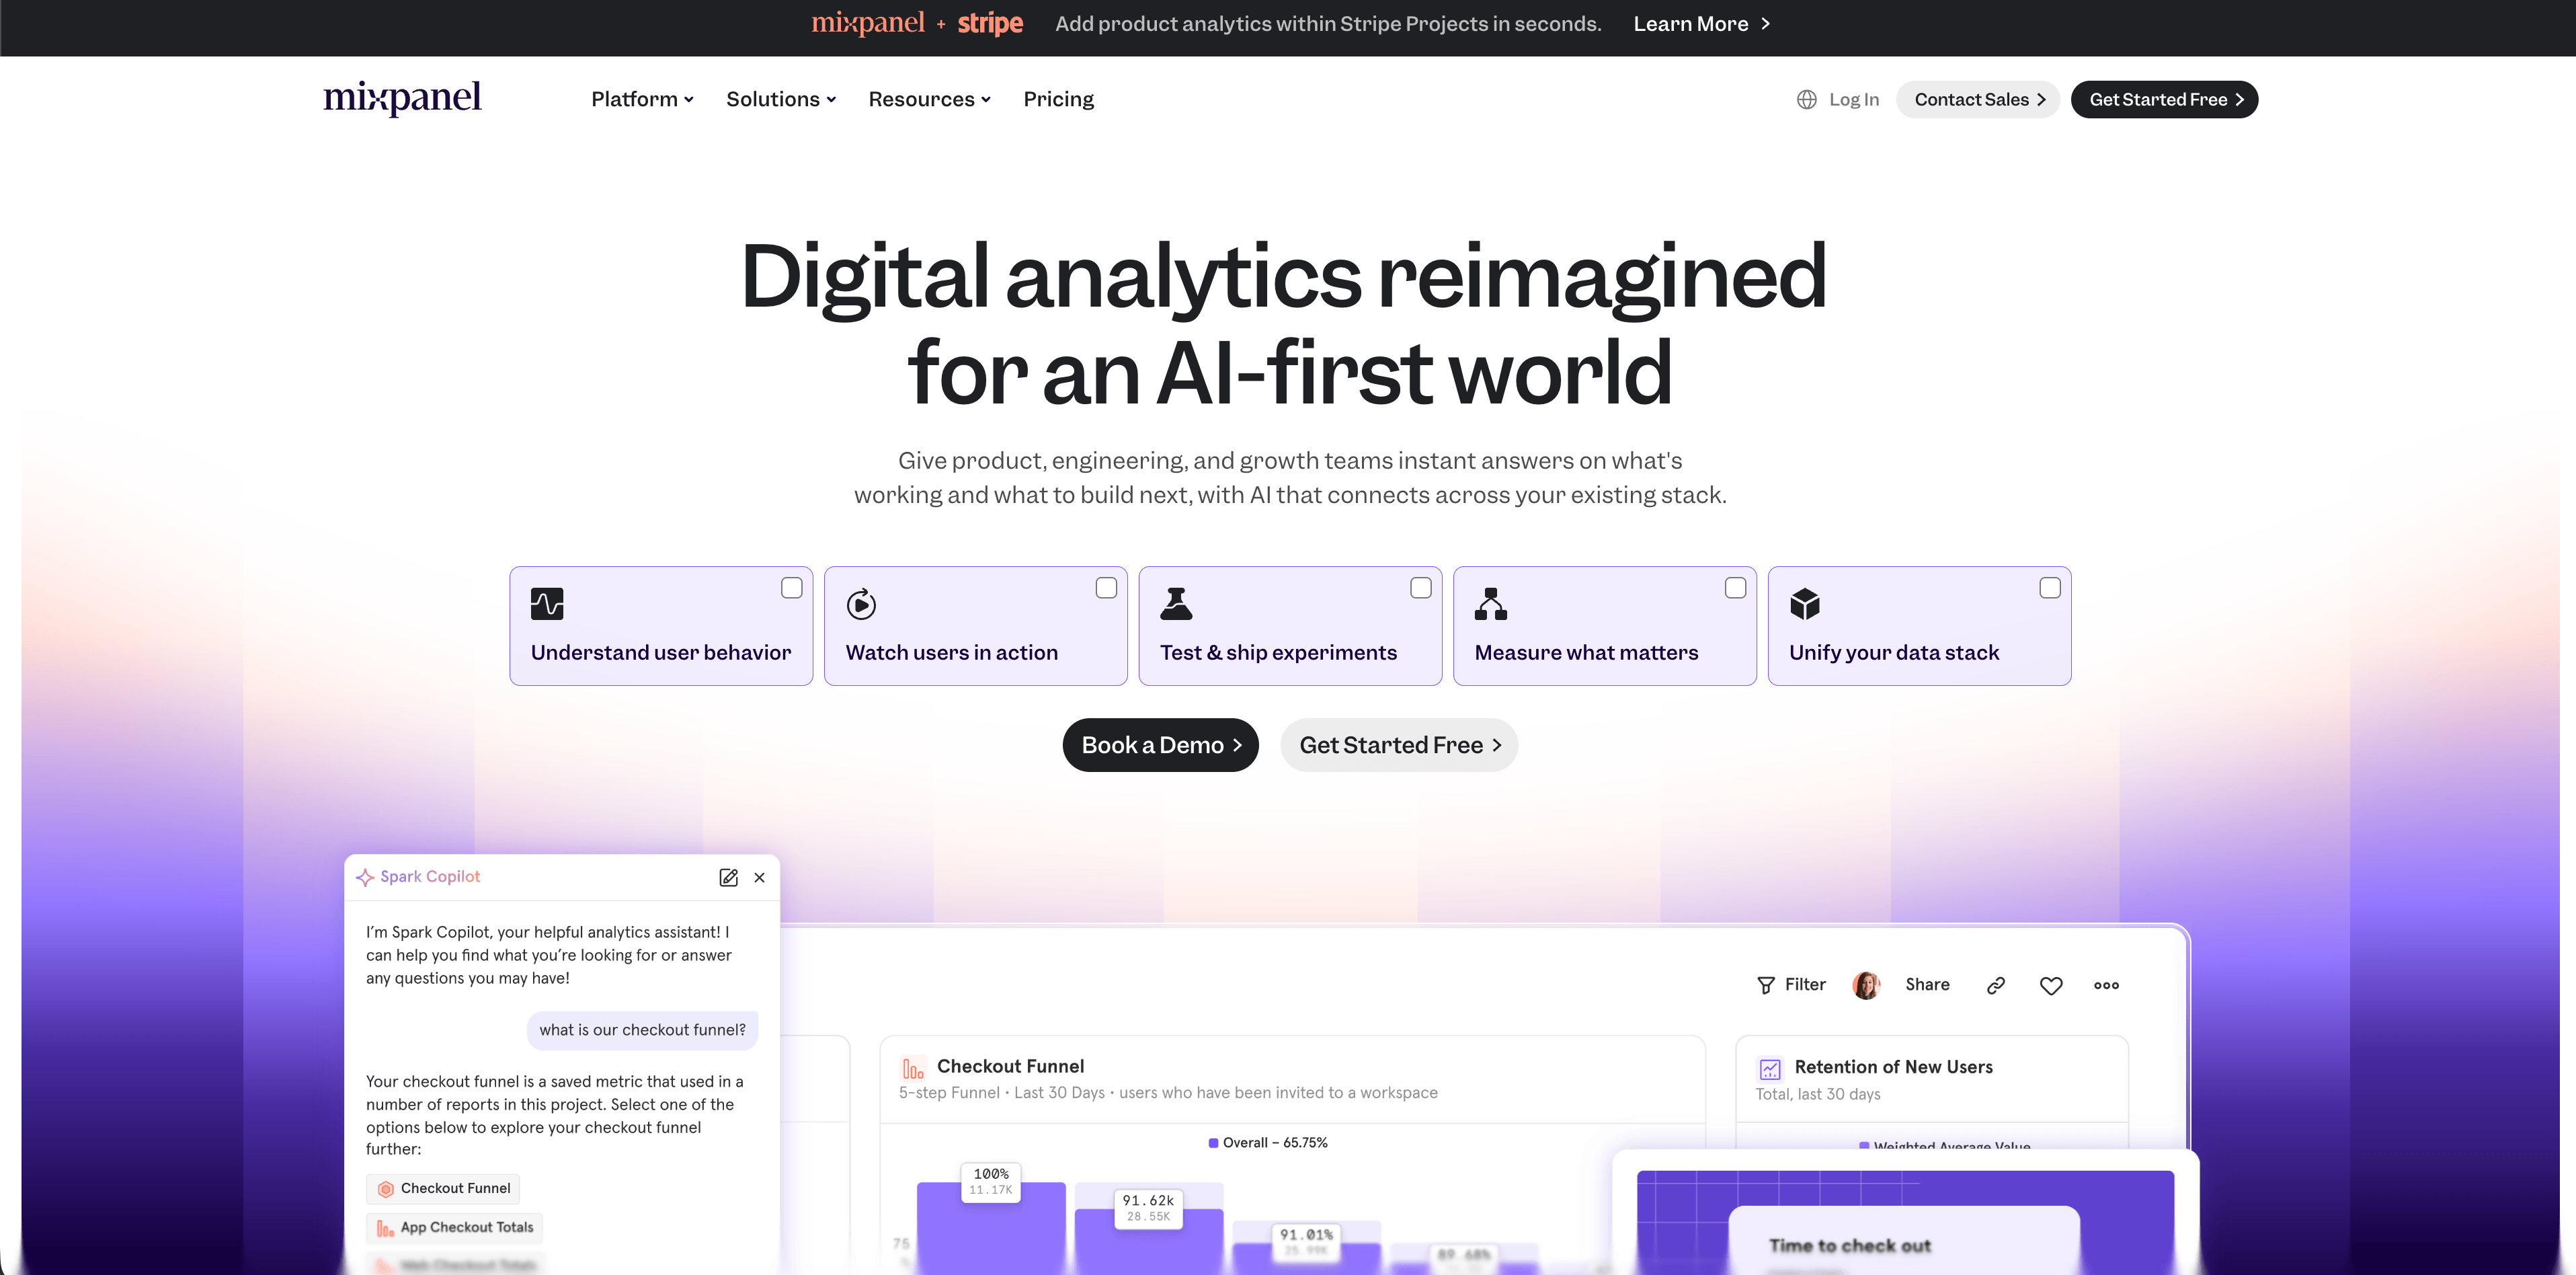
La referencia para desarrolladores de Mixpanel documenta el endpoint de ingesta /track, y las librerías cliente de Mixpanel admiten el seguimiento de eventos del lado del servidor. Los eventos del lado del servidor encajan de forma natural con los eventos de producto que tu backend conoce con certeza.
Mixpanel encaja con equipos que tienen una taxonomía de eventos real: activación, retención, uso de funciones, cohortes, embudos y análisis del ciclo de vida. Es potente cuando la empresa trata el seguimiento como un producto de datos diseñado, no como un montón de llamadas improvisadas.
Vigila los valores por defecto del navegador que faltan. Los eventos del lado del servidor no heredan automáticamente UTM, referente, dispositivo, campaña o contexto de sesión salvo que pases o persistas ese contexto de forma intencionada.
12. Heap
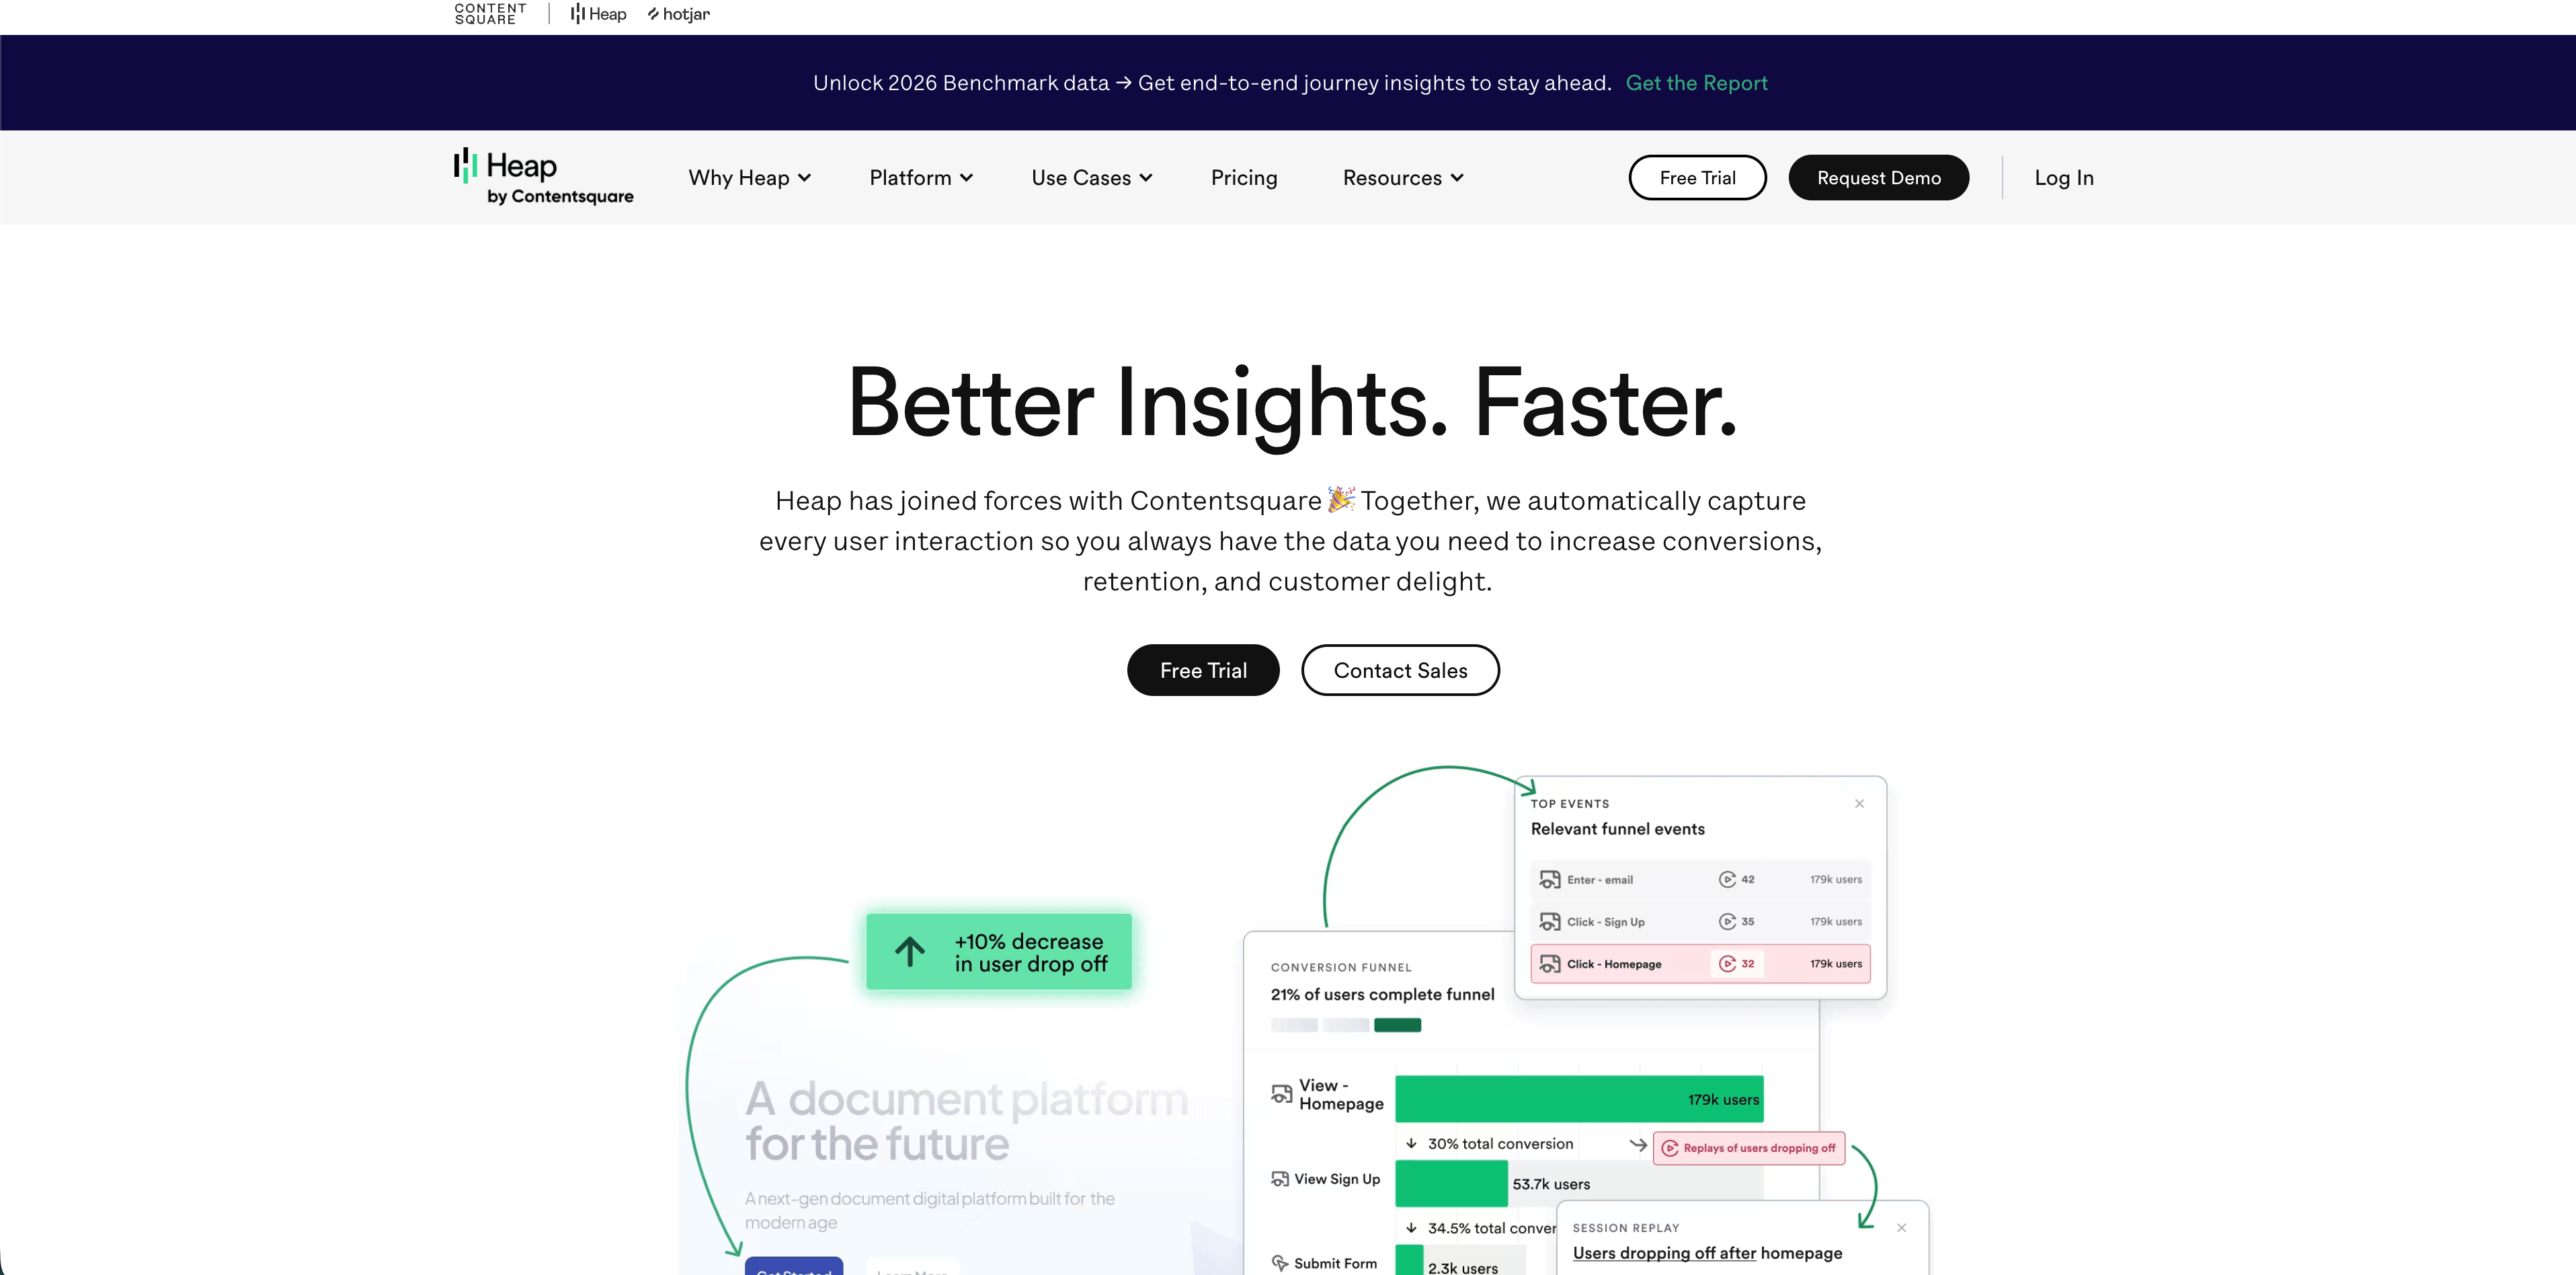
Heap documenta una API Track del lado del servidor para eventos personalizados. Se recomienda esta API para eventos que necesitan coincidir exactamente con los datos del backend, como pedidos completados, o para eventos que Heap no puede capturar en el lado del cliente.
Heap encaja con equipos de producto que quieren comportamiento capturado automáticamente en el navegador junto con hechos concretos del backend. Esa combinación puede ser útil cuando el recorrido del frontend importa, pero la conversión final o el estado de la cuenta solo son fiables en el servidor.
Vigila el comportamiento de sesión. La documentación de Heap señala que los eventos personalizados del lado del servidor tienen restricciones relacionadas con la identidad y la sesionización. No siempre son intercambiables con los eventos web capturados automáticamente.
Un plan práctico de implementación
Empieza con un contrato de medición antes de elegir herramientas.
| Métrica | Fuente de verdad | Ruta de seguimiento |
|---|---|---|
| Vista de página | Analítica del navegador o evento de ruta renderizado en el servidor | Del lado del cliente, salvo que la app se renderice mayormente en el servidor |
| Registro creado | Base de datos de la aplicación | Del lado del servidor |
| Lead enviado | Manejador de formularios del backend | Del lado del servidor, con el contexto de origen del navegador adjunto |
| Compra pagada | Webhook de pago o base de datos de pedidos | Del lado del servidor |
| Clic en pestaña de precios | Interfaz del navegador | Del lado del cliente |
| Archivo descargado | Endpoint de archivos autenticado | Del lado del servidor |
| Cuota de API excedida | Servicio backend | Del lado del servidor |
| Profundidad de scroll | Viewport del navegador | Del lado del cliente |
| Tasa de errores 404 o 500 | Registros del servidor, del edge o de observabilidad | Del lado del servidor o registros |
Luego define el contrato de eventos:
Flowsery
Prueba gratuita
Panel en tiempo real
Seguimiento de objetivos
Rastreo sin cookies
- Nombra los eventos en lenguaje de negocio sencillo, como
signup_created,lead_qualified,checkout_paidoinvoice_refunded. - Da a cada evento de alto valor una clave de idempotencia o un ID de transacción.
- Guarda el origen de la landing, los parámetros UTM, el referrer y el ID de visitante anónimo antes de que ocurra la conversión.
- Envía solo las propiedades necesarias para los informes.
- Elimina correos electrónicos, números de teléfono, query strings sin procesar, datos de pago e identificadores de usuario innecesarios.
- Decide qué eventos requieren consentimiento y cuáles son registros operativos estrictamente necesarios.
- Documenta la deduplicación entre eventos del navegador y del servidor.
- Prueba cada evento en el panel y, cuando esté disponible, en las exportaciones sin procesar.
Lista de verificación de privacidad
El seguimiento del lado del servidor puede reducir la fuga de datos, pero solo si el diseño es disciplinado.
- No trates "del lado del servidor" como sinónimo de "conforme con la privacidad".
- Mantén los payloads de analítica más pequeños que los registros del backend de los que provienen.
- No reenvíes direcciones IP completas, correos electrónicos, nombres, notas de pedidos ni query strings de URL a menos que haya una necesidad clara y una base legal.
- Respeta el consentimiento y el estado de exclusión antes de reenviar eventos a destinos de analítica o publicidad.
- Separa los registros operativos de la analítica de marketing.
- Define los periodos de retención antes de que se acumulen los datos.
- Incluye la eliminación, exportación, el DPA, los subprocesadores y la región de alojamiento como parte de la revisión de proveedores.
- Prefiere los informes agregados cuando no se necesite el detalle a nivel de usuario.
FAQ
¿El tracking del lado del servidor es más preciso?
El tracking del lado del servidor es más fiable para eventos que tu servidor confirma, como pagos, registros y acciones de API. No es automáticamente más preciso para el comportamiento en el navegador, y puede perder contexto de atribución si los UTM, el referrer, el user agent y los IDs de visitante no se gestionan con cuidado.
¿El tracking del lado del servidor evita los bloqueadores de anuncios?
El tracking del lado del servidor puede reducir las pérdidas por scripts de navegador bloqueados cuando los eventos se envían desde tu backend o infraestructura propia. Si el evento sigue originándose en un script del navegador, las herramientas de privacidad todavía pueden afectarlo, y aun así hay que respetar el consentimiento y las opciones de exclusión.
¿Sigo necesitando analítica del lado del cliente?
Por lo general, sí. La analítica del lado del cliente es mejor para el comportamiento que ocurre en el navegador: contexto de la página, clics, cambios de ruta, profundidad de scroll, tiempo visible, enlaces salientes e interacciones de UI. El tracking del lado del servidor debería complementarla con hechos verificados del backend.
¿El tracking del lado del servidor elimina la necesidad del banner de cookies?
No por sí solo. Las normas de consentimiento dependen de qué datos se recopilan, de si el sistema almacena o accede a información en el dispositivo del usuario, de si se usan identificadores y de a dónde se envían los datos. Un registro operativo mínimo del lado del servidor es distinto de un pipeline publicitario del lado del servidor.
¿Con qué plataforma debería empezar?
Empieza con Flowsery si lo que necesitas es analítica web centrada en la privacidad con fuentes, objetivos, embudos, recorridos, eventos personalizados y atribución de ingresos. Usa Plausible, Fathom, Simple Analytics, Pirsch, Umami o Matomo para una analítica web más simple o con mayor control de infraestructura. Usa PostHog, Mixpanel o Heap cuando la necesidad real sea analítica de producto.
¿Qué se considera un hecho de navegador frente a un hecho de servidor?
Un clic en una pestaña de precios es un hecho de navegador, un pago confirmado desde tu backend de facturación es un hecho de servidor, y un error 500 es un hecho de infraestructura. Asigna cada métrica al sistema que realmente lo presenció en lugar de forzar todos los eventos por una única fuente.
¿Pueden el tracking de navegador y de servidor reportar la misma conversión dos veces?
Sí, cuando un checkout dispara tanto un píxel de navegador como un evento de pago del backend para el mismo pedido. Diseña la deduplicación en torno a un ID de transacción estable, tal como la opción data-disable-payments de Flowsery y el campo insertId de Seline evitan eventos de pago duplicados.
¿Qué hace un contenedor de etiquetas del lado del servidor que un proxy propio no hace?
Un proxy propio recibe un evento del navegador y lo reenvía, así que sigue originándose en el navegador y conlleva las mismas cuestiones de consentimiento y acceso al dispositivo. Un contenedor de etiquetas del lado del servidor recibe eventos y los enruta a múltiples destinos, gestionando transformaciones y deduplicación, a costa de más infraestructura, coste y gobernanza.
¿Cuánto cuesta Flowsery para el tracking de ingresos del lado del servidor?
Flowsery ofrece un único plan de $500/mes tras una prueba gratuita de 14 días, y ese plan ya incluye el acceso a la API, los objetivos personalizados y la API de pagos necesarios para la atribución de ingresos del lado del servidor. No existe un nivel aparte para eventos del lado del servidor.
¿Los recuentos brutos de logs del servidor equivalen a cifras reales de visitantes?
No, los logs del servidor mezclan crawlers, monitores de uptime, bots de vista previa de enlaces, crawlers de IA, reintentos, prefetches y solicitudes en caché junto con personas reales. Un recuento de solicitudes solo se convierte en una cifra de audiencia utilizable una vez que clasificas y filtras ese tráfico, por lo que la analítica de logs y de edge encaja mejor con operaciones y seguimiento de errores que con el conteo de sesiones.
Bottom line
El seguimiento del lado del servidor no es una mejora mágica. Es una forma de poner los eventos correctos en el lugar correcto. Usa el navegador para hechos del navegador, el backend para hechos de negocio y el panel para decisiones que puedan superar una revisión de privacidad.
Empieza con Flowsery para analítica centrada en la privacidad si quieres fuentes, objetivos, embudos, recorridos, eventos personalizados y atribución de ingresos sin convertir a cada visitante en un perfil de adtech.
Fuentes revisadas el 12 de mayo de 2026: precios de Flowsery, configuración del script de Flowsery, objetivos personalizados de Flowsery, introducción a la API de Flowsery, API de eventos de Plausible, referencia de la API de Fathom, documentación del lado del servidor de Simple Analytics, documentación de Pirsch, documentación de eventos de Pirsch, API de seguimiento de Matomo, eventos del lado del servidor de Umami, eventos personalizados de Seline, documentación de la API de DataFast, registro de cambios de la API de DataFast, páginas de producto y SDK de PostHog, API de seguimiento de eventos de Mixpanel, API de seguimiento de Heap, guía de la ICO sobre cookies y tecnologías similares, y guía sobre cookies de la Data Protection Commission.
Flowsery
Prueba gratuita
Panel en tiempo real
Seguimiento de objetivos
Rastreo sin cookies
¿Te resultó útil este artículo?
¡Cuéntanos qué opinas!
Vernos más en Google
Un clic marca Flowsery como fuente preferida y nuestros artículos aparecen más arriba en tus Noticias destacadas, el modo IA y los resúmenes con IA.
Antes de irte...
Flowsery
Analítica orientada a ingresos para tu sitio web
Rastrea cada visitante, fuente y conversión en tiempo real. Simple, potente y sin cookies.
Panel en tiempo real
Seguimiento de objetivos
Rastreo sin cookies
Artículos relacionados
Como comparar herramientas comerciales de analítica web
Al comparar herramientas comerciales de analítica web: privacidad, precio, dashboards, funnels, atribución de ingresos y profundidad de producto.
Lista 2026 de software de analítica web verificado
Compara top web analytics software para 2026 con precios verificados, notas de privacidad, capturas de dashboard y una seleccion liderada por Flowsery.
Compara plataformas de analítica web en 2026 | Flowsery
Este panorama de web analytics platforms compara modelo de datos, privacidad, precios, embudos, atribución de ingresos y self-hosting.