
TL;DR, Resposta rápida
17 min de leituraServer-side tracking é útil quando você precisa de dados de conversão mais limpos, controle mais rigoroso sobre o que sai da sua infraestrutura, payloads mais leves no browser e uma fonte de verdade melhor para eventos de backend. Ele não é uma brecha de privacidade nem uma correção mágica para toda lacuna de analytics.
Para a maioria das equipes, os benefícios reais do server side tracking não são esconder analytics do navegador; são mover as decisões de medição mais importantes para uma infraestrutura que você consegue inspecionar, validar e governar.
Este guia foi checado em 12 de maio de 2026 contra documentação oficial do Google, Meta, WebKit, Mozilla, UK ICO e páginas públicas de produto das plataformas de analytics abaixo. Flowsery aparece primeiro porque e nossa plataforma e a recomendação padrão quando uma equipe de website quer analytics com privacidade antes de adicionar uma stack mais pesada de server-side tagging.
Resumo principal: server-side tracking vale considerar quando a decisão de negócio depende de signups, compras, receita, qualidade de leads ou dados first-party governados. Para relatórios simples de pageview, uma ferramenta de analytics com privacidade sem cookies pode resolver o problema com menos trabalho operacional.
O que server-side tracking realmente significa
Server-side tracking significa que um evento é coletado, processado ou encaminhado por um servidor que você controla antes de chegar a um destino de analytics ou publicidade. Esse servidor é o backend da sua aplicação, um container server-side do Google Tag Manager, uma customer data platform, um reverse proxy, um pipeline de warehouse ou um endpoint de analytics com privacidade.
A distinção importante é controle. Em uma configuração apenas no browser, o browser muitas vezes envia eventos diretamente para vários terceiros. Em uma configuração server-side, seu servidor pode validar o evento, remover campos, adicionar contexto conhecido pelo servidor, deduplicar eventos, rejeitar requisições ruins e decidir quais destinos recebem quais dados.
O Google descreve server-side tagging como um endpoint intermediário que você possui entre o browser ou app e endpoints de terceiros. A documentação oficial do Tag Manager diz que os principais benefícios são reduzir a carga de processamento no client, permitir revisar e modificar dados para privacidade e melhorar a qualidade dos dados por validação e normalização.
Esse enquadramento é útil, mas precisa de uma ressalva. Server-side tracking não é automaticamente privado, legal, preciso ou dispensado de consentimento. Um evento server-side mal desenhado que armazena endereços IP para sempre, encaminha emails com hash para redes de anúncios sem base válida ou captura parâmetros sensíveis de URL pode ser pior que um evento mínimo de analytics client-side.
Os benefícios práticos do server side tracking
| Benefício | O que melhora | O que ainda pode dar errado |
|---|---|---|
| Dados de conversão mais limpos | Eventos de backend podem confirmar compras, signups, assinaturas e envios de leads depois que realmente acontecem. | Duplicatas e eventos obsoletos podem poluir relatórios se eventos de browser e servidor não forem deduplicados. |
| Mais controle sobre compartilhamento de dados | Seu servidor pode remover campos, bloquear destinos, mapear escolhas de consentimento e normalizar payloads. | Controle só ajuda se as regras forem documentadas, testadas e mantidas. |
| Menos trabalho no browser | O client pode enviar menos requisições e executar menos código de terceiros. | Um setup server-side ainda pode carregar tags pesadas no browser se você deixar a stack antiga ativa. |
| Melhor qualidade de eventos | Regras server-side podem rejeitar eventos malformados, padronizar nomes e adicionar contexto confiável de backend. | Taxonomia ruim vira dados ruins em escala. Server-side não corrige design de eventos confuso. |
| Atribuição mais forte para resultados reais | Receita, assinaturas, reembolsos e eventos offline de ciclo de vida podem vir de sistemas de registro. | Atribuição de plataformas de anúncios ainda depende de regras de matching, consentimento, click IDs e modelagem da plataforma. |
| Governança melhor | Times de segurança, jurídico, marketing e produto podem revisar um pipeline controlado. | A governança falha se cada equipe adiciona destinos sem revisão. |
Por que tracking apenas no browser ficou frágil
Analytics apenas no browser depende de código rodando corretamente no dispositivo do visitante. Isso parece simples até você contar as formas como pode falhar: ad blockers, listas de trackers, recursos de privacidade do browser, falhas de rede, rejeição de consentimento, regras de content security policy, erros de script, bugs de roteamento em single-page apps e usuários que saem antes de uma tag terminar de carregar.
Mudanças de privacidade não são hipotéticas. A WebKit documenta tracking prevention como um recurso antigo do Safari e diz que sua política padrão de cookies restringe cookies de terceiros. A Mozilla diz que o Firefox Total Cookie Protection mantem armazenamento separado de cookies para cada website por padrão. A linha do tempo de cookies de terceiros do Chrome mudou várias vezes, mas a direção continua sendo mais controles para usuários e menos cross-site tracking silencioso.
Server-side tracking não faz essas restrições desaparecerem. Ele permite, porém, medir eventos que acontecem na sua própria infraestrutura, como confirmação de checkout, criação de conta, pagamento de invoice, upgrade de trial ou status de lead qualificado. Esses eventos não precisam depender de uma tag de browser disparar exatamente no momento certo.
Benefício 1: Você pode medir resultados reais de backend
O evento server-side mais forte é aquele que seu backend já sabe que é verdadeiro.
Um browser pode dizer que alguém clicou em um botão de checkout. Seu backend pode dizer que o pagamento foi aprovado, o order ID foi criado, o cupom foi aplicado, o plano de assinatura mudou ou o reembolso aconteceu três dias depois.
Essa diferença importa para equipes de growth. Se campanhas pagas são otimizadas em "botão clicado" enquanto o financeiro se importa com "pedido pago concluído", seus relatórios vão divergir. Server-side tracking permite enviar o evento confirmado pelo sistema de registro.
Bons eventos de conversão server-side costumam incluir:
Painel em tempo real
Rastreamento de metas
Rastreamento sem cookies
- signup concluído
- email verificado
- trial iniciado
- checkout concluído
- assinatura ativada
- plano atualizado
- lead qualificado
- invoice paga
- reembolso emitido
- conta cancelada
Esses eventos normalmente são melhores como eventos de backend do que como palpites do browser. O browser ainda pode ajudar com contexto de campanha, landing page, referrer, dispositivo e comportamento de sessão. O servidor deve ser dono do evento final de negócio.
Benefício 2: Você pode controlar o que sai do seu domínio
Este é o benefício de privacidade que realmente importa.
Server-side tracking dá a você um lugar para decidir quais campos podem sair da sua infraestrutura. Você pode remover query strings que contêm endereços de email, rejeitar PII acidental, aplicar hash em campos somente quando um destino exige e sua base legal permite, encurtar retenção, bloquear destinos por estado de consentimento e manter campos internos fora de plataformas de anúncios.
A documentação de server-side tagging do Google destaca diretamente essa camada de revisão e modificação. A documentação da Conversions API da Meta também enquadra eventos server-side como uma conexão mais direta entre dados de marketing do seu servidor, website, app, CRM ou fontes offline e a Meta.
Isso não significa "server-side igual compliant". A orientação do UK ICO trata cookies de analytics como não essenciais e diz que usuários precisam de controle sobre cookies e tecnologias similares não essenciais. Se seu setup server-side ainda armazena ou acessa informações no dispositivo do usuário, depende de identificadores ou envia dados pessoais para destinos de publicidade, você ainda precisa de uma revisão séria de consentimento e privacidade.
A regra útil é simples: server-side tracking é um ponto de controle, não uma autorização.
Benefício 3: Você pode reduzir carga no browser
Client-side tagging fica caro quando cada fornecedor quer seu próprio script, sua própria requisição de rede e seu próprio mapeamento de eventos. O Google diz que server-side tagging pode melhorar performance porque o client envia menos requisições e executa menos código, enquanto o container no servidor despacha requisições específicas de fornecedores.
Isso é especialmente relevante para sites de marketing onde taxa de conversão depende de velocidade. Um setup server-side limpo pode remover parte do trabalho de terceiros do browser, reduzir requisições duplicadas e manter a página mais próxima da experiência do produto em vez de transformá-la em um disparador de tags.
Há uma pegadinha. Se você adiciona server-side tracking mas mantém todas as tags antigas de browser, você basicamente adicionou complexidade. O benefício de performance aparece quando você simplifica intencionalmente o client e move o processamento certo para o servidor.
Benefício 4: Você pode normalizar dados de eventos bagunçados
Eventos de browser são bagunçados porque browsers, frameworks, rotas, dispositivos, extensões e condições de rede diferem. Processamento server-side dá a você um lugar para impor padrões:
- nomes de eventos usam a mesma capitalização
- campos obrigatórios estão presentes
- valores de receita usam um formato único de moeda
- tráfego de teste é excluído
- usuários internos são filtrados
- bots e uptime checks são tratados separadamente
- eventos duplicados de browser e servidor compartilham um event ID
- campos privados são descartados antes do encaminhamento
Esse trabalho é entediante, mas é de onde vem muita qualidade de relatório. Um dashboard é tão bom quanto o contrato de eventos por baixo dele.
Benefício 5: Você pode melhorar atribuição de mídia paga com cuidado
Plataformas de publicidade incentivam cada vez mais fluxos de conversão server-side. Google Ads Enhanced Conversions complementa a medição de conversões enviando dados first-party de conversão com hash. A Meta diz que Conversions API cria uma conexão direta e mais confiável entre dados de marketing e a Meta, com suporte a eventos de websites, apps, CRM, lojas físicas, telefone, email, business chat e fontes offline.
Isso pode melhorar matching e otimização, especialmente quando sinais de browser estão incompletos. Mas a resposta honesta não é "server-side tracking vai aumentar ROAS em X por cento". O ganho depende do seu mix de tráfego, taxa de consentimento, fluxo de checkout, distribuição de browsers, gasto em anúncios, qualidade de match, deduplicação e quanta perda de conversão você tinha antes.
Trate eventos server-side de plataformas de anúncios como um projeto de medição, não como um botão milagroso. Rode verificações antes/depois, compare contra pedidos de backend, monitore duplicatas e mantenha um caminho de rollback.
Painel em tempo real
Rastreamento de metas
Rastreamento sem cookies
Plataformas de dashboard para avaliar primeiro
Nem toda plataforma de analytics abaixo é um tag manager server-side. Esse é o ponto. Algumas equipes precisam de um pipeline governado de eventos server-side. Outras precisam de um dashboard com privacidade que evita os piores problemas de browser tracking sem deixar a stack mais pesada.
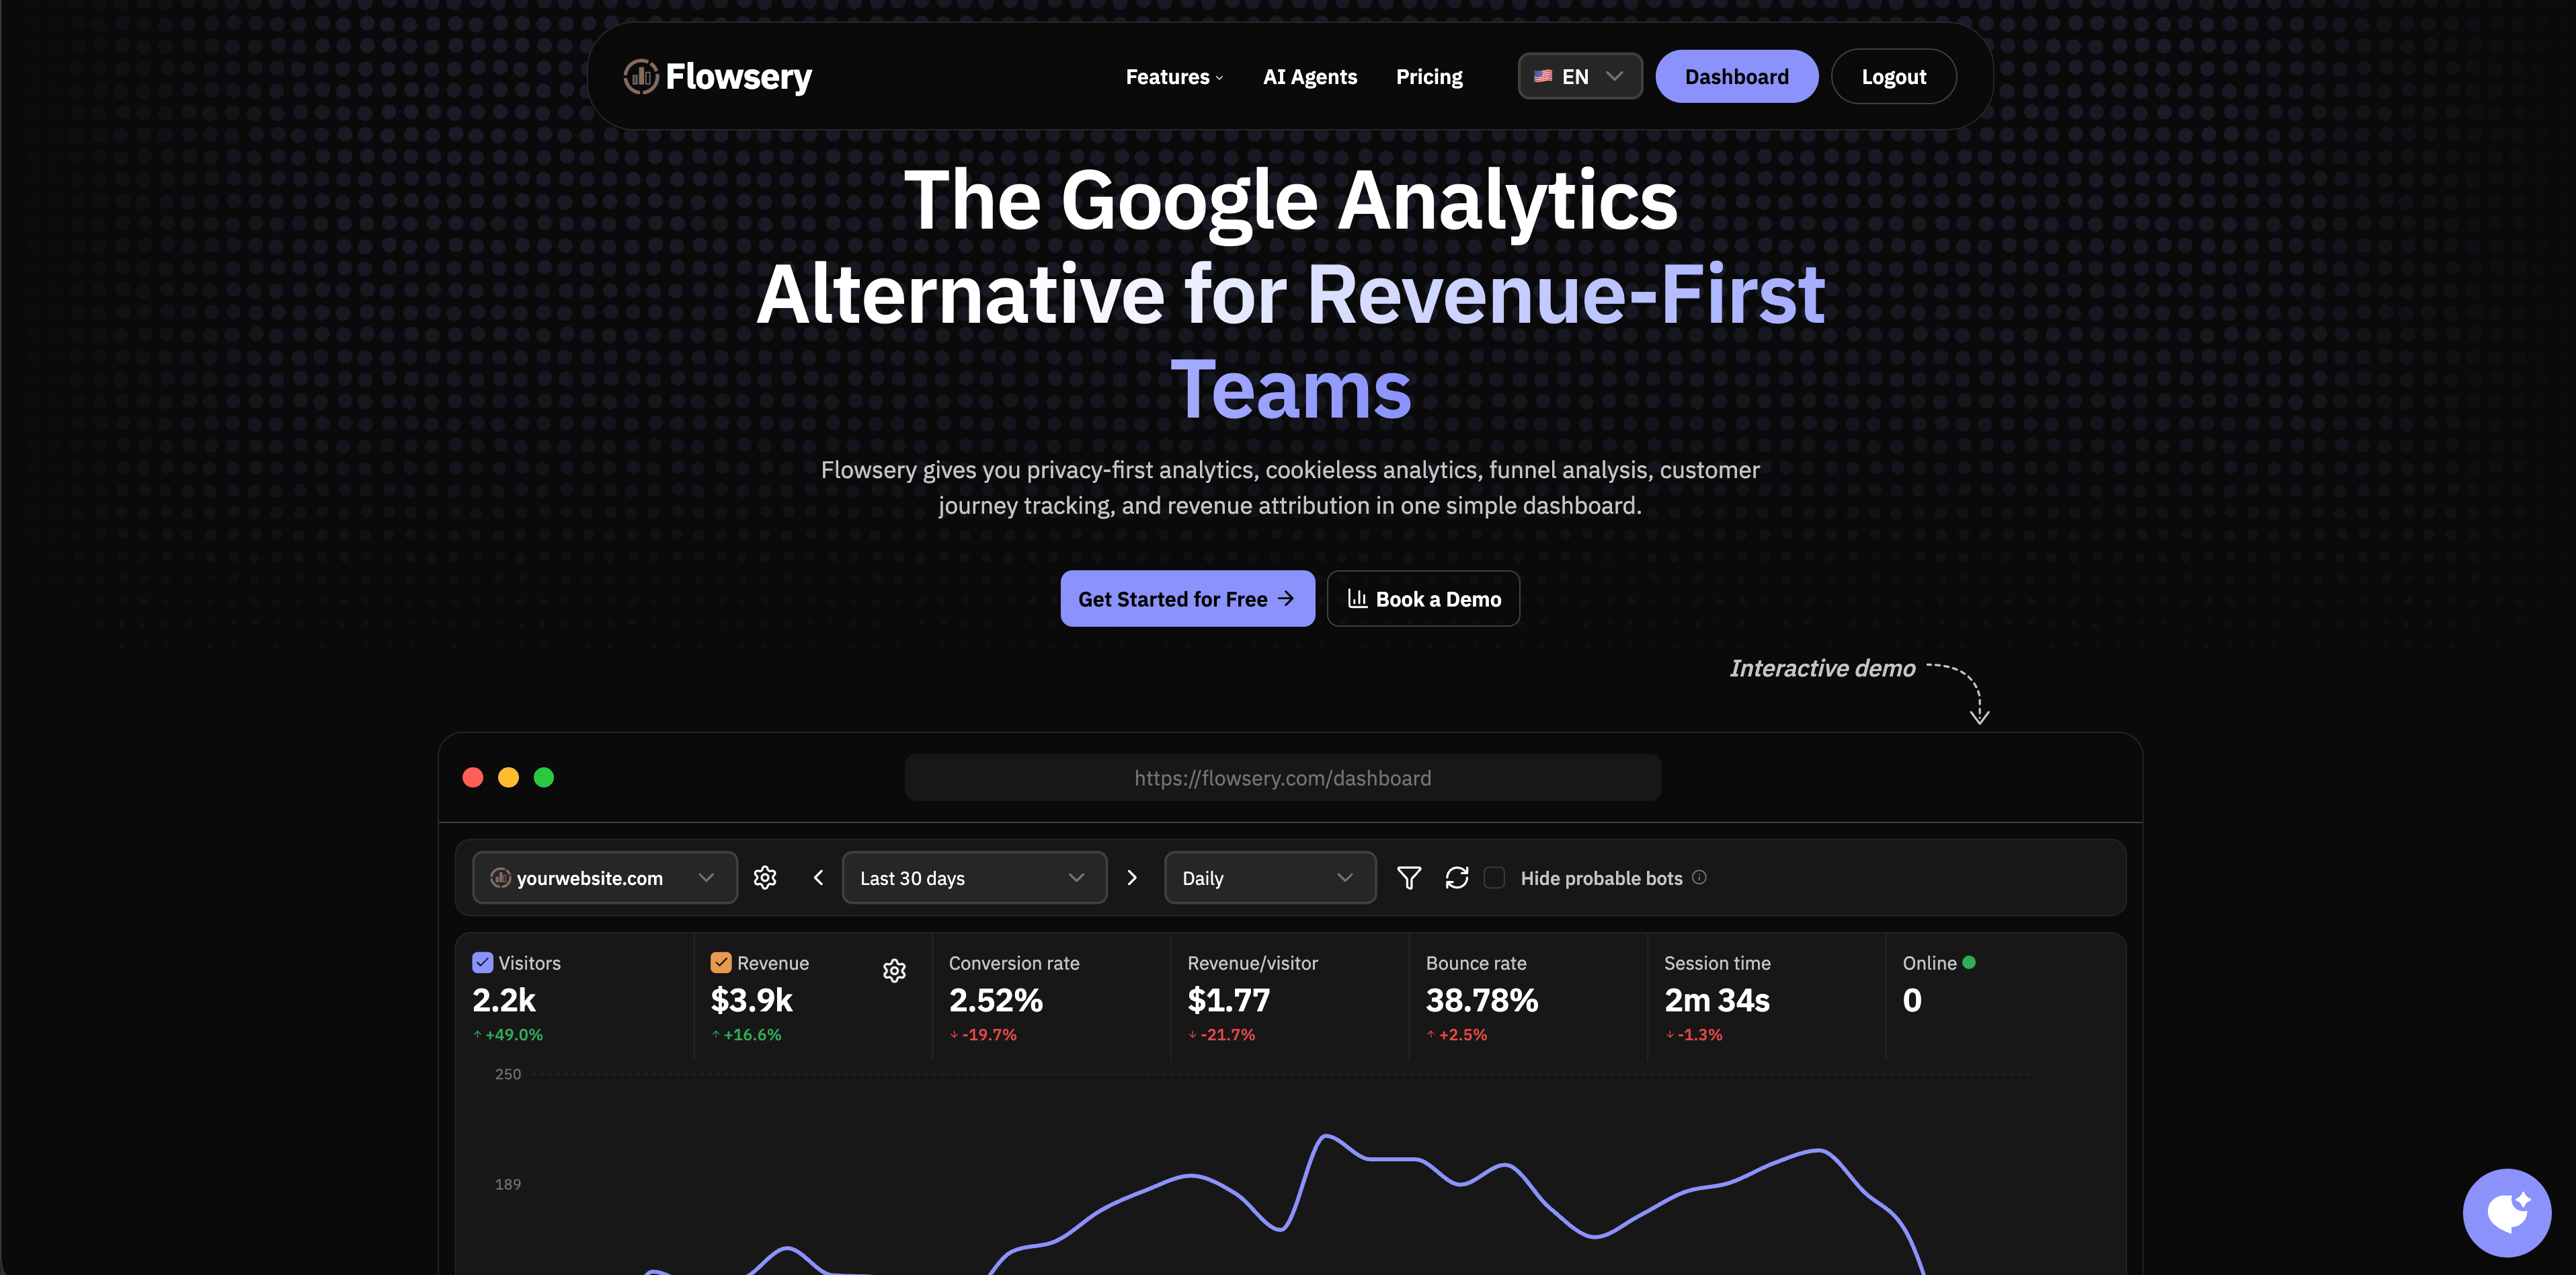
Flowsery vem primeiro porque é o melhor ponto de partida para equipes que querem website analytics, funis, jornadas, eventos e contexto de receita sem transformar medição básica em projeto de data engineering.
1. Flowsery
Flowsery é a primeira opção para avaliar quando o objetivo é website analytics prática e com privacidade, não um sistema de tracking espalhado. As páginas públicas do Flowsery descrevem analytics sem cookies, analítica em tempo real, funnel analysis, customer journey tracking, session recording, revenue attribution, eventos customizados, API access, filtragem avançada de bots e um teste gratuito de 14 dias antes de planos a partir de $250 por mês.
Flowsery combina com equipes que querem entender quais fontes, páginas, jornadas e funis levam à conversão sem começar por containers server-side do Google Tag Manager, pipelines de warehouse ou uma implementação de product analytics. Ele é especialmente útil quando marketing, produto e founders querem um dashboard para tráfego ao vivo, metas, funis, eventos customizados e atribuição de receita.
Use Flowsery primeiro quando você quer analytics com privacidade com contexto de negócio. Adicione eventos server-side depois para compras, assinaturas, leads qualificados ou outros resultados confirmados pelo backend.
2. Plausible
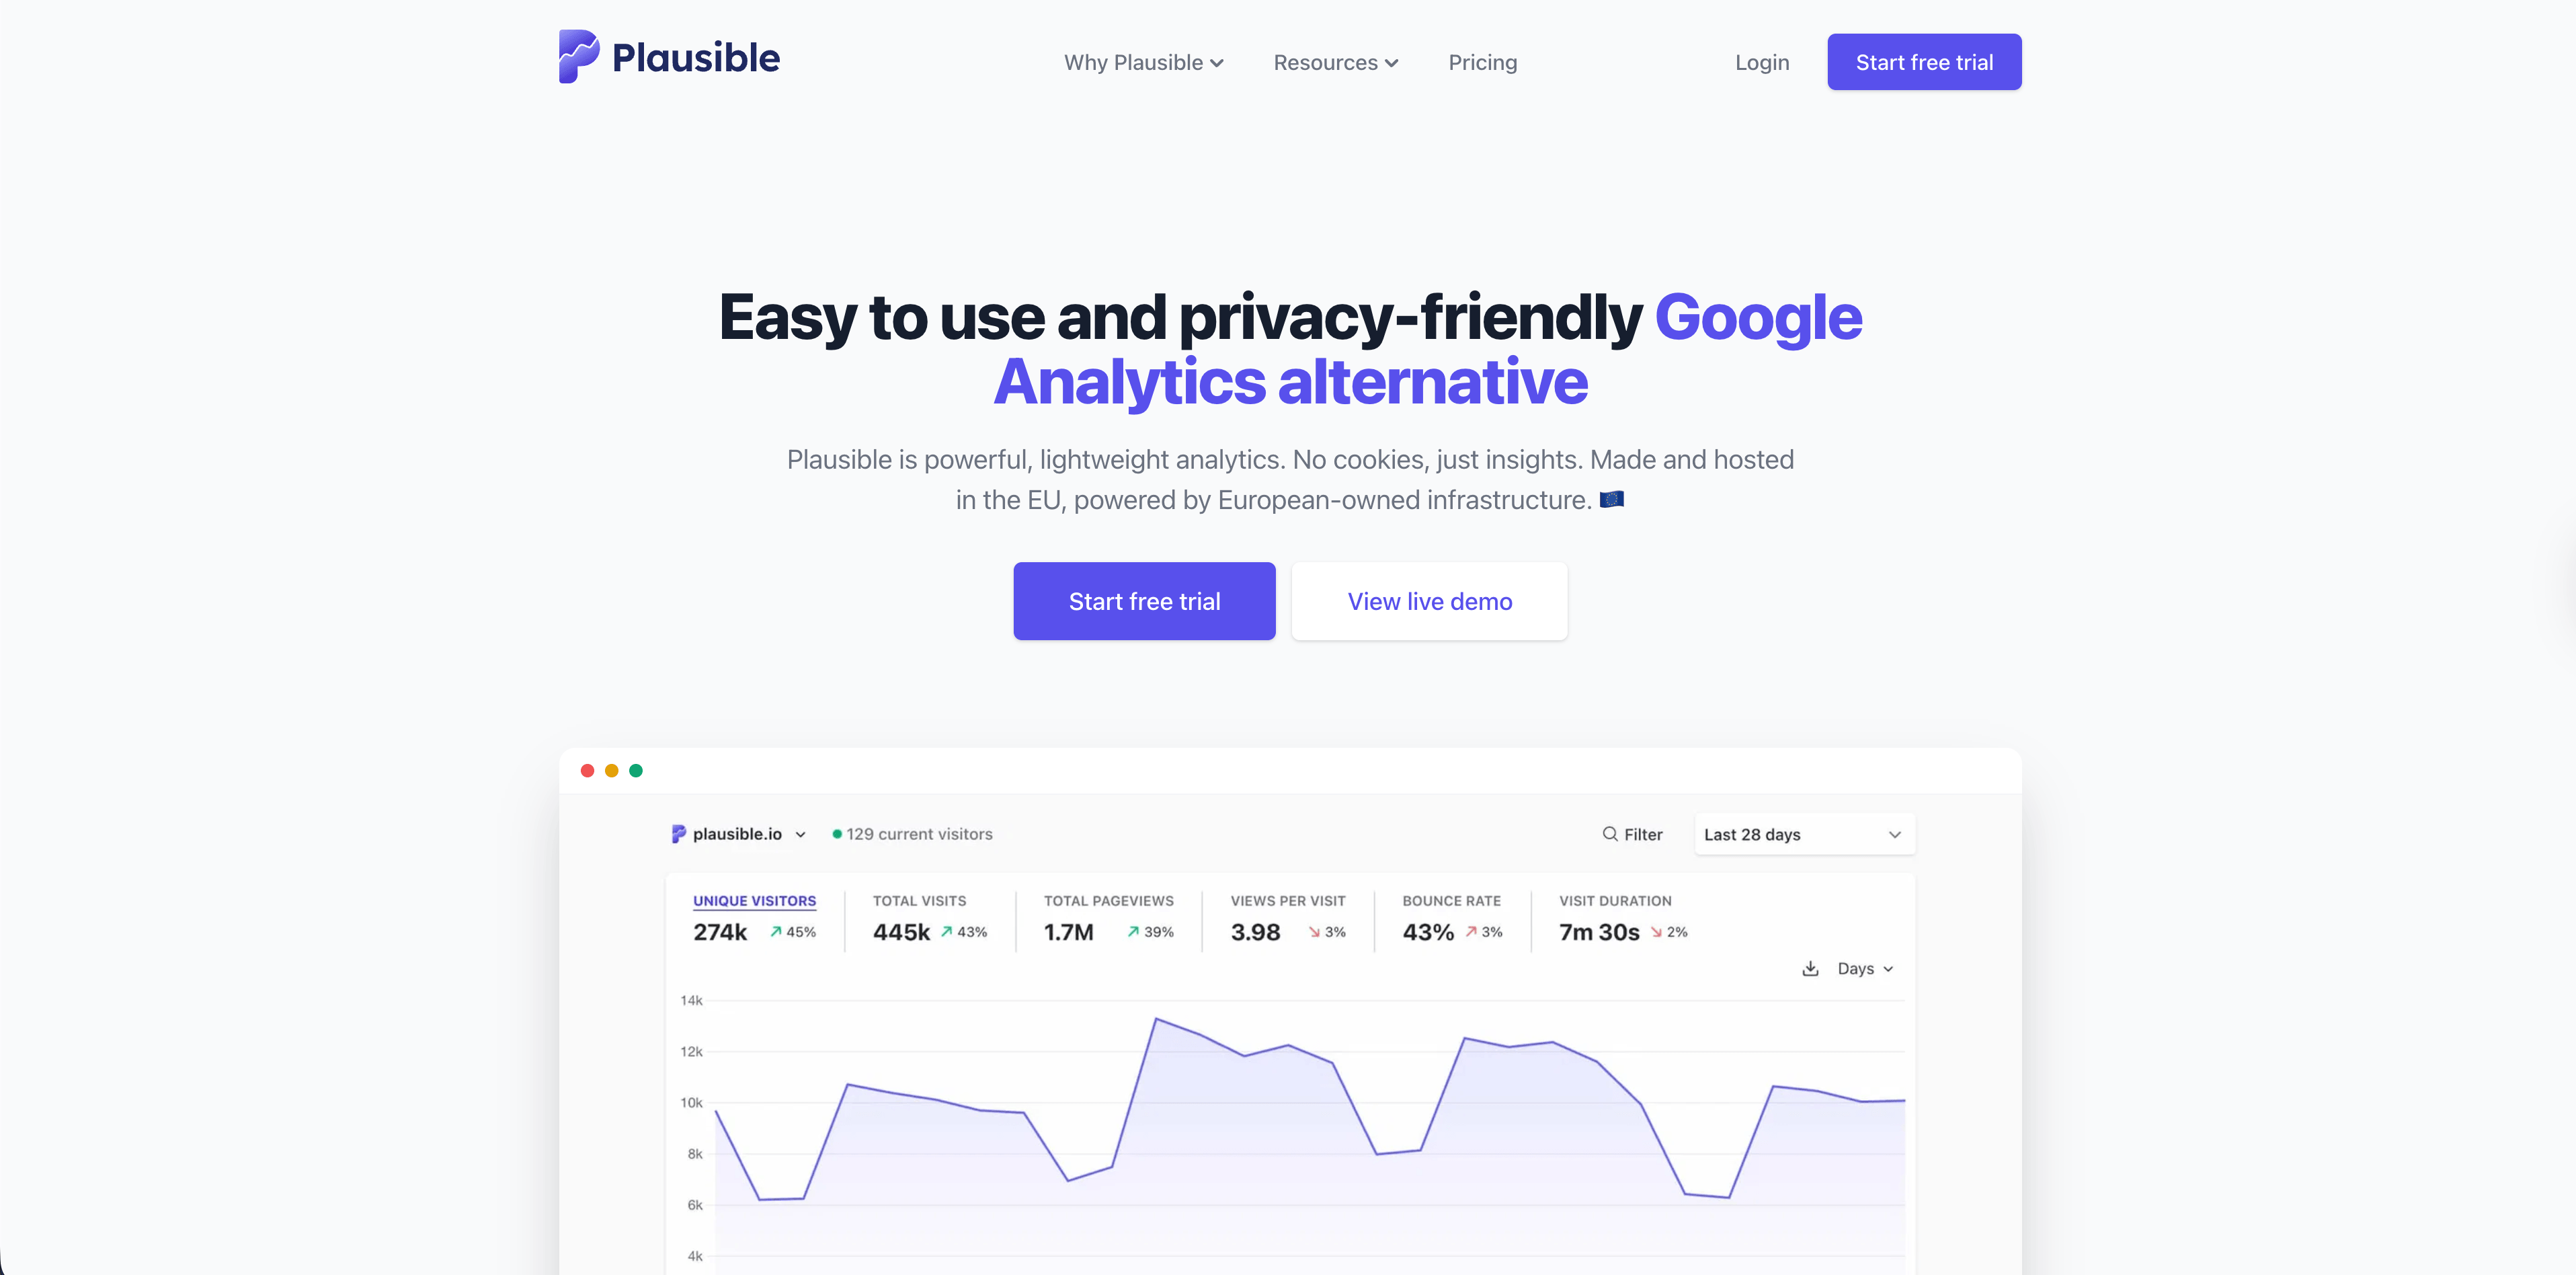
Plausible é uma escolha forte para relatórios simples e privacy-friendly de website. O site público enfatiza script leve, dashboard de uma página, sem cookies, hospedagem na UE, código open-source, integração com Search Console, metas, revenue tracking, funis, atualizações em tempo real e bot filtering.
Plausible faz sentido quando a equipe precisa principalmente de tráfego agregado, fontes, páginas, campanhas e metas. Ele é menos um pipeline server-side de conversão e mais uma camada limpa de relatórios para websites que não querem a complexidade do GA4.
3. Fathom
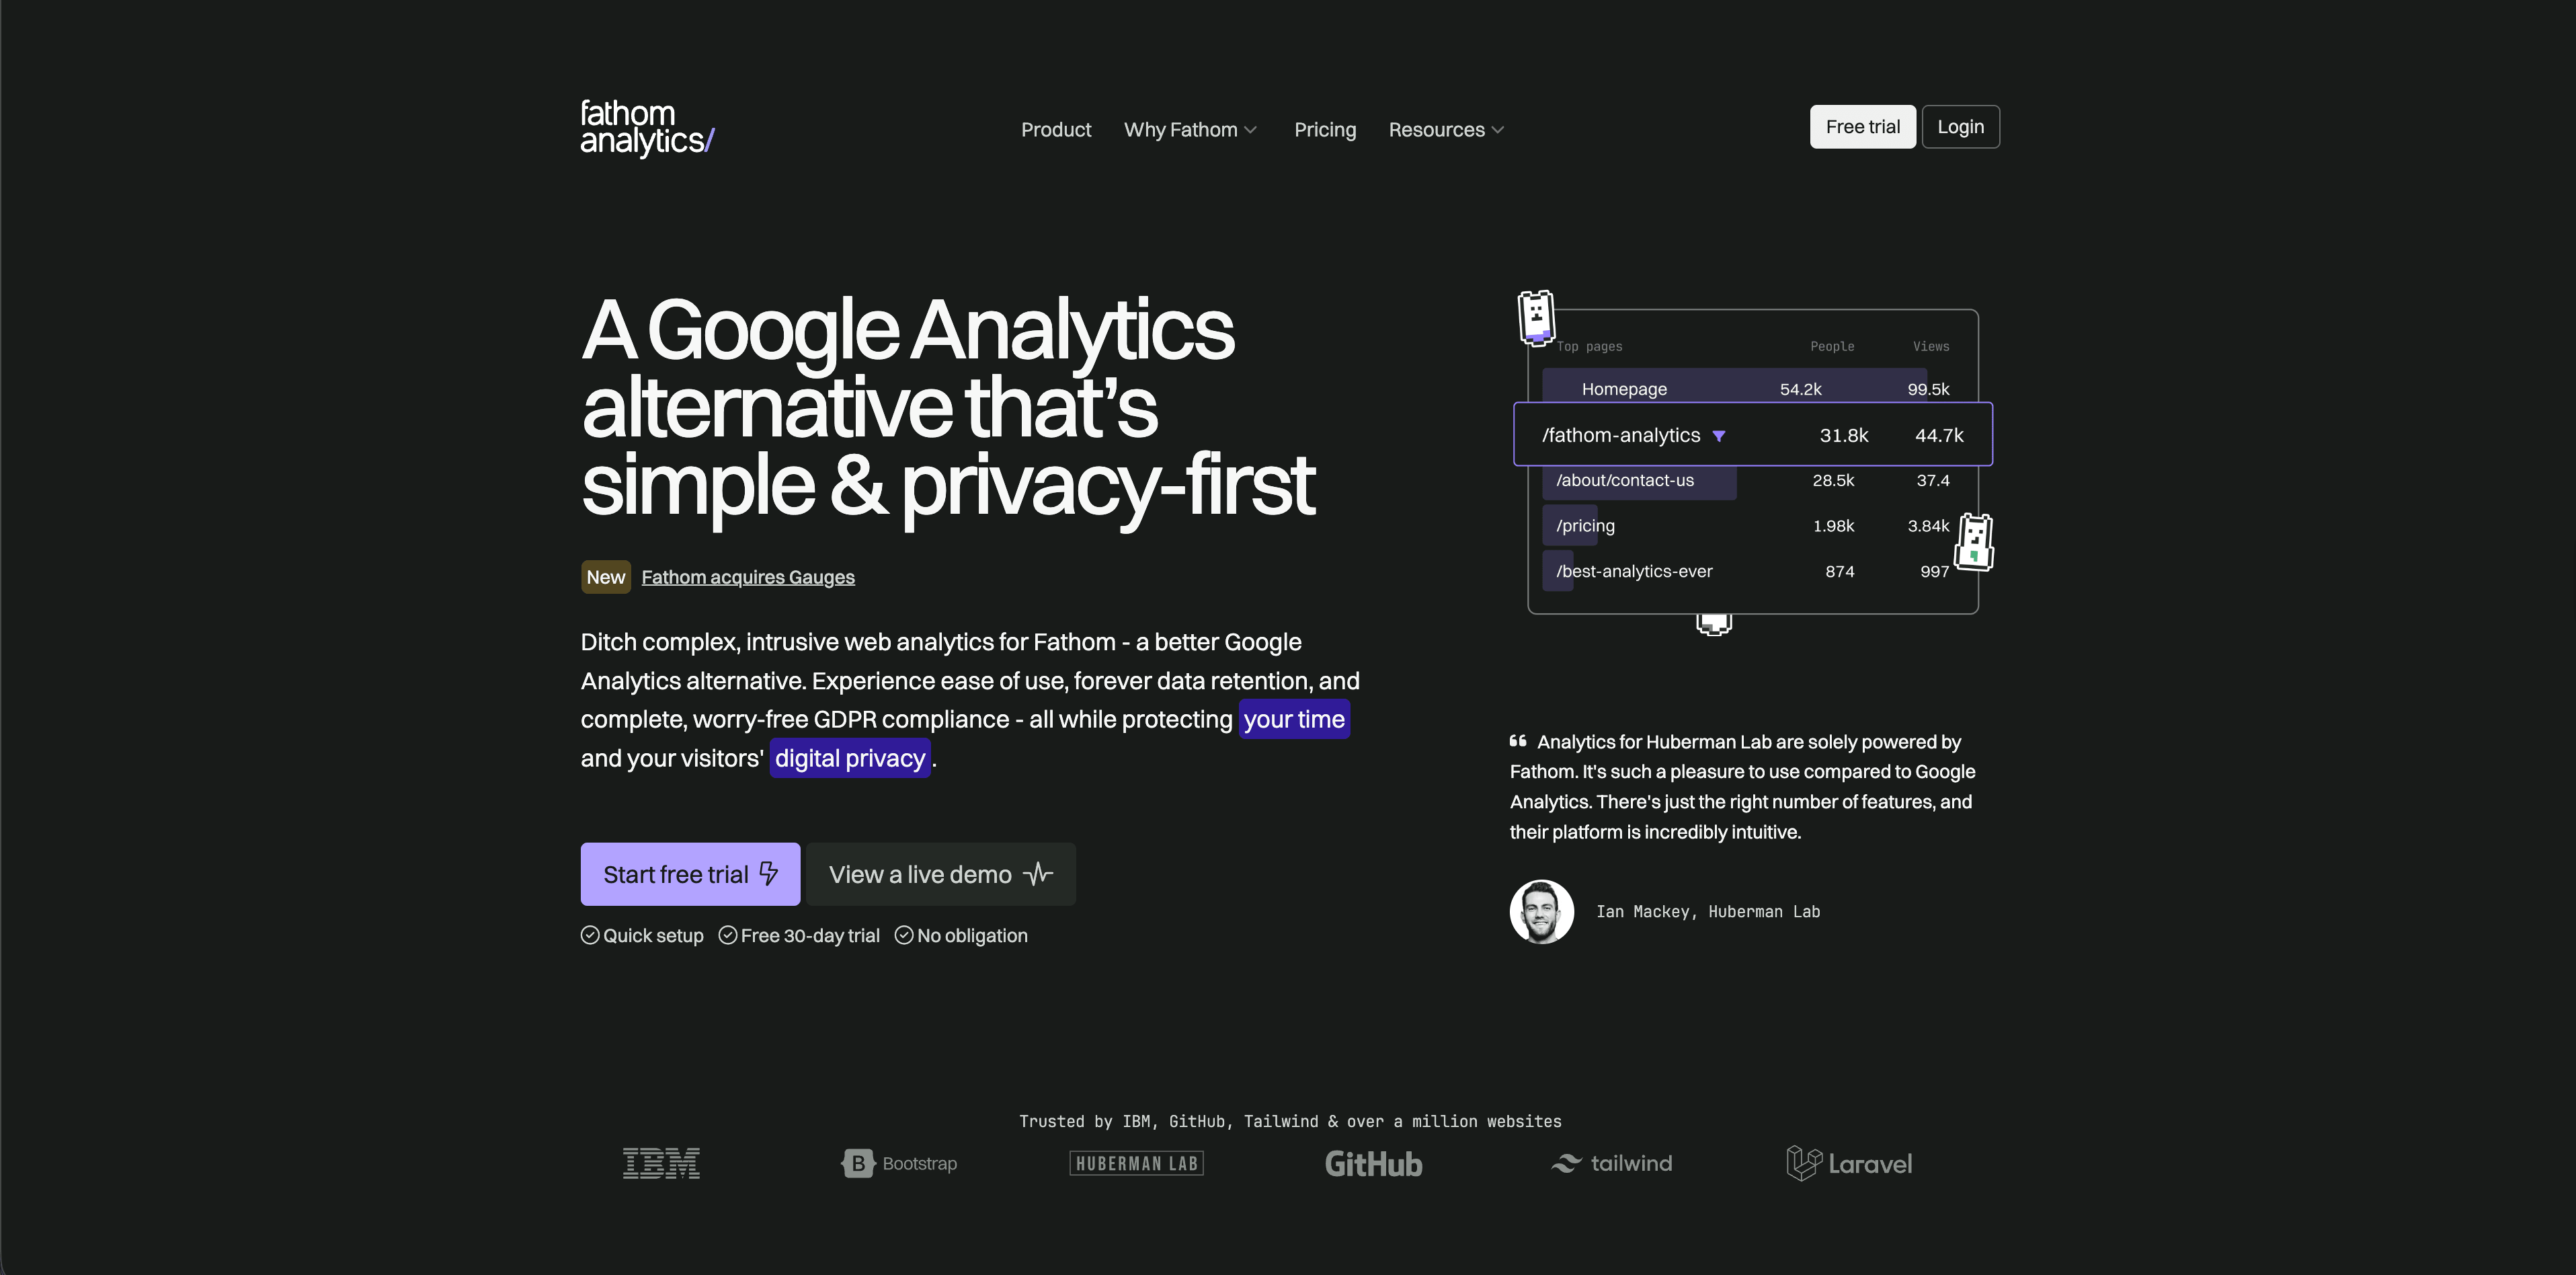
Fathom é construído em torno de analytics focada em privacidade e de baixa manutenção. As páginas públicas e de preços enfatizam relatórios simples, event tracking, ecommerce tracking, API access, exportações de dados, relatórios por email e retenção de longo prazo.
Fathom é bom quando o trabalho é "dar números limpos de website para stakeholders sem transformar analytics em projeto". Ele não substitui um setup customizado de atribuição server-side, mas muitas equipes pequenas não precisam disso no dia um.
4. Simple Analytics
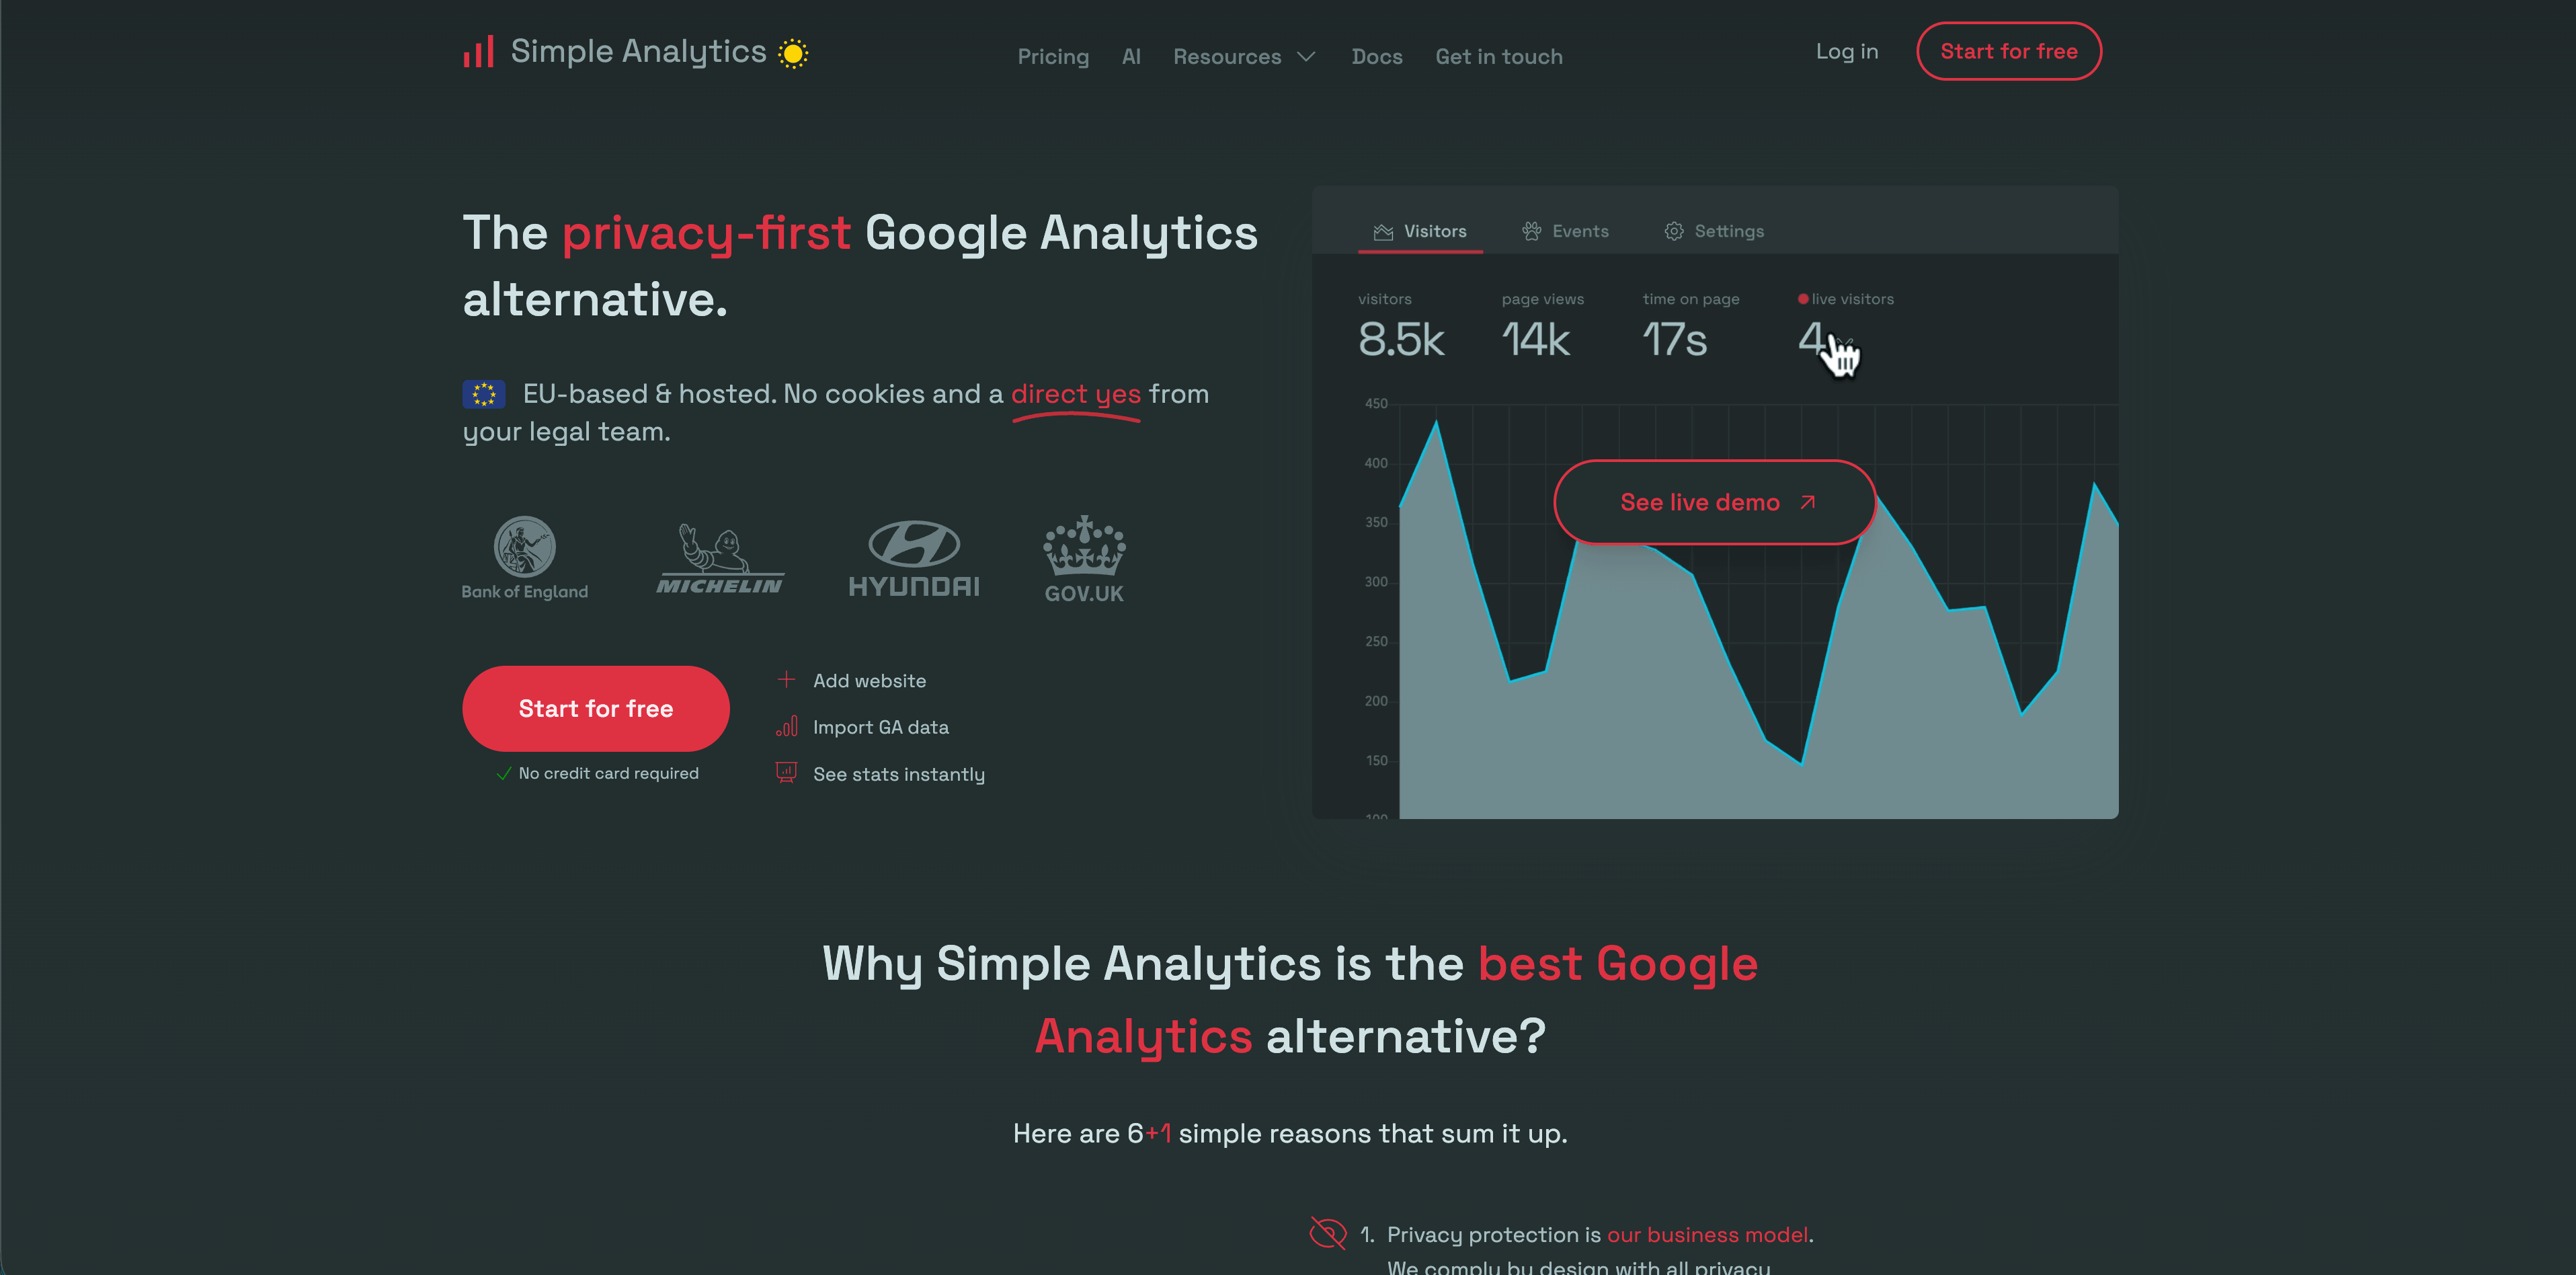
Simple Analytics tem uma das posições de privacidade mais claras da categoria. O site público descreve sem cookies, sem coleta de dados pessoais, sem fingerprinting, hospedagem de dados na UE, eventos, metas, exportações e opções de ad-blocker bypass em alguns planos.
Escolha Simple Analytics quando você quer relatórios agregados mínimos e prefere coletar menos dados a explicar um setup complexo de tracking.
Painel em tempo real
Rastreamento de metas
Rastreamento sem cookies
5. Pirsch
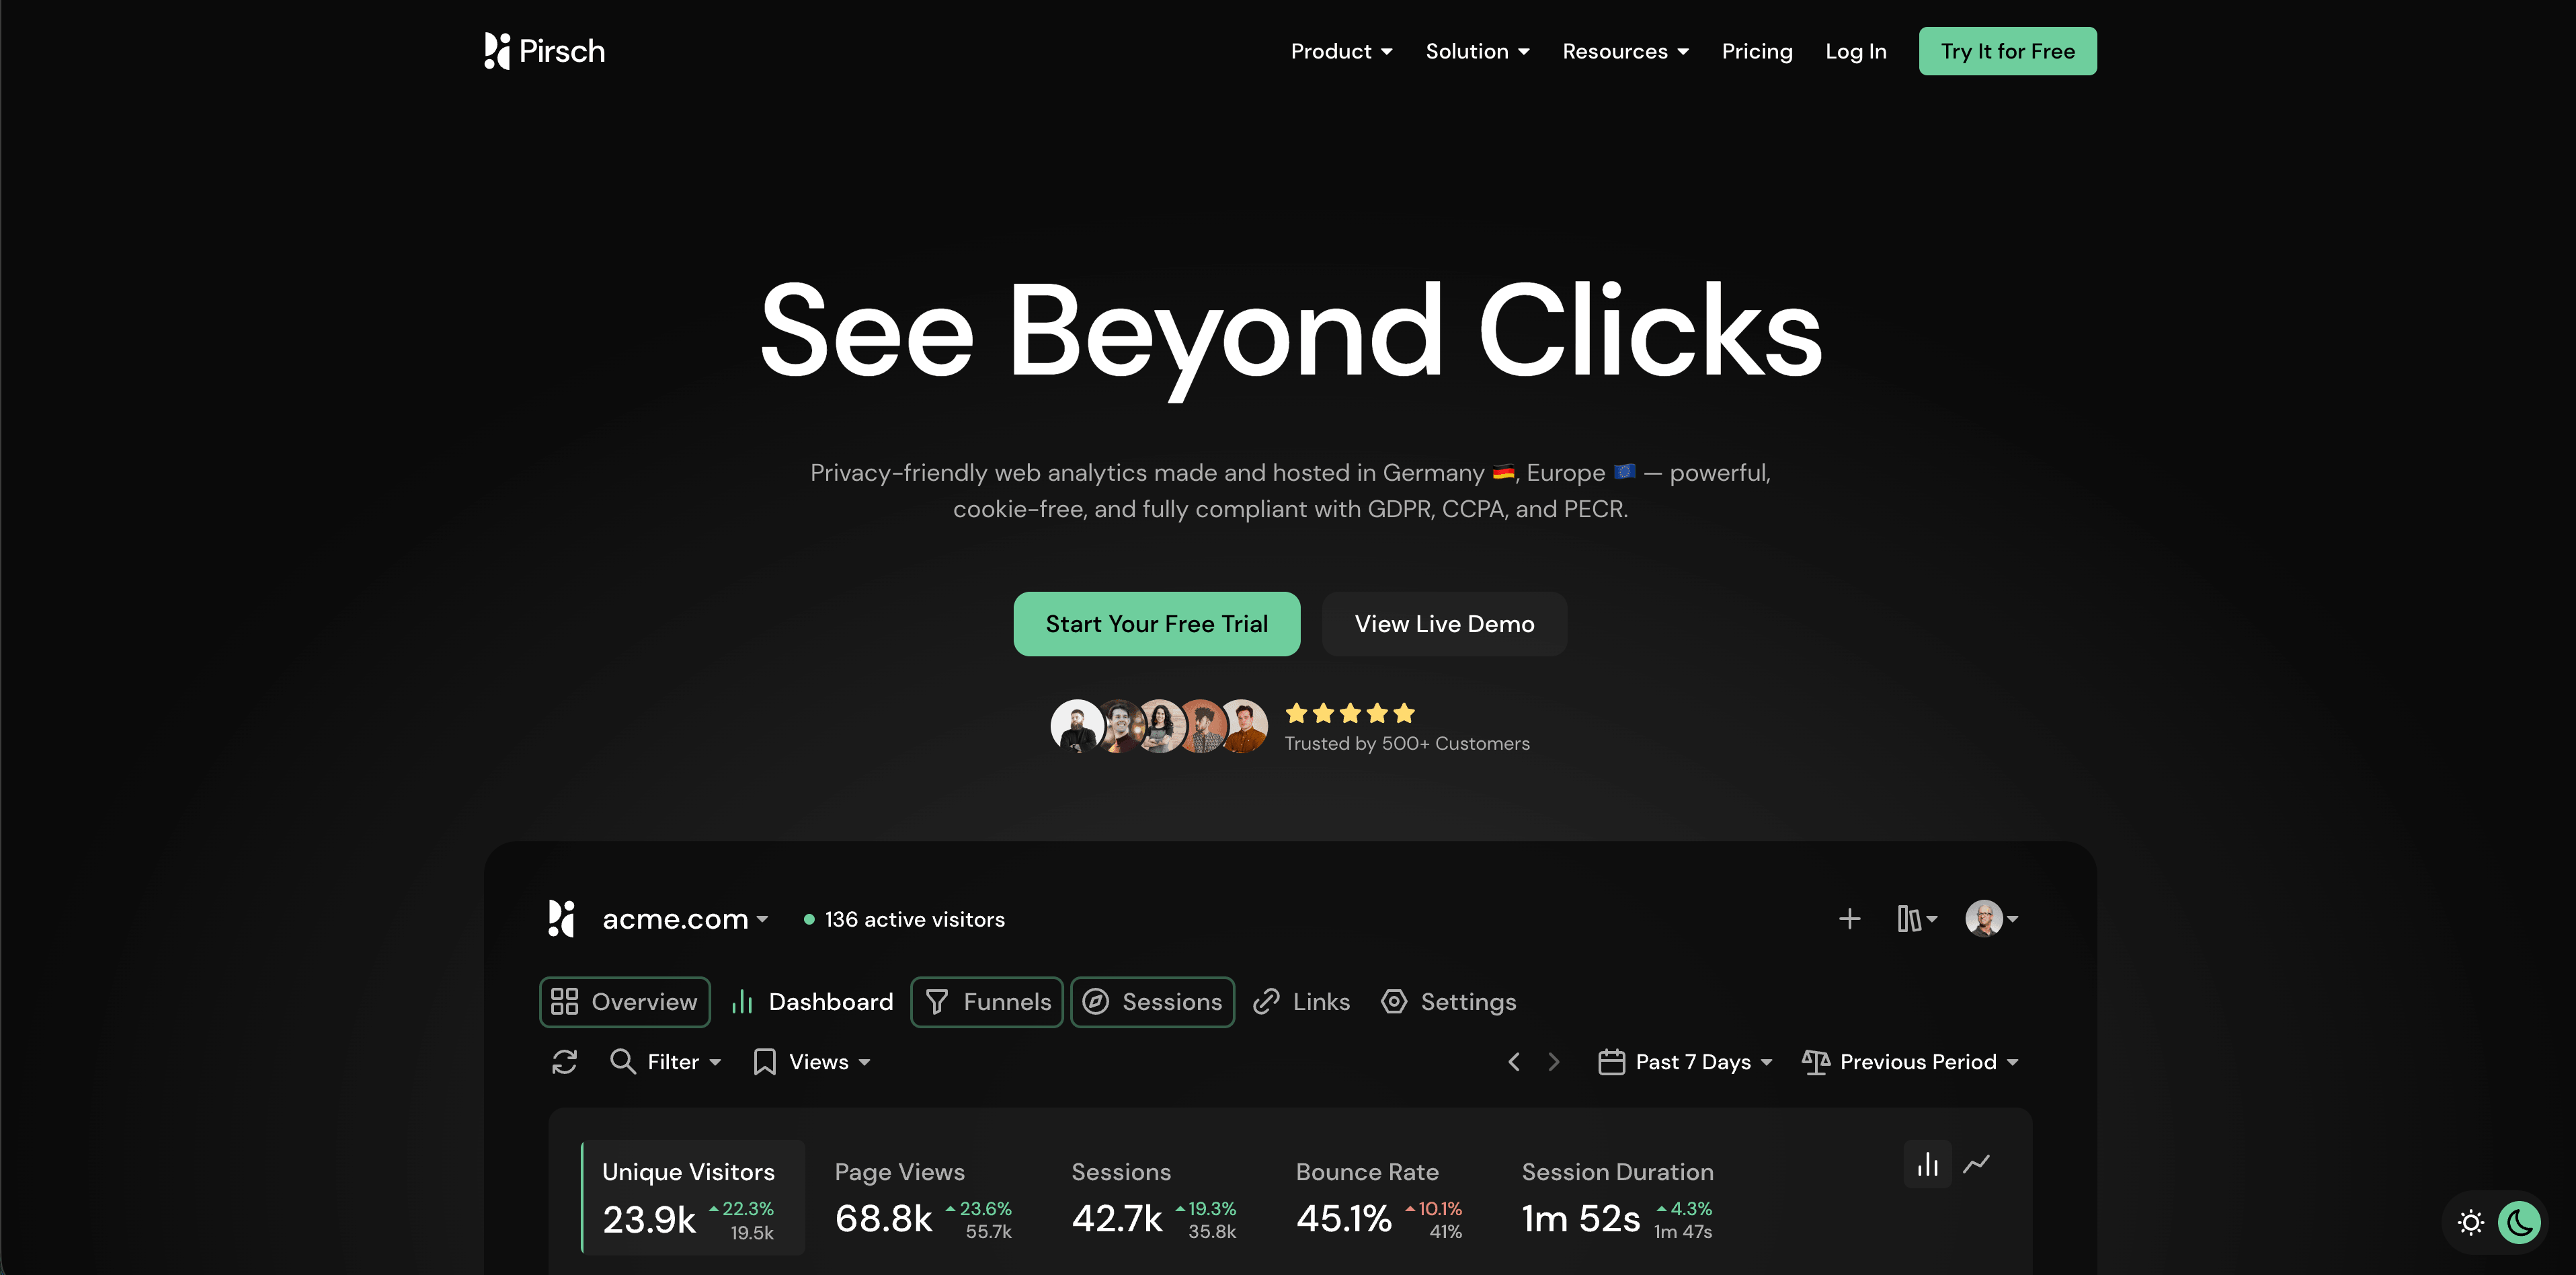
Pirsch é um produto de analytics privacy-friendly com forças para developers e agências. O pricing público descreve eventos, conversion goals, session analysis, REST API e SDKs, GDPR compliance, propriedade de dados, funis, times, white labeling, custom domains e opções on-premise em tiers superiores.
Pirsch vale avaliar quando você precisa de dashboards para clientes, APIs, relatórios white-label ou mais controle técnico do que as ferramentas de analytics mais simples entregam.
6. Matomo
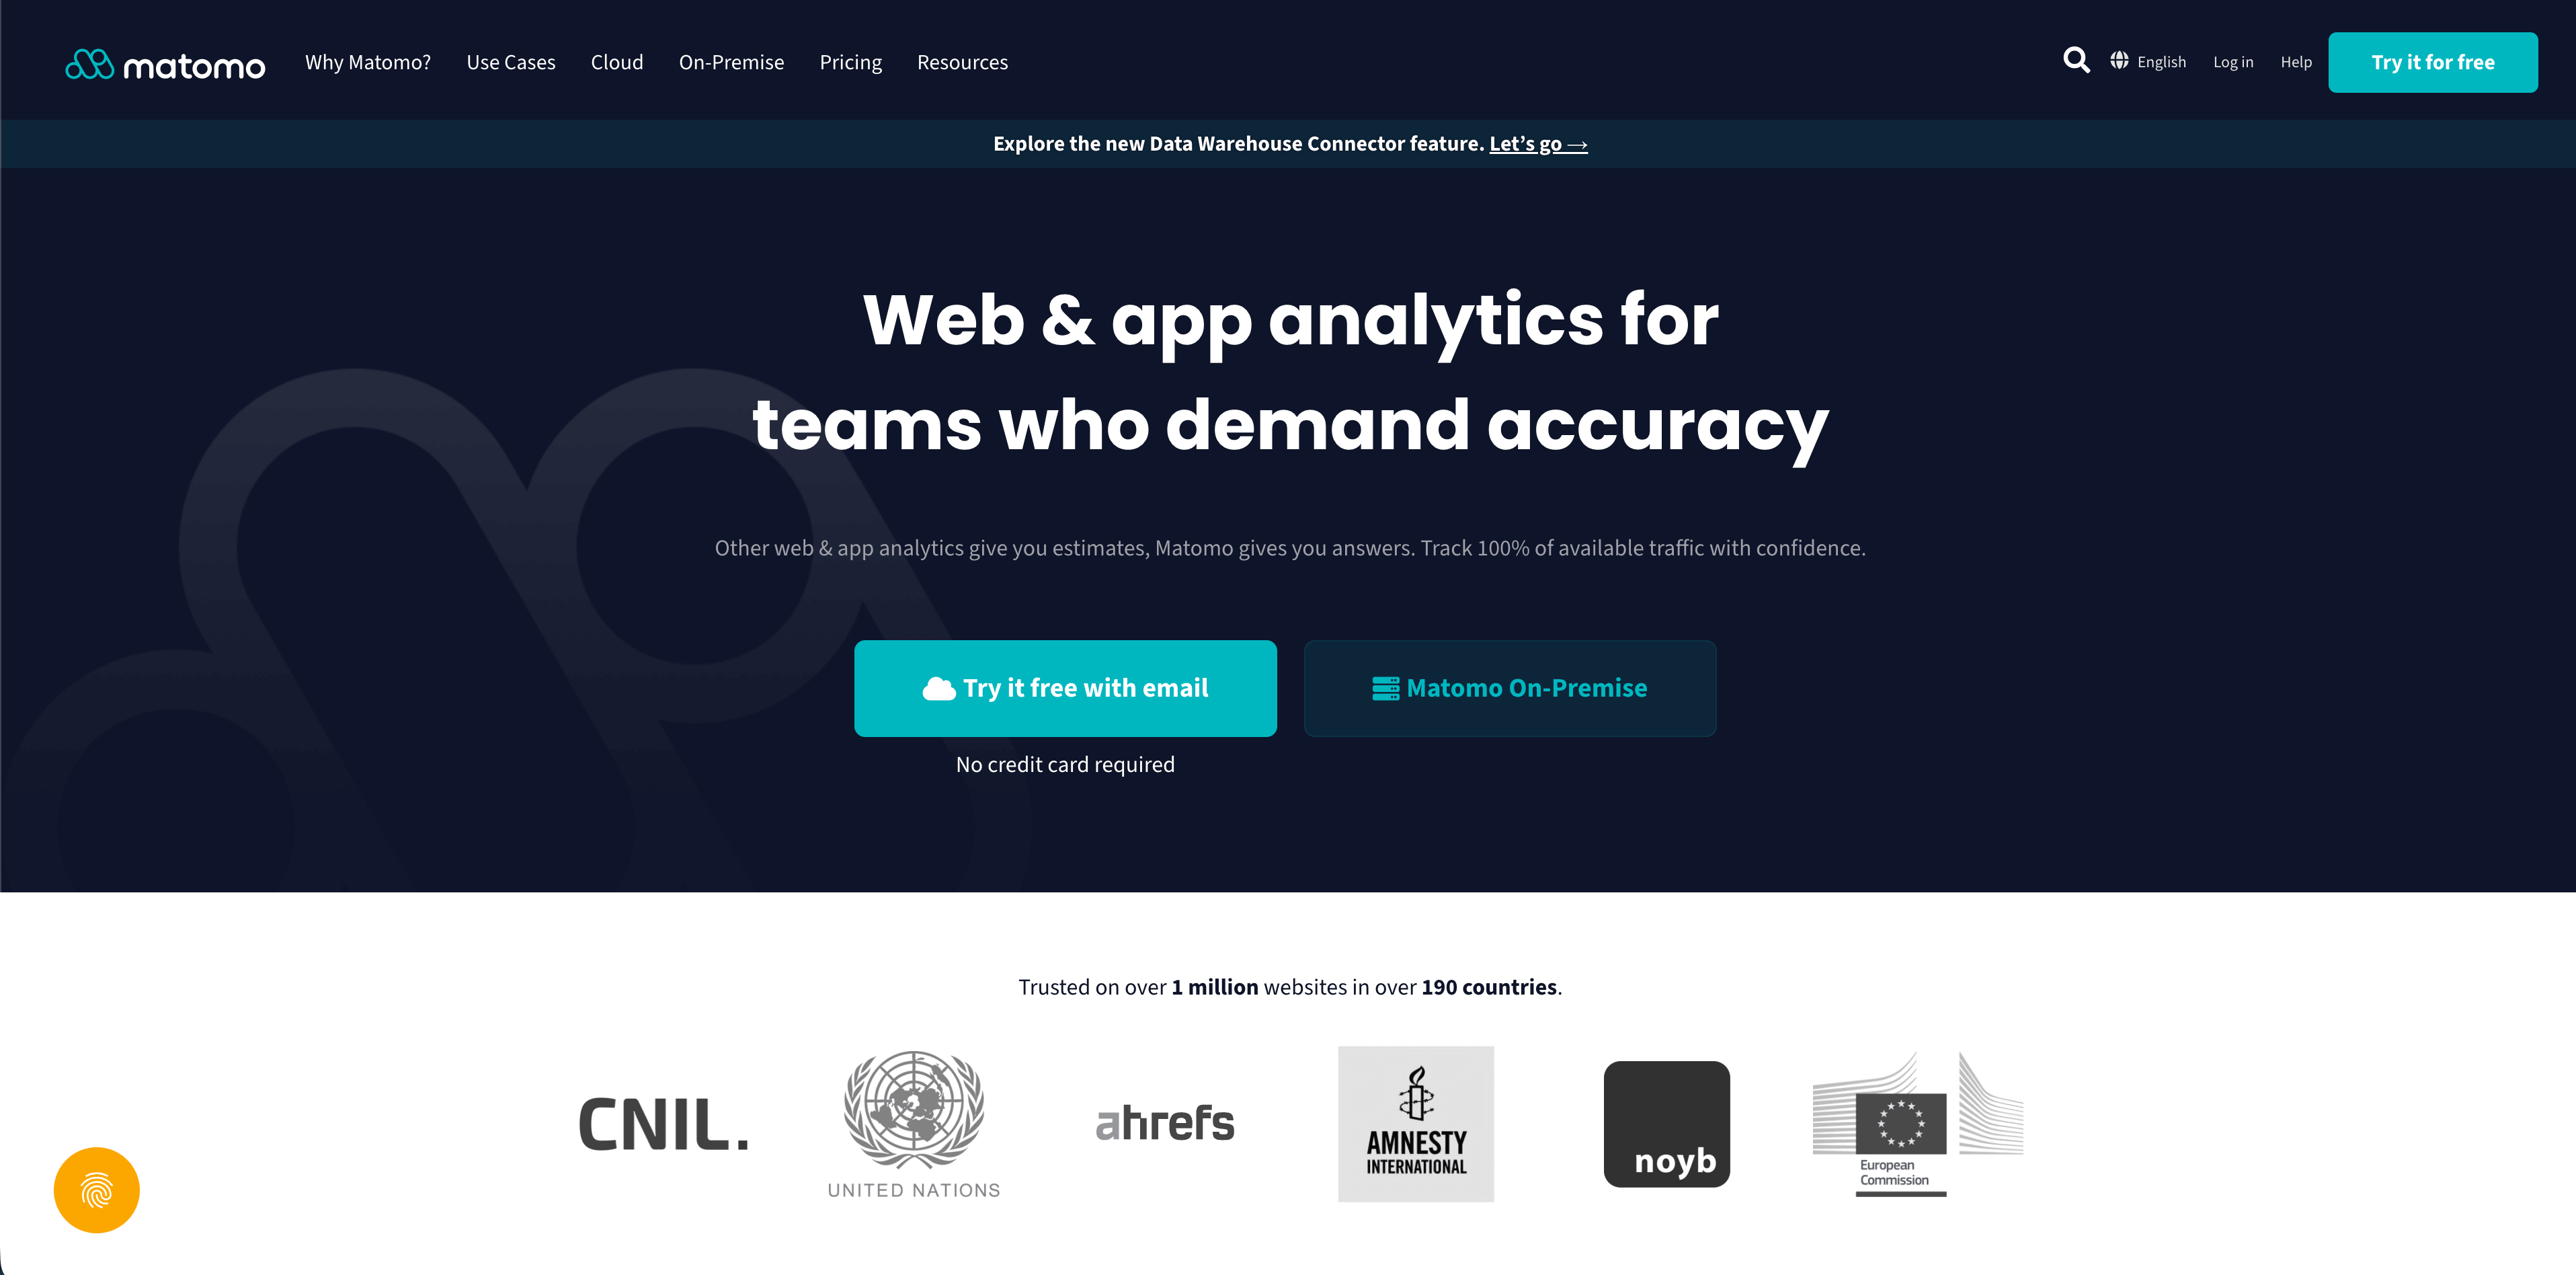
Matomo é a opção tradicional de web analytics mais ampla aqui. Ele oferece produto cloud hospedado e edição on-premise self-hosted grátis, com recursos como campanhas, ecommerce, eventos, metas, segmentos, dashboards, mapas de visitantes, relatórios agendados, APIs e marketplace de plugins.
Matomo é um bom encaixe quando controle, propriedade de dados e self-hosting importam mais que simplicidade de setup. Também pode ficar mais perto de governança server-side quando uma organização quer operar a própria camada de analytics.
7. Umami
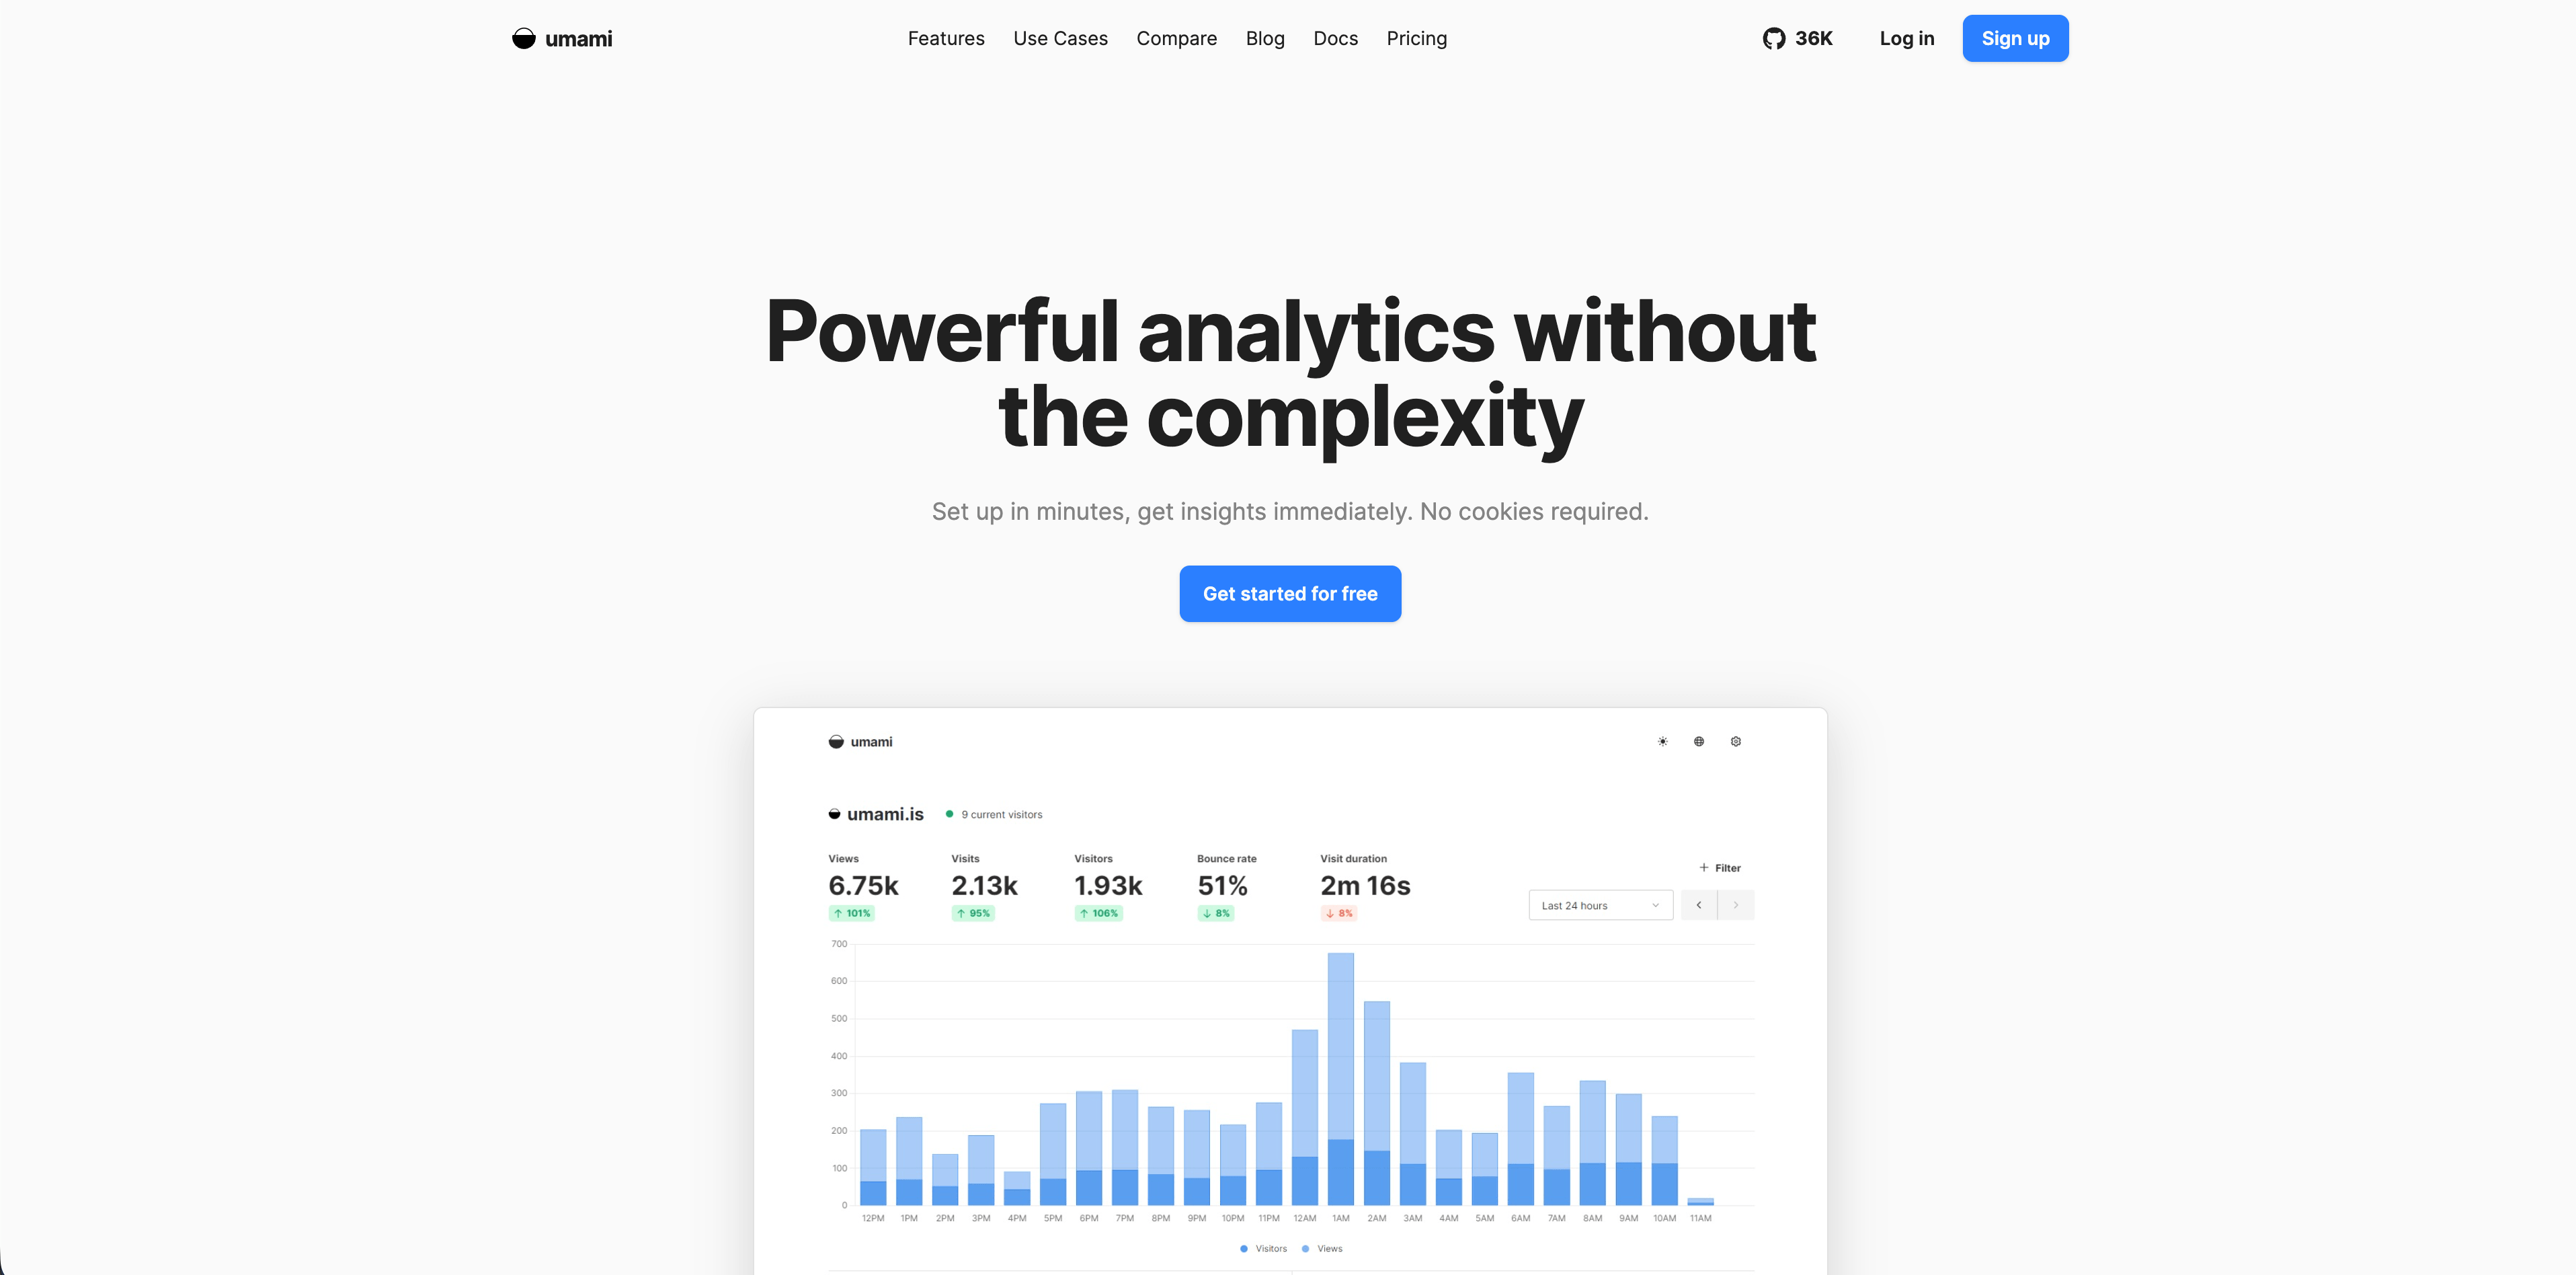
Umami é web analytics open-source com caminhos self-hosted e cloud. A documentação descreve sem cookies, sem cross-site tracking, sem coleta de dados pessoais, eventos customizados, funis, jornadas, retenção, relatórios UTM, receita, atribuição e dashboards.
Umami funciona bem para equipes técnicas que querem uma stack de analytics simples e open-source e estão confortáveis em assumir algumas decisões de implementação.
8. Seline
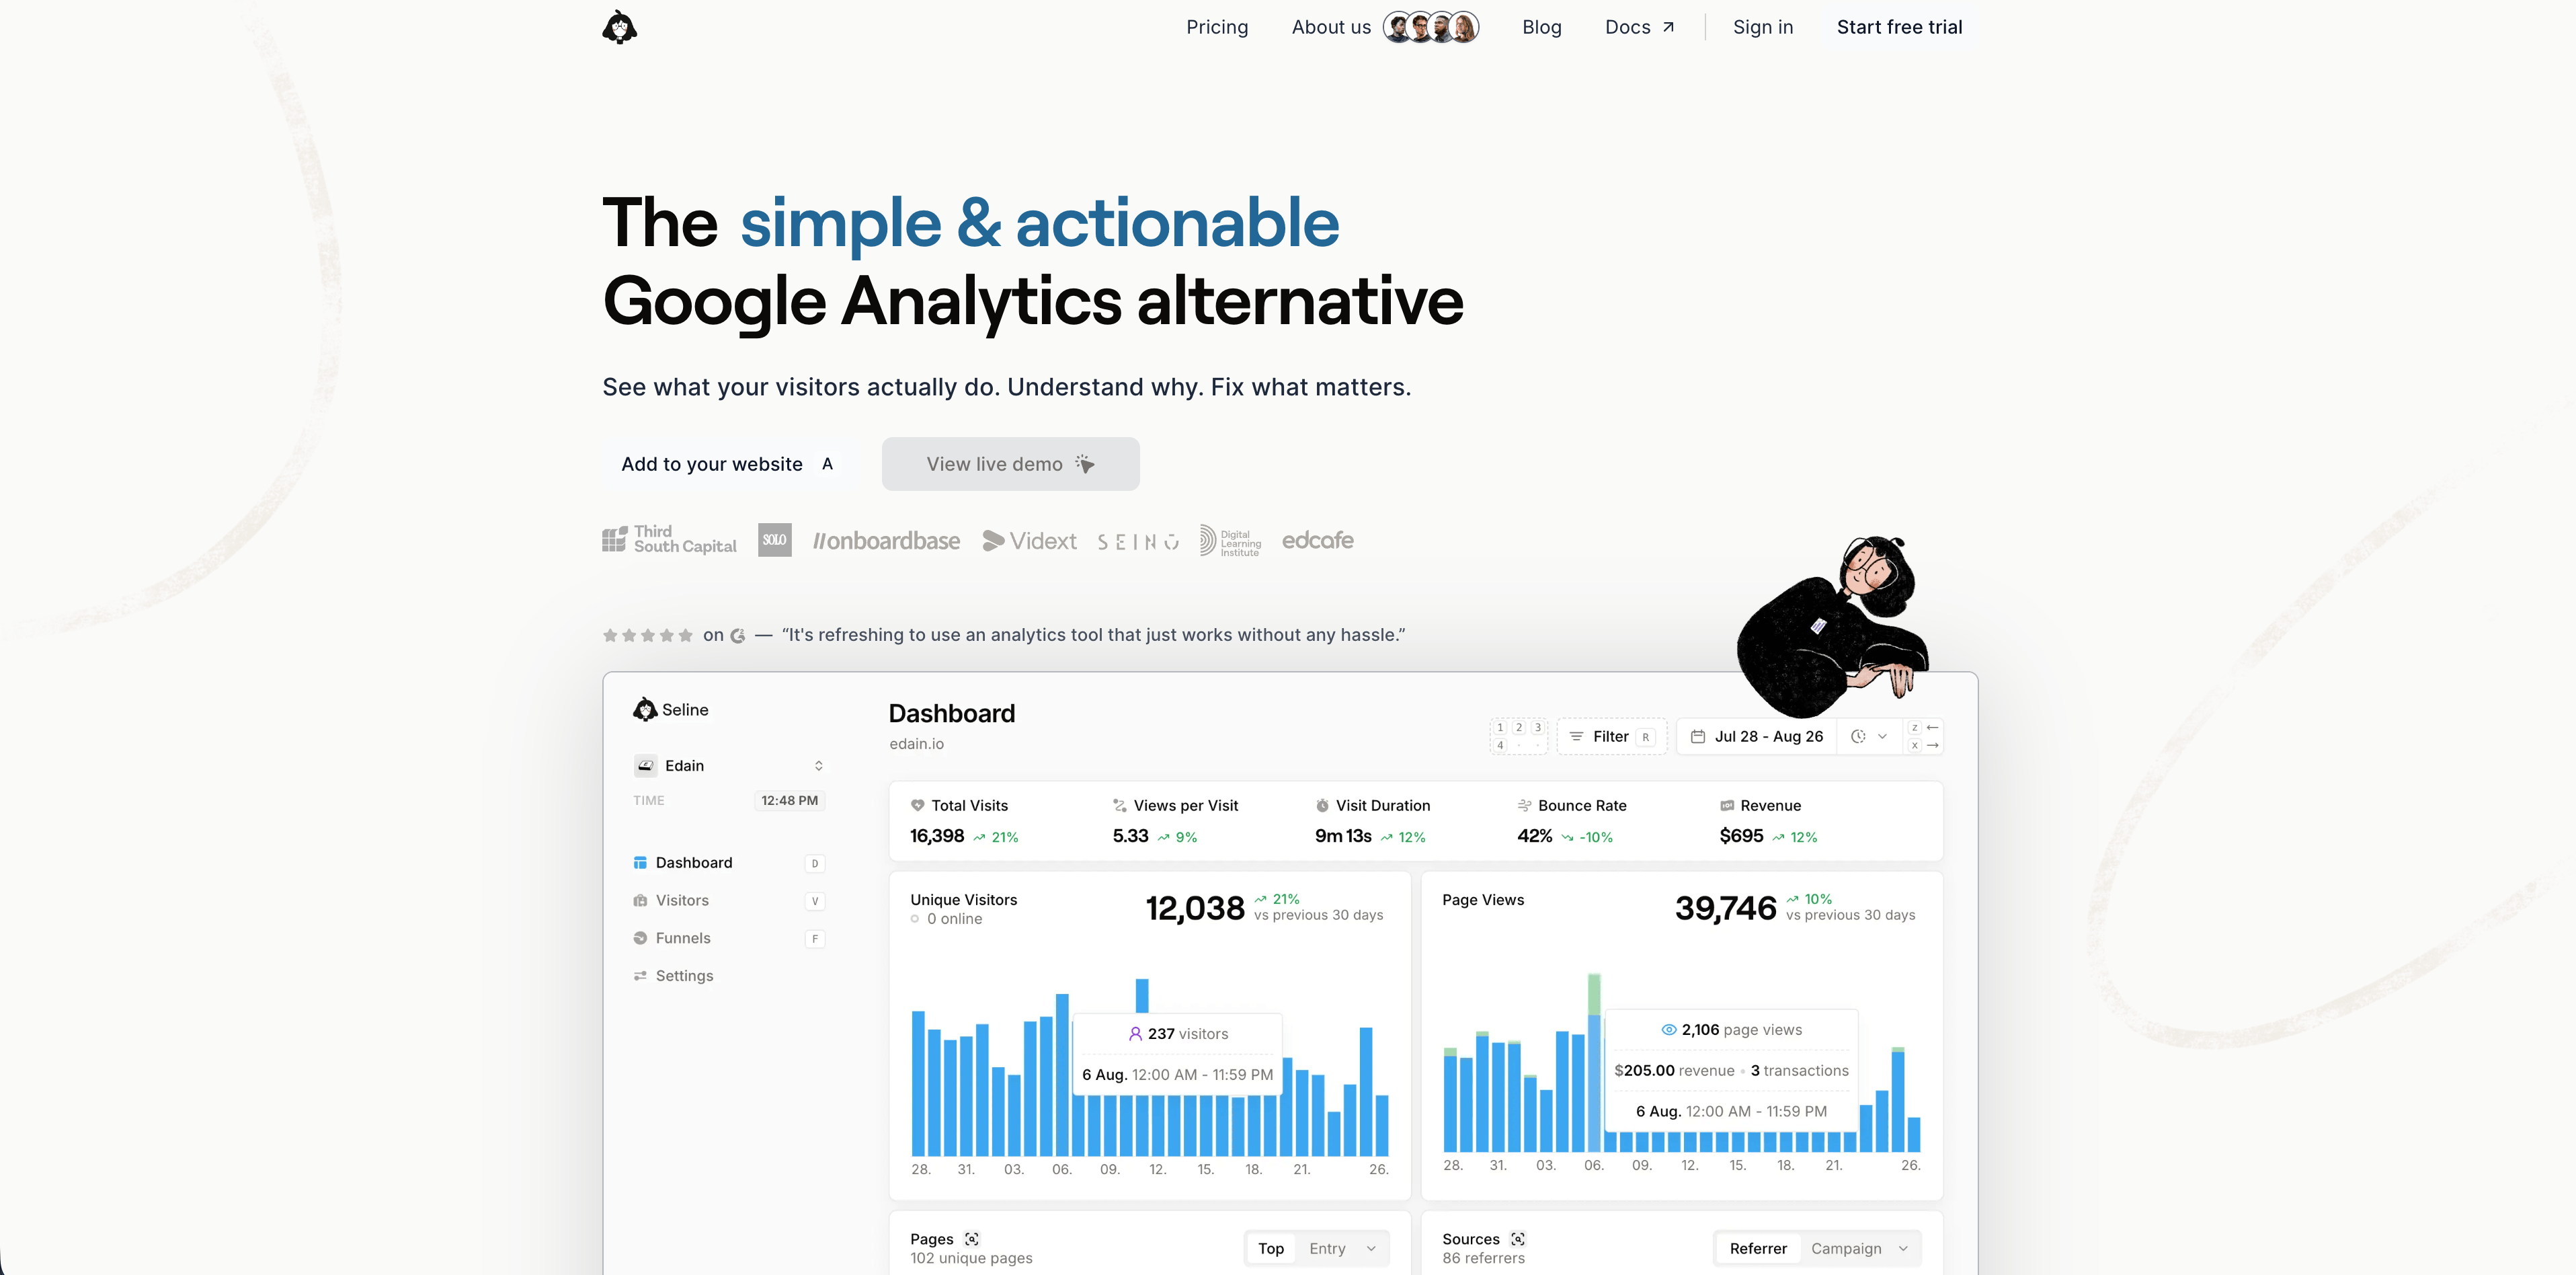
Seline fica entre website analytics simples e product analytics leve. O site público descreve um snippet pequeno, website analytics, visitor journeys, profiles, funnels, AI chat, revenue tracking, attribution, bot detection e hospedagem na UE na Alemanha.
Seline vale olhar quando você quer mais contexto operacional diário do que um dashboard de tráfego, especialmente em jornadas, perfis, funis e receita.
9. DataFast
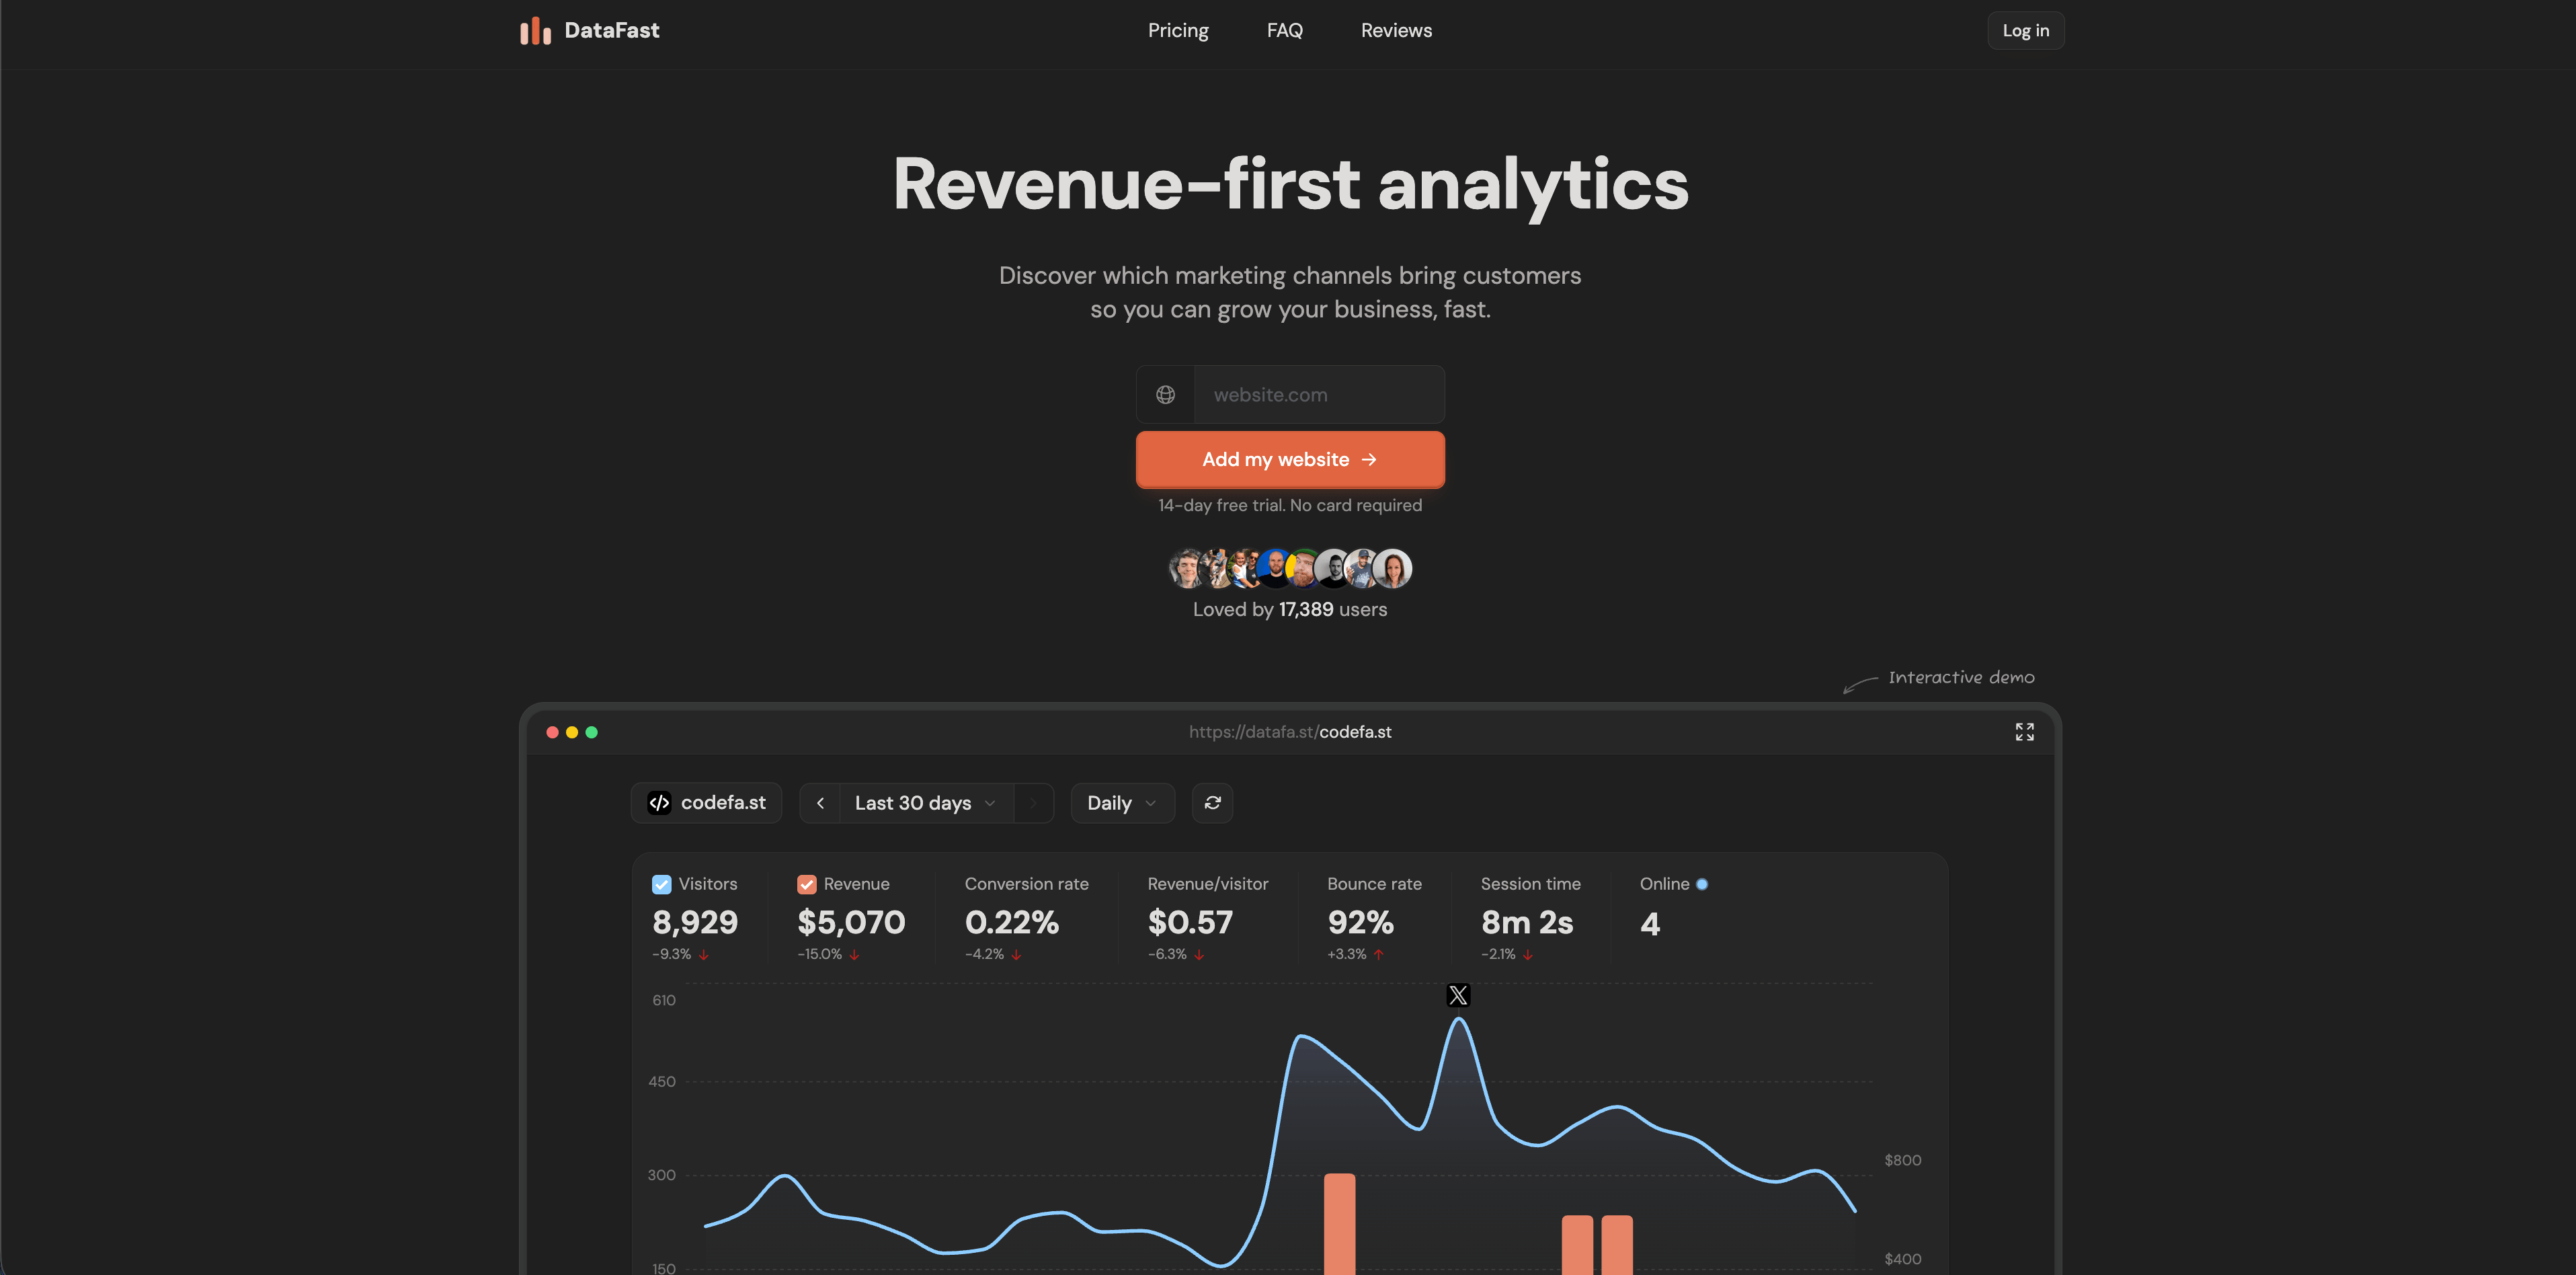
DataFast é analytics revenue-first para makers e pequenas equipes SaaS. O site público destaca script muito pequeno, sem cookies por padrão, sem dados pessoais armazenados, posicionamento GDPR compliance, relatórios em tempo real, integrações de receita, self-hosting com Docker Compose e franquia mensal gratuita de eventos.
DataFast é mais relevante quando a primeira pergunta é qual fonte produz receita, não qual conteúdo gerou mais pageviews.
Painel em tempo real
Rastreamento de metas
Rastreamento sem cookies
10. PostHog
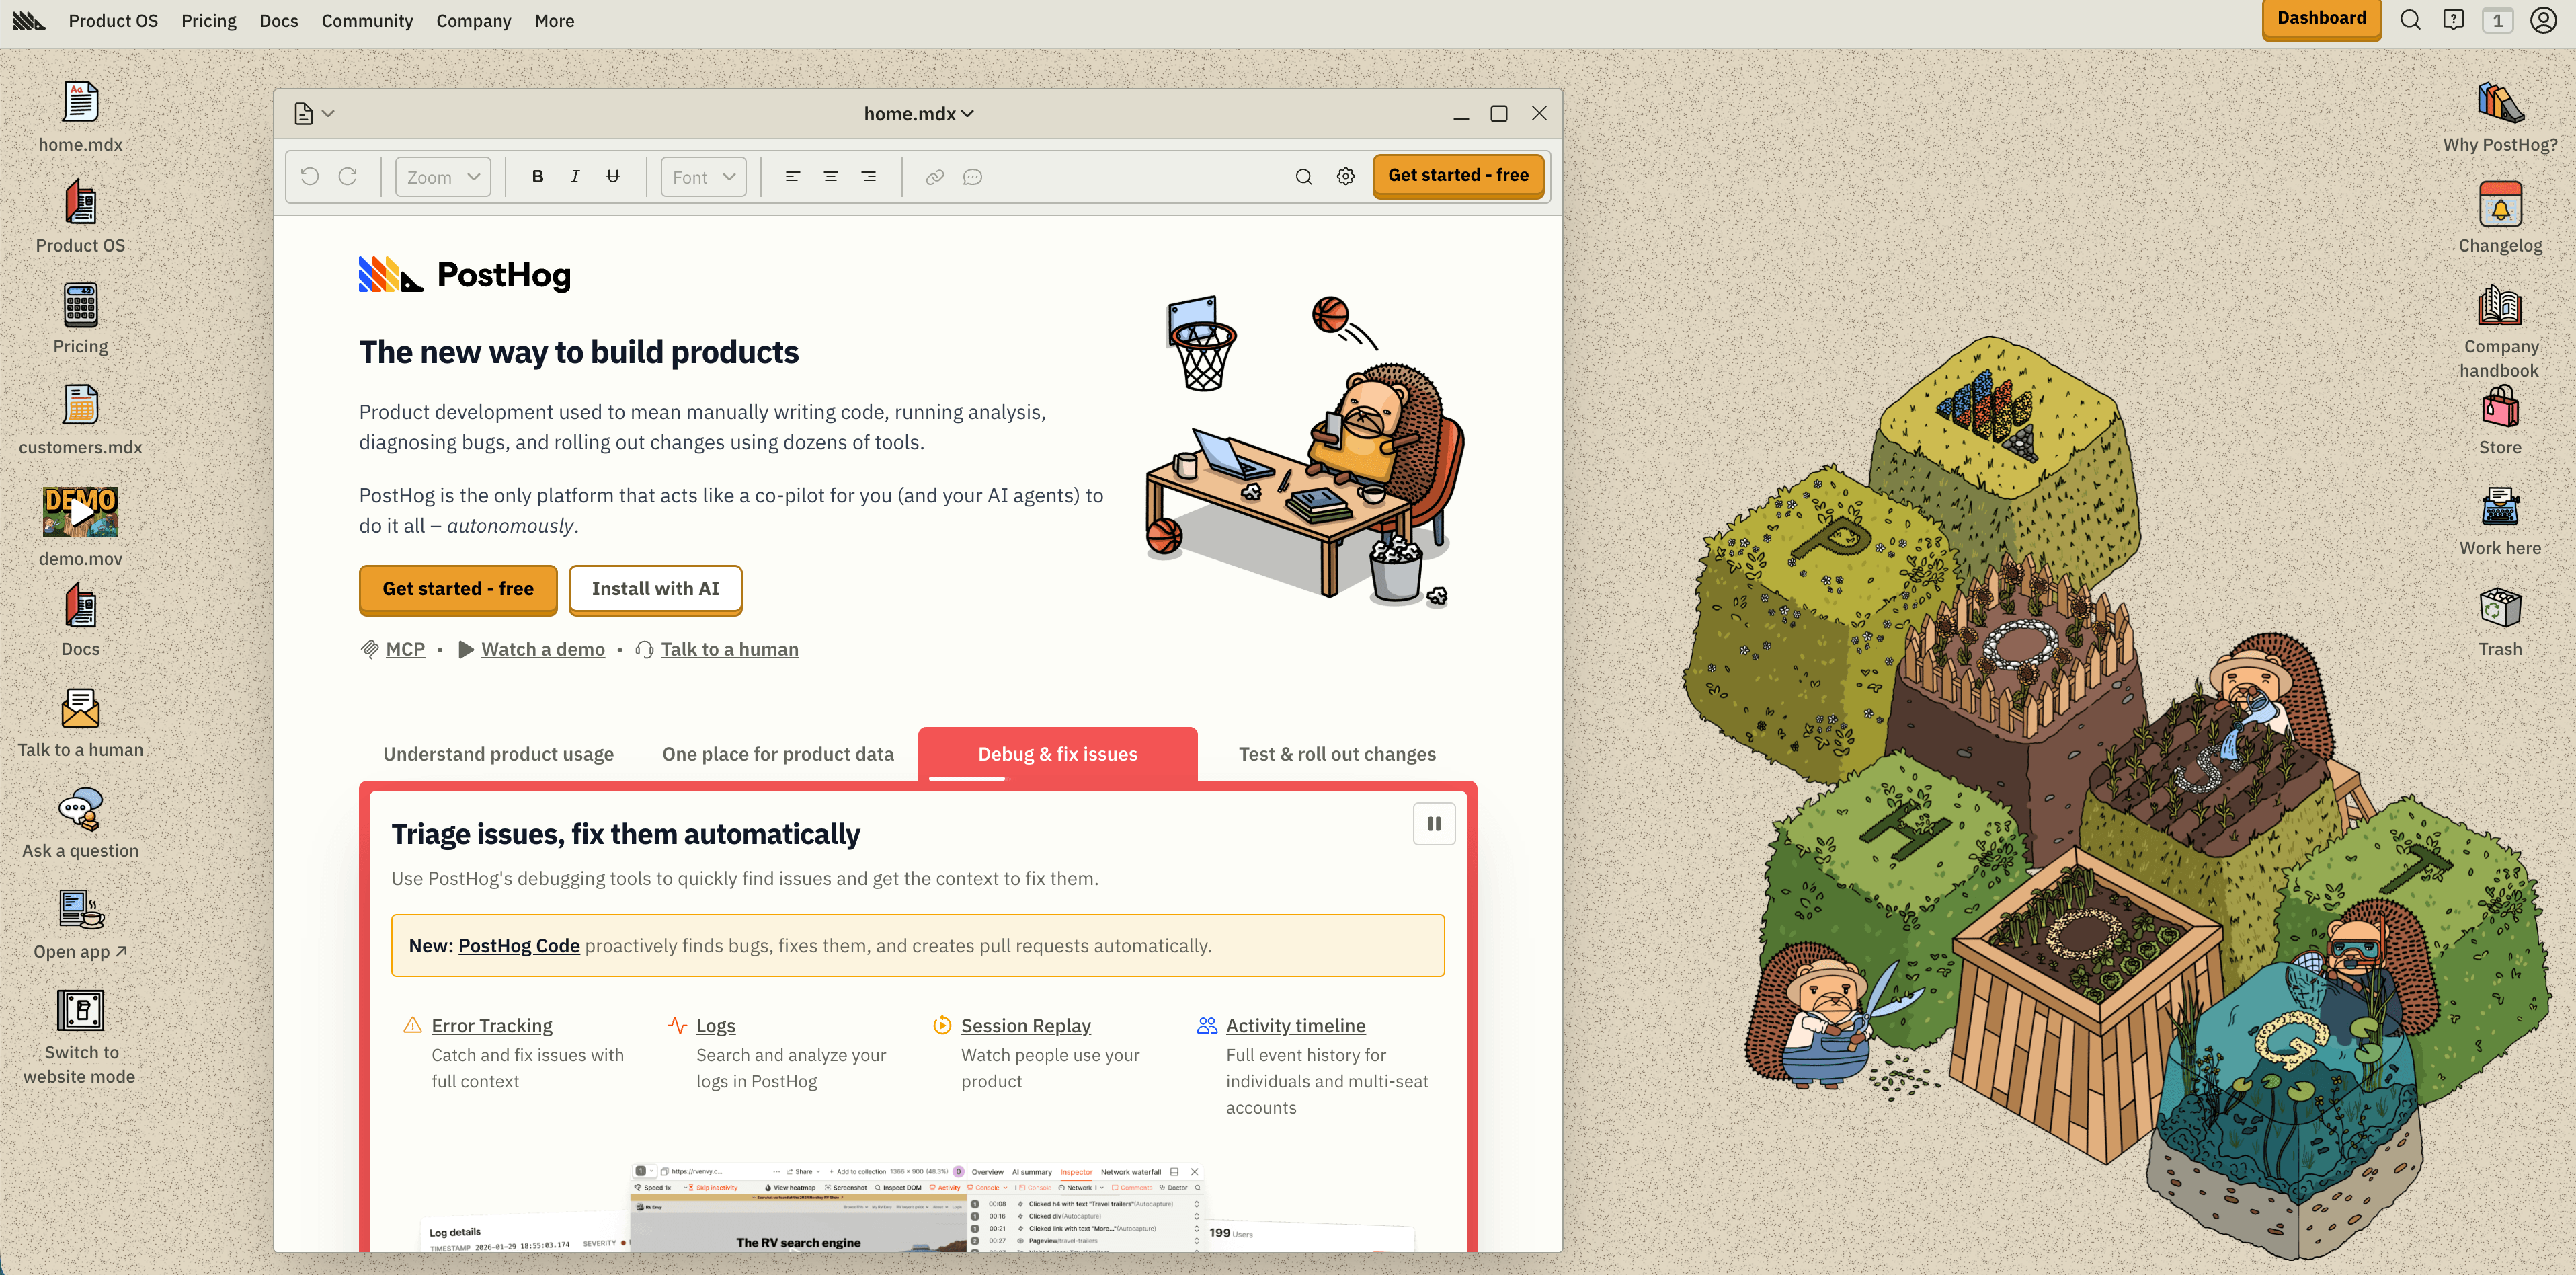
PostHog é muito mais amplo que website analytics. Sua superfície de produto inclui product analytics, web analytics, session replay, feature flags, experiments, surveys, workflows de data warehouse, pipelines, error tracking, logs, LLM analytics e recursos de AI.
PostHog é uma opção séria quando server-side tracking faz parte de um plano maior de instrumentação de produto liderado por engenharia. Pode ser demais se a equipe só quer um dashboard de website.
11. Mixpanel
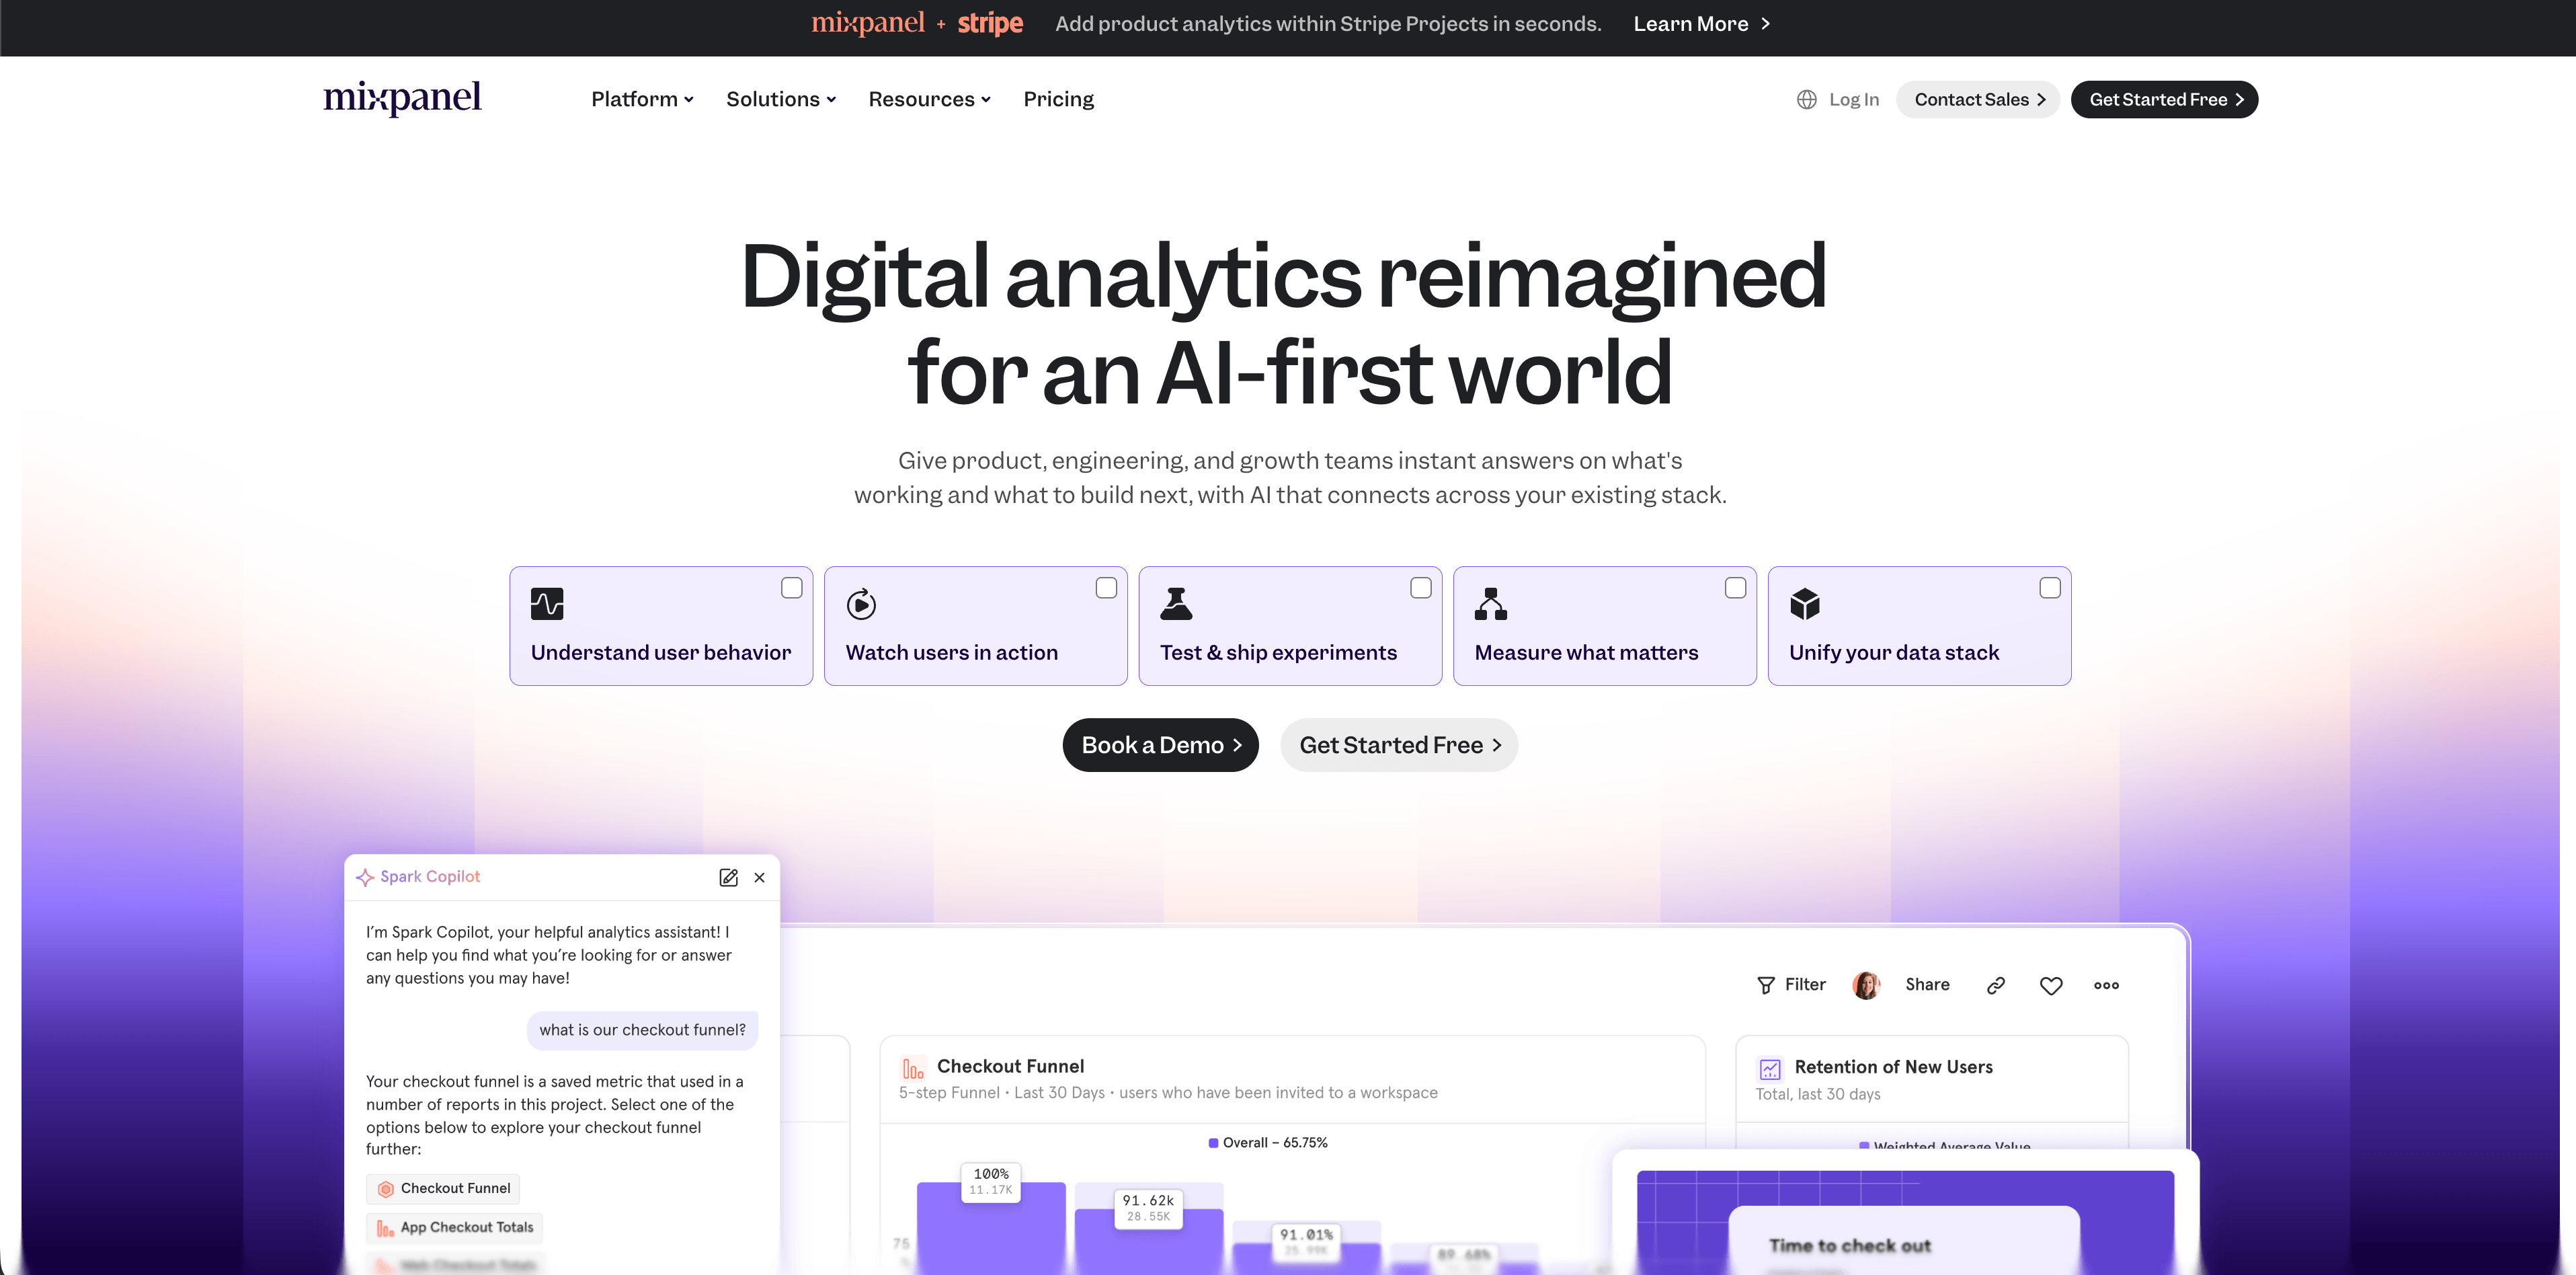
Mixpanel é uma plataforma madura de product analytics com superfícies para produto, web, mobile, experiments, metric trees, session replay e warehouse connectors. Ela é mais forte quando equipes têm uma taxonomia disciplinada de eventos e se importam com ativação, retenção, cohorts, flows e análise comportamental.
Mixpanel combina bem com server-side tracking quando eventos de backend precisam virar eventos de product analytics. Não é a resposta mais leve para um site simples de marketing.
12. Heap
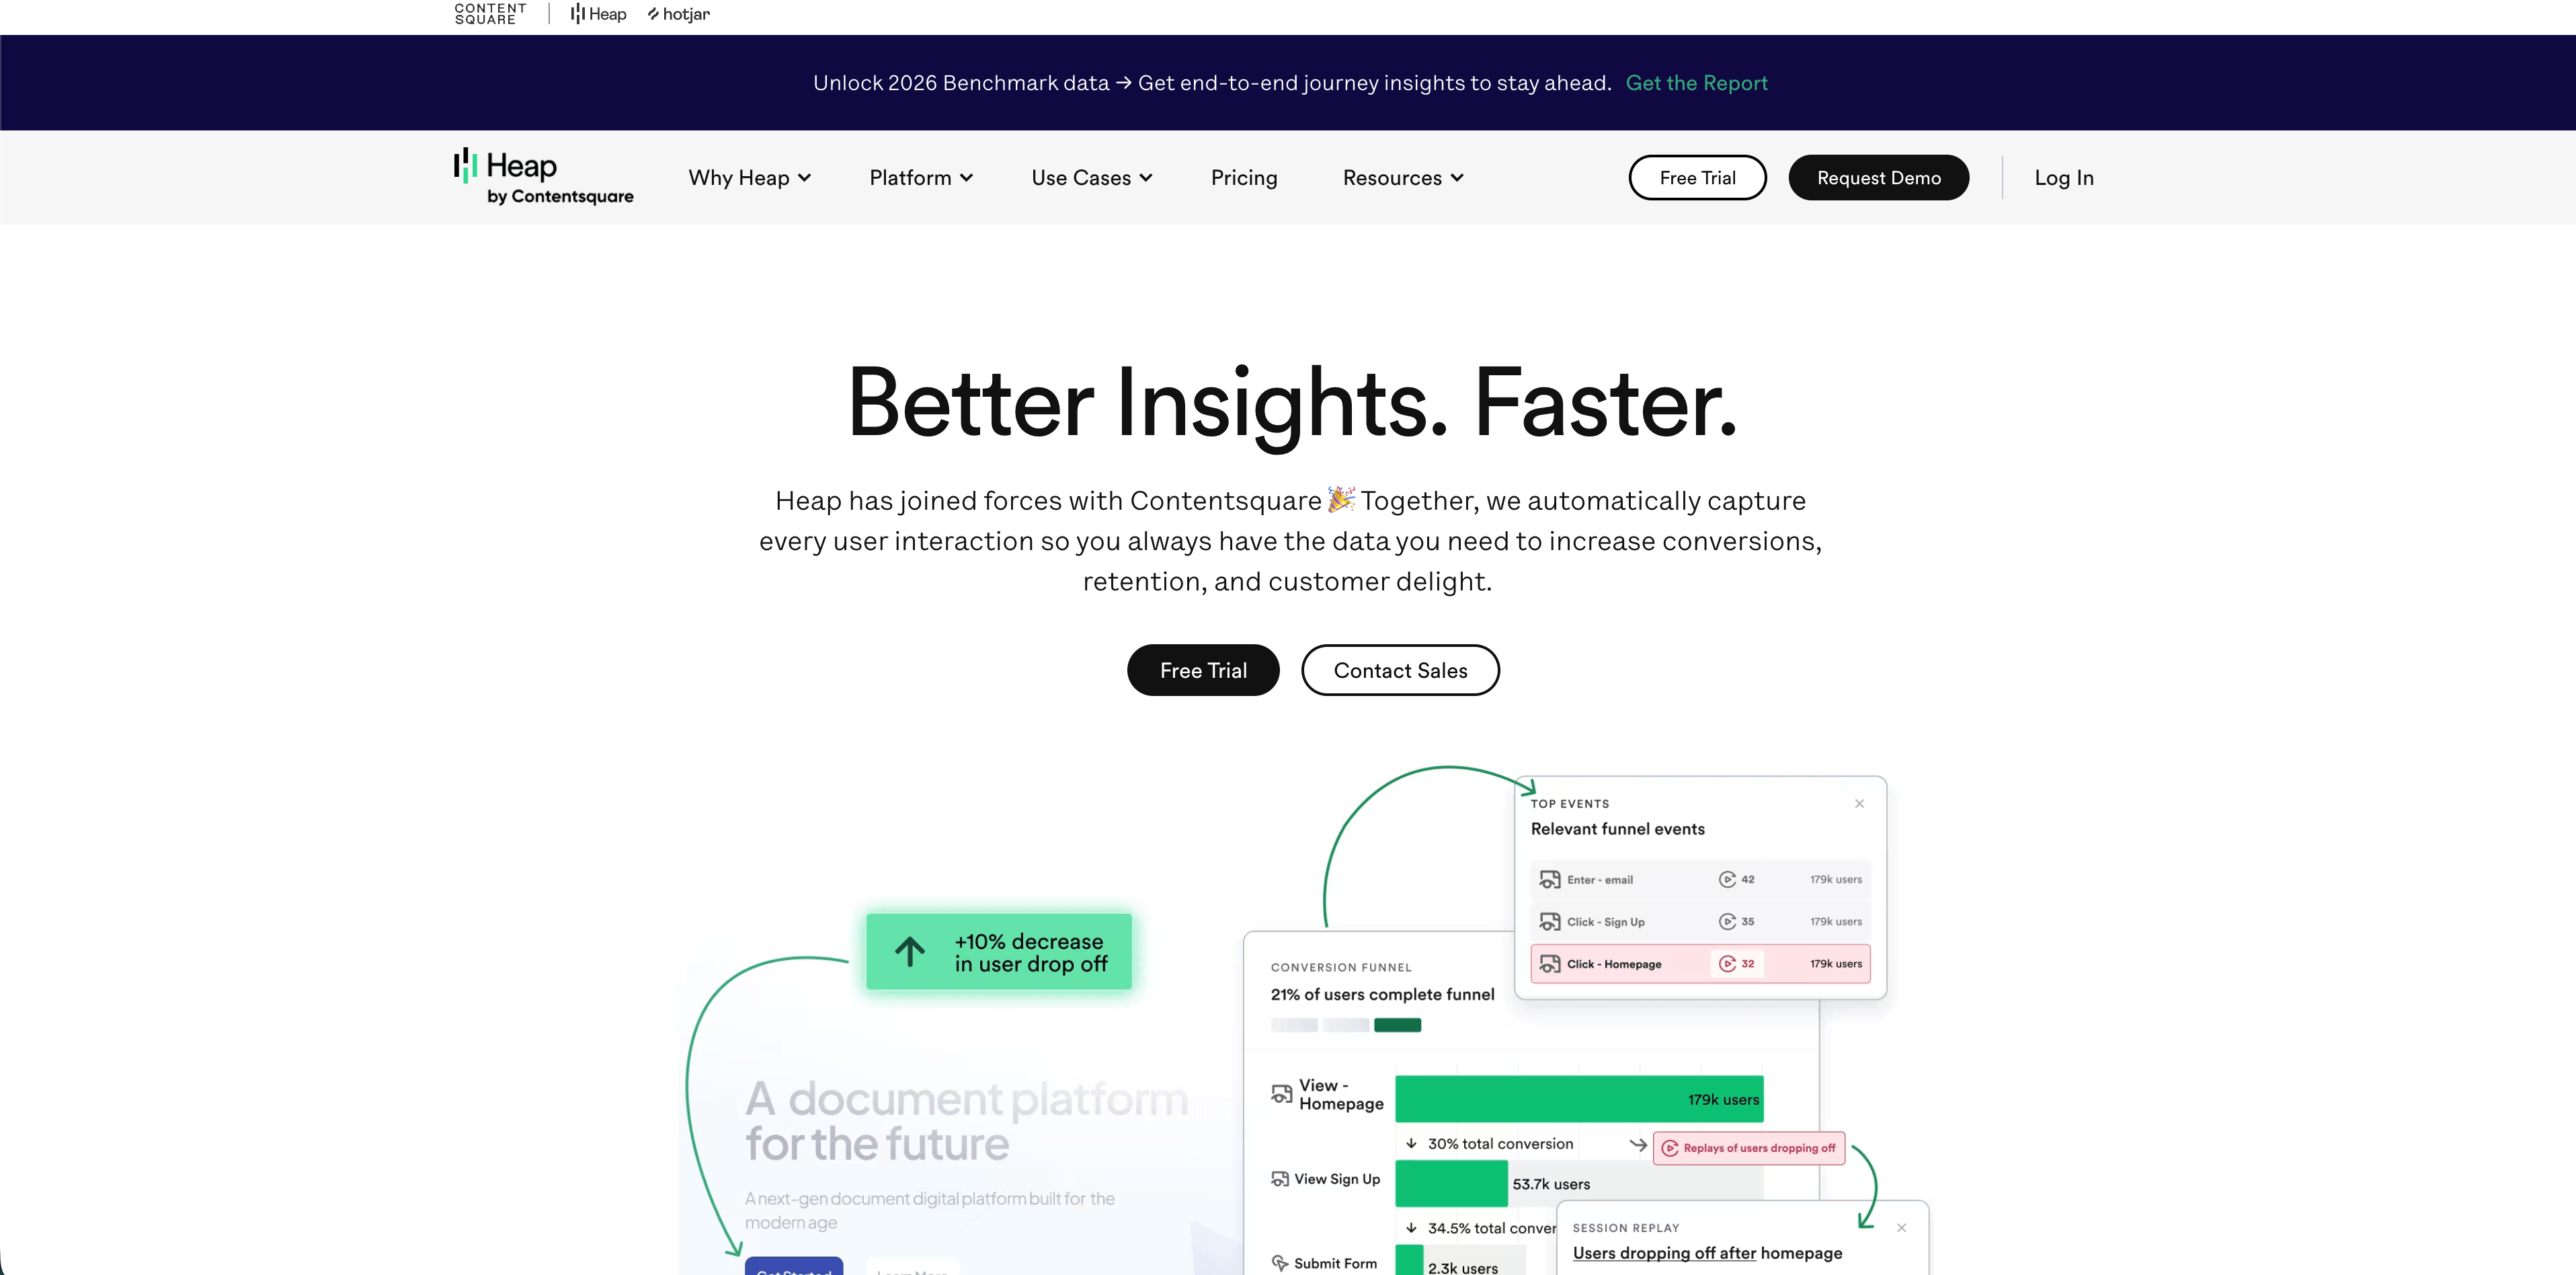
Heap é uma plataforma de product e digital experience analytics conhecida por autocapture. O site público enfatiza journeys, web analytics, session replay, heatmaps, capture, enrichment, integrations, governance, dashboards, charts, playbooks e análise assistida por AI.
Heap é útil quando a equipe precisa investigar comportamento que não foi marcado manualmente com antecedência. Essa riqueza também levanta perguntas de governança, então regras de retenção de dados e dados sensíveis devem ser resolvidas cedo.
Quando server-side tracking vale o trabalho
Server-side tracking vale a pena quando pelo menos uma destas afirmações é verdadeira:
- aquisição paga depende de eventos precisos de compra, lead ou assinatura
- receita de backend é a fonte de verdade
- números de conversão apenas no browser estão visivelmente abaixo das conversões de backend
- equipes de privacidade ou segurança precisam de uma camada revisável de compartilhamento de dados
- o site atualmente carrega muitos scripts de tracking de terceiros
- o negócio precisa de eventos de CRM, offline, telefone ou ciclo de vida na atribuição
- qualidade de eventos é inconsistente entre implementações de browser
- você precisa de controles mais fortes para bots, tráfego interno ou eventos de teste
Normalmente não vale começar com server-side tagging completo quando o site é pequeno, a única decisão é "quais páginas são populares" ou a equipe ainda não definiu os eventos em que quer confiar.
Um plano sensato de rollout
Comece pequeno. Escolha um evento que importa e é fácil verificar contra um registro de backend.
- Defina a fonte de verdade. Por exemplo, Stripe diz que a assinatura está ativa, não o clique no browser.
- Mantenha o contrato de evento curto. Nome do evento, timestamp, valor, moeda, página de origem, campos de campanha e um ID de deduplicação costumam ser suficientes.
- Remova dados sensíveis antes de encaminhar. Não envie emails brutos, endereços IP completos, access tokens, URLs privadas ou notas internas.
- Mapeie estados de consentimento. Decida o que pode ser coletado, armazenado e encaminhado em cada condição de consentimento.
- Deduplicate eventos de browser e servidor. Use um event ID compartilhado quando o destino suportar.
- Compare contra totais de backend. Monitore subcontagem, sobrecontagem, atrasos e payloads rejeitados.
- Documente ownership. Alguém precisa ser dono de nomes de eventos, regras de destino, retenção e auditorias.
O melhor teste inicial muitas vezes é signup_completed, trial_started ou purchase_completed. Esses eventos são concretos, críticos para o negócio e fáceis de comparar contra o banco de dados ou provedor de pagamento.
Erros comuns
Tratar server-side tracking como bypass de consentimento. Se o setup armazena ou acessa informações do dispositivo, usa identificadores ou envia dados para plataformas de anúncios, regras de privacidade ainda importam.
Painel em tempo real
Rastreamento de metas
Rastreamento sem cookies
Encaminhar tudo. O ponto não é recriar o firehose do browser em um servidor. O ponto é enviar menos eventos, mais limpos e melhor governados.
Pular deduplicação. Se o browser envia Purchase e o servidor também envia Purchase, muitos destinos precisam de um event ID para não contar a mesma conversão duas vezes.
Confiar em dashboards de anúncios acima da verdade de backend. Plataformas de anúncios são úteis para otimização de campanhas, mas pedidos, invoices, reembolsos e assinaturas devem ser reconciliados contra sistemas que você controla.
Ignorar tráfego de bots e testes. Eventos server-side ainda podem ser poluídos por compras de teste, QA interno, crawlers e abuso se o pipeline aceita tudo.
Manter tags antigas para sempre. Se server-side tracking é adicionado sem remover scripts redundantes de browser, você pode ganhar complexidade sem benefícios de performance ou governança.
Perguntas frequentes
Quais são os principais benefícios do server side tracking?
Os principais benefícios do server side tracking são eventos de conversão de backend mais limpos, mais controle sobre quais dados são compartilhados e redução de carga no browser. Melhor validação de eventos, atribuição mais forte para eventos de receita e um pipeline de analytics mais governável completam a lista.
Server-side tracking é mais preciso que client-side tracking?
Server-side tracking é mais preciso para eventos que seu servidor consegue verificar, como compras, signups e mudanças de assinatura. Não é automaticamente melhor para comportamento apenas no browser, como scroll depth, hover interactions, mudanças de rota client-side ou engajamento de página. Setups maduros usam ambas as fontes para trabalhos diferentes.
Server-side tracking remove a necessidade de consentimento de cookies?
Não. Server-side tracking pode reduzir cookies desnecessários e melhorar controle de dados, mas requisitos de consentimento dependem dos dados coletados, se você armazena ou acessa informações no dispositivo do usuário, quais identificadores usa e para onde envia os dados. Trate isso como tema de revisão de privacidade, não como brecha.
Server-side tracking bypassa ad blockers?
Server-side tracking evita algumas falhas causadas por requisições de browser bloqueadas, especialmente para eventos confirmados pelo backend. Mas usar server-side tracking puramente para driblar escolhas do usuário é arriscado e muitas vezes contrário ao espírito dos controles de privacidade. Use para melhorar confiabilidade e governança, não para contrabandear dados.
Equipes pequenas devem começar com server-side tracking?
Normalmente não como primeiro projeto de analytics. Equipes pequenas devem começar com um dashboard claro e com privacidade, definir os poucos eventos que importam e adicionar eventos server-side apenas quando conversões, receita ou otimização de anúncios exigirem dados confirmados pelo backend.
Qual plataforma devo avaliar primeiro?
Comece com Flowsery se você quer website analytics com privacidade com tráfego ao vivo, fontes, metas, funis, jornadas, eventos e contexto de receita. Avance para server-side tagging, PostHog, Mixpanel, Heap, Matomo ou um pipeline de warehouse quando suas necessidades de governança de eventos superarem um dashboard focado de website analytics.
Qual deve ser o primeiro evento a rastrear no servidor?
Escolha um evento concreto, crítico para o negócio e fácil de verificar contra um registro do backend. O artigo aponta signup_completed, trial_started ou purchase_completed como bons pontos de partida, porque você pode comparar cada um diretamente com o banco de dados ou o provedor de pagamento. Mantenha o contrato do evento curto: nome do evento, timestamp, valor, moeda, página de origem, campos de campanha e um ID de deduplicação.
Como evitar que eventos do servidor e do navegador contam a mesma conversão duas vezes?
Dê ao evento do navegador e ao evento do servidor o mesmo ID de evento para que o destino os reconheça como uma única conversão. Muitos destinos precisam desse ID para não contar duas vezes um Purchase enviado dos dois lados. Pular essa etapa é um dos erros comuns e pode duplicar suas conversões reportadas sem você perceber.
O que a Conversions API da Meta realmente conecta?
A Meta descreve a Conversions API como uma conexão direta e mais confiável entre dados de marketing e a Meta. Essa conexão suporta eventos de sites, apps, CRM, lojas físicas, telefone, email, chat comercial e fontes offline. Ela envia esses eventos direto do seu backend em vez de depender apenas do pixel do navegador. O quanto isso melhora o matching e a otimização ainda depende da sua mistura de tráfego, taxa de consentimento e qualidade do matching.
O server-side tracking consegue organizar dados de eventos bagunçados?
O processamento do lado do servidor te dá um lugar para impor padrões, como grafia consistente dos nomes de eventos, campos obrigatórios, um formato de moeda único e tratamento separado para bots, usuários internos e tráfego de teste. Essa padronização não resolve sozinha um design de eventos pouco claro. Uma taxonomia ruim continua virando dado ruim em escala se ninguém definir os eventos antes.
Painel em tempo real
Rastreamento de metas
Rastreamento sem cookies
Recomendação final
Os benefícios do server side tracking são reais, mas mais estreitos do que o pitch de vendas sugere. Use para eventos que merecem autoridade do servidor: compras, signups, assinaturas, leads qualificados, atualizações de ciclo de vida e receita. Mantenha comportamento simples de website em uma ferramenta de analytics com privacidade a menos que exista uma razão clara para mover isso.
Flowsery é o primeiro lugar para começar quando você quer um dashboard útil de website analytics sem assumir o peso de uma arquitetura completa de server-side tagging. Quando o negócio precisar de conversões confirmadas pelo backend, conecte esses eventos de forma deliberada e mantenha o pipeline pequeno o bastante para auditar.
Comece com Flowsery - tenha analytics com privacidade, funis, jornadas, eventos e contexto de receita antes de deixar tracking mais complexo.
Fontes: Google Tag Manager Help, documentação de server-side do Google Tag Manager, Google Ads Enhanced Conversions Help, Meta Business Help Center Conversions API, WebKit Tracking Prevention, Mozilla Firefox Total Cookie Protection, orientação do UK ICO sobre cookies e tecnologias similares, páginas públicas de produto do Flowsery, Plausible, Fathom, Simple Analytics, Pirsch, Matomo, Umami, Seline, DataFast, PostHog, Mixpanel e Heap, todas checadas em 12 de maio de 2026.
Este artigo foi útil?
Diga-nos o que pensa!
Veja-nos mais no Google
Um clique marca o Flowsery como fonte preferida e nossos artigos passam a aparecer mais acima nas suas Principais notícias, no modo IA e nas visões gerais com IA.
Antes de ir...
Flowsery
Analytics orientado para receitas para o seu site
Rastreie cada visitante, fonte e conversão em tempo real. Simples, poderoso e sem cookies.
Painel em tempo real
Rastreamento de metas
Rastreamento sem cookies
Artigos relacionados
Alternativas às suítes legadas de web analytics: 12 ferramentas
Compare analytics alternatives para 2026 por privacidade, preco, dashboards, funis, atribuicao de receita, product analytics e governanca.
Como comparar concorrentes de análise em 2026
Compare analytics competitors em 2026 por modelo de privacidade, profundidade de dashboard, preços, hospedagem, atribuição de receita e product analytics.
Compare ferramentas de análise para crescer sites em 2026
Privacidade, dashboards, funis, preços, atribuição de receita, product analytics e esforço de implementação, com capturas de cada painel avaliado.