
W skrócie
18 min czytaniaŚledzenie po stronie serwera wysyła wybrane zdarzenia z infrastruktury, którą kontrolujesz, na przykład z backendu, webhooków płatności, tras API lub własnego proxy. Zwiększa niezawodność zweryfikowanych zdarzeń biznesowych, ale nie sprawia automatycznie, że analityka jest prywatna, zwolniona z wymogu zgody ani identyczna w każdym narzędziu.
Jeśli analityka w przeglądarce wydaje ci się niepełna, ten poradnik wyjaśnia, co się zmienia, gdy zdarzenia przenoszą się z przeglądarki odwiedzającego do infrastruktury pod twoją kontrolą, co nadal się psuje i które platformy analityczne obsługują dziś takie podejście.
Informacje do tego artykułu sprawdziliśmy 12 maja 2026 r. na podstawie oficjalnych stron produktów, cenników, dokumentacji, wytycznych organów nadzorczych i aktualnych opisów API dostawców. Flowsery jest na pierwszym miejscu, bo to nasza platforma, a przy każdej wymienionej poniżej platformie znajdziesz obraz pulpitu z CDN AdaptlyPost.
Najważniejszy wniosek: śledzenie po stronie serwera najlepiej sprawdza się przy zdarzeniach, które serwer może zweryfikować, takich jak rejestracje, płatności, zmiany subskrypcji, pobrania po uwierzytelnieniu, zgłoszenia leadów, użycie API i potwierdzenia z webhooków. Słabiej radzi sobie ze zdarzeniami widocznymi tylko dla przeglądarki, takimi jak głębokość przewijania, czas widoczności, najeżdżanie kursorem, rozpoczęcie wypełniania formularza, zmiany tras po stronie klienta i błędy wizualne.
Co naprawdę oznacza śledzenie po stronie serwera
Śledzenie po stronie serwera oznacza, że zdarzenie jest zbierane, przekształcane, filtrowane, wzbogacane lub przekazywane przez twój serwer, a nie wysyłane wyłącznie przez JavaScript działający w przeglądarce odwiedzającego.
Może się to odbywać na kilka sposobów:
| Wzorzec | Co wysyła zdarzenie | Najlepsze do | Główne ryzyko |
|---|---|---|---|
| API zdarzeń z backendu | Serwer aplikacji wywołuje API analityczne | Zakupów, rejestracji, zdarzeń konta, zmian statusu leadów | Brak kontekstu przeglądarki, takiego jak referrer, UTM, urządzenie i sesja |
| Webhook płatności lub CRM | Stripe, Paddle, Shopify, CRM lub inny system powiadamia backend | Atrybucji przychodów i zdarzeń cyklu życia | Dopasowanie webhooka do pierwotnego odwiedzającego lub kampanii |
| Własne proxy | Przeglądarka wysyła dane do twojego punktu końcowego, a serwer je przekazuje | Lepszej kontroli, filtrowania, czyszczenia danych, odporności na blokery reklam | Nadal zaczyna się w przeglądarce, więc zasady zgody i dostępu do urządzenia mogą obowiązywać |
| Serwerowy kontener tagów | Kontener na serwerze odbiera zdarzenia i przekazuje je do miejsc docelowych | Kierowania do wielu miejsc, przekształceń, deduplikacji | Więcej infrastruktury, kosztów i nadzoru |
| Analityka logów lub brzegu sieci | Serwer WWW, CDN lub odwrotne proxy zapisuje żądania | Operacji, botów, błędów, pobrań, zachowania pamięci podręcznej | Logi są zaszumione i nie równają się sesjom ludzi |
Kluczowe jest źródło prawdy. Zakup potwierdzony przez backend płatności to mocniejszy fakt konwersji niż piksel na stronie z podziękowaniem. Kliknięcie zakładki z cennikiem to zwykle fakt z przeglądarki. Błąd 500 to fakt z infrastruktury. Śledzenie po stronie serwera działa najlepiej, gdy każda metryka jest przypisana do systemu, który naprawdę wie, że coś się wydarzyło.
Każdy wiersz tej tabeli to najpierw integracja między oprogramowaniem, a dopiero potem decyzja analityczna. Jeśli przekazanie danych między dwoma systemami będzie błędne, nawet staranny plan pomiarów pewnie poda złą liczbę.
Dlaczego zespoły przenoszą śledzenie na serwer
Zespoły sięgają po śledzenie po stronie serwera, gdy pojawi się jeden z pięciu problemów.
Po pierwsze, skrypty w przeglądarce mogą być blokowane przez rozszerzenia chroniące prywatność, filtry DNS, reguły sieciowe, polityki bezpieczeństwa treści lub zwykłe awarie skryptów. Zdarzenia potwierdzane przez serwer są na to mniej narażone.
Po drugie, zdarzenia z kasy i zgłoszenia leadów są często zbyt cenne, by zależeć od załadowania strony. Przeglądarka może się zamknąć, zanim zadziała strona z podziękowaniem, dostawca płatności może przekierować inaczej, a klient może dokończyć płatność w procesie, którego skrypt w przeglądarce nigdy nie zobaczy.
Po trzecie, zdarzenia z backendu mogą zawierać fakty, których nie należy ujawniać przeglądarce, takie jak status zamówienia, kwoty faktur, identyfikatory planów, przedziały marży, stan weryfikacji pod kątem oszustw czy etap cyklu życia. Serwer może wysłać tylko bezpieczny dla analityki podzbiór.
Po czwarte, przetwarzanie po stronie serwera daje centralny filtr. Możesz odrzucać ruch wewnętrzny, usuwać parametry zapytań, normalizować nazwy zdarzeń, blokować wrażliwe właściwości, kierować dalej tylko zdarzenia objęte zgodą i zapobiegać podwójnemu liczeniu konwersji z przeglądarki i serwera.
Po piąte, śledzenie po stronie serwera może poprawić atrybucję, jeśli zachowuje własny kontekst kampanii i później łączy go ze zweryfikowanymi wynikami. Nie sprawi magicznie, że wszystkie platformy będą zgodne, ale może zwiększyć wiarygodność samego zdarzenia biznesowego.
Panel w czasie rzeczywistym
Śledzenie celów
Śledzenie bez cookie
Czego to nie rozwiązuje
Śledzenie po stronie serwera jest przereklamowane. Nie czyni analityki automatycznie zgodną z przepisami, dokładną ani niemożliwą do zablokowania.
Nie usuwa obowiązków związanych z prywatnością. Wytyczne brytyjskiego ICO o plikach cookie i podobnych technologiach mówią, że przepisy mogą dotyczyć plików cookie oraz podobnych technologii przechowywania lub dostępu, a nie tylko plików nazywanych „cookies”. Irlandzka Data Protection Commission również wskazuje, że zgoda jest zwykle wymagana dla plików cookie lub podobnych technologii, chyba że obowiązuje wyjątek. Jeśli konfiguracja po stronie serwera nadal zapisuje identyfikatory na urządzeniu, odczytuje je, stosuje fingerprinting, wysyła dane osobowe do systemów reklamowych lub ignoruje wybory użytkowników, umieszczenie logiki w backendzie nie rozwiąże problemu prawnego.
Nie sprawia, że logi serwera równają się ludziom. Serwer widzi roboty, monitory dostępności, boty podglądu linków, roboty AI, ponowne próby, żądania zasobów, prefetch, żądania z pamięci podręcznej i ataki. Surowe liczby żądań nie są sesjami ludzi, chyba że dokładnie je sklasyfikujesz i przefiltrujesz.
Domyślnie nie zachowuje kontekstu przeglądarki. Gdy przeglądarka nie wysyła do backendu referrera, parametrów UTM, user agenta, rozmiaru okna, języka ani identyfikatorów sesji, zdarzenie wyłącznie serwerowe może być dokładne, ale słabo przypisane.
Nie sprawia też, że każda platforma analityczna interpretuje zdarzenia tak samo. Każdy produkt ma własny model tożsamości, model sesji, filtrowanie botów, okno atrybucji, zasady deduplikacji i jednostkę rozliczeniową.
Śledzenie po stronie serwera a po stronie klienta
Używaj śledzenia po stronie klienta, gdy zdarzenie dotyczy doświadczenia odwiedzającego w przeglądarce:
- Odsłony i zmiany tras po stronie klienta
- Kontekst wejścia z kampanii
- Referrery i UTM przechwycone na stronie docelowej
- Kliknięcia, rozpoczęcie wypełniania formularzy, głębokość przewijania, linki wychodzące i pobrania
- Kontekst przeglądarki, urządzenia, rozmiaru okna i języka
- Odtwarzanie sesji i zachowanie w interfejsie
Używaj śledzenia po stronie serwera, gdy zdarzenie jest zweryfikowanym faktem z backendu:
- Utworzenie konta
- Przyjęcie lub zakwalifikowanie leada
- Ukończenie zakupu
- Odnowienie, podwyższenie, obniżenie lub anulowanie subskrypcji
- Opłacenie lub zwrot faktury
- Dostarczenie pliku przez uwierzytelniony punkt końcowy
- Wykonanie działania w API
- Wynik zadania w tle lub webhooka
Używaj obu, gdy decyzja obejmuje zarówno zachowanie w przeglądarce, jak i wynik biznesowy. Wizyta na stronie z cennikiem to zdarzenie z przeglądarki, a opłacona subskrypcja to zdarzenie z backendu. Zadanie analityki polega na połączeniu ich bez zbierania większej ilości danych osobowych, niż wymaga tego decyzja.
Porównanie platform pod kątem śledzenia po stronie serwera
| Platforma | Sprawdzona obsługa po stronie serwera | Najlepsze zastosowanie po stronie serwera | Na co uważać |
|---|---|---|---|
| Flowsery | Punkty końcowe API dla celów i płatności, cele niestandardowe, API płatności, konfiguracja proxy i wskazówki dotyczące atrybucji przychodów po stronie serwera | Analityka stron dbająca o prywatność, lejki, cele niestandardowe i atrybucja przychodów | Świadomie dopasowuj identyfikatory odwiedzających i transakcji |
| Plausible | Events API dla odsłon i zdarzeń niestandardowych, opisane jako przydatne przy śledzeniu po stronie serwera | Lekkie zdarzenia oraz wysyłanie odsłon i zdarzeń z aplikacji mobilnych lub backendu | Obsługa nagłówków ma znaczenie przy liczeniu unikalnych odwiedzających |
| Fathom | Dokumentacja API obejmuje śledzenie zdarzeń | Proste zdarzenia i cele w hostowanej analityce | Słabiej nadaje się do pogłębionej analityki produktowej |
| Simple Analytics | Wysyłanie zdarzeń i odsłon z serwera do punktu końcowego events | Zagregowane raporty dbające o prywatność ze źródeł backendowych lub mobilnych | Unikaj user agentów bibliotek HTTP, które wyglądają jak boty |
| Pirsch | Integracja po stronie serwera, API, SDK, zdarzenia, cele konwersji, lejki | Analityka stron hostowana w UE ze zdarzeniami z backendu i API przyjaznym agencjom | Omów z prawnikami model hashowania danych z żądań |
| Matomo | HTTP Tracking API i ścieżki z SDK po stronie serwera | Analityka self-hosted lub w chmurze z szeroką kontrolą | Więcej konfiguracji i analizy pod kątem zgody |
| Umami | Poradnik zdarzeń po stronie serwera, klient Node, /api/send i punkt końcowy wsadowy | Zdarzenia self-hosted lub w chmurze z webhooków, zadań, API i uzupełnień historii | Zachowuj user agenta i kontekst atrybucji tam, gdzie są potrzebne |
| Seline | Zdarzenia niestandardowe po stronie klienta i serwera; zdarzenia z serwera wymagają znanego identyfikatora użytkownika | Ścieżki w stylu SaaS, profile, przychody i idempotentne zdarzenia niestandardowe | Zdarzenia z serwera zależą od konfiguracji profili i użytkowników |
| DataFast | API może tworzyć cele niestandardowe po stronie serwera; dokumentacja zaleca śledzenie przychodów po stronie serwera dla dokładności | Atrybucja przychodów i śledzenie celów przyjazne małym twórcom | Część procesów atrybucji nadal zależy od dopasowania odwiedzającego |
| PostHog | Biblioteki serwerowe dla Node.js, Pythona, Javy, PHP, Ruby, C#/.NET oraz API zdarzeń | Analityka produktowa, flagi funkcji, eksperymenty, odtwarzanie sesji i zdarzenia z backendu | Większe możliwości oznaczają potrzebę większego nadzoru i kontroli kosztów |
| Mixpanel | API /track do pobierania danych i SDK po stronie serwera | Dojrzała analityka zdarzeń, lejki, kohorty, retencja | Wymaga solidnej taksonomii zdarzeń i dyscypliny w zarządzaniu tożsamością |
| Heap | Track API po stronie serwera dla zdarzeń niestandardowych powiązanych z użytkownikami | Automatycznie zbierana analityka produktowa plus zweryfikowane zdarzenia z backendu | Zdarzenia z serwera są powiązane ze zidentyfikowanymi użytkownikami i mogą nie łączyć się w sesje jak zdarzenia webowe |
1. Flowsery
Flowsery to pierwsza platforma do sprawdzenia, jeśli chcesz mieć analitykę strony, lejki, cele, ścieżki, atrybucję przychodów, zdarzenia niestandardowe i śledzenie dbające o prywatność w jednym, spójnym pulpicie.
Aktualny cennik Flowsery podaje plan Team za 250 $/miesiąc i Pro za 500 $/miesiąc po 14-dniowym darmowym okresie próbnym, ze śledzeniem przychodów, analizą lejków, dostępem do API, śledzeniem bez cookies, pełnym eksportem, brakiem próbkowania danych i nieograniczoną liczbą witryn w planie Pro. Dokumentacja opisuje też cele niestandardowe, Flowsery Analytics API, tworzenie celów, tworzenie płatności, konfigurację proxy oraz opcję data-disable-payments dla zespołów stosujących atrybucję przychodów po stronie serwera, aby uniknąć zdublowanych zdarzeń płatności.
Flowsery pasuje do śledzenia po stronie serwera, gdy celem nie jest budowa ogromnego stosu danych, lecz połączenie źródeł ruchu z realnymi wynikami. Możesz na przykład używać śledzenia w przeglądarce dla stron docelowych i kontekstu źródła, a zweryfikowane cele lub zdarzenia płatności wysyłać z backendu, gdy serwer wie, że rejestracja lub zakup naprawdę się odbyły.
Wybierz Flowsery, gdy:
- Chcesz mieć Flowsery na czele krótkiej listy narzędzi do analityki stron dbającej o prywatność.
- Potrzebujesz razem źródeł, kampanii, celów, lejków, ścieżek, przychodów i dostępu do API.
- Chcesz zdarzeń biznesowych potwierdzanych przez serwer, ale bez zamieniania analityki strony w magazyn telemetrii produktowej.
- Zależy ci na ograniczeniu plików cookie, fingerprintingu i profili osobowych.
Uważaj na:
- Jeśli wysyłasz zdarzenia płatności z przeglądarki i z backendu, zaprojektuj deduplikację wokół stabilnych identyfikatorów transakcji.
- Jeśli self-hosting jest obowiązkowy, porównaj Matomo, Umami lub inny stos hostowany samodzielnie.
2. Plausible
Panel w czasie rzeczywistym
Śledzenie celów
Śledzenie bez cookie
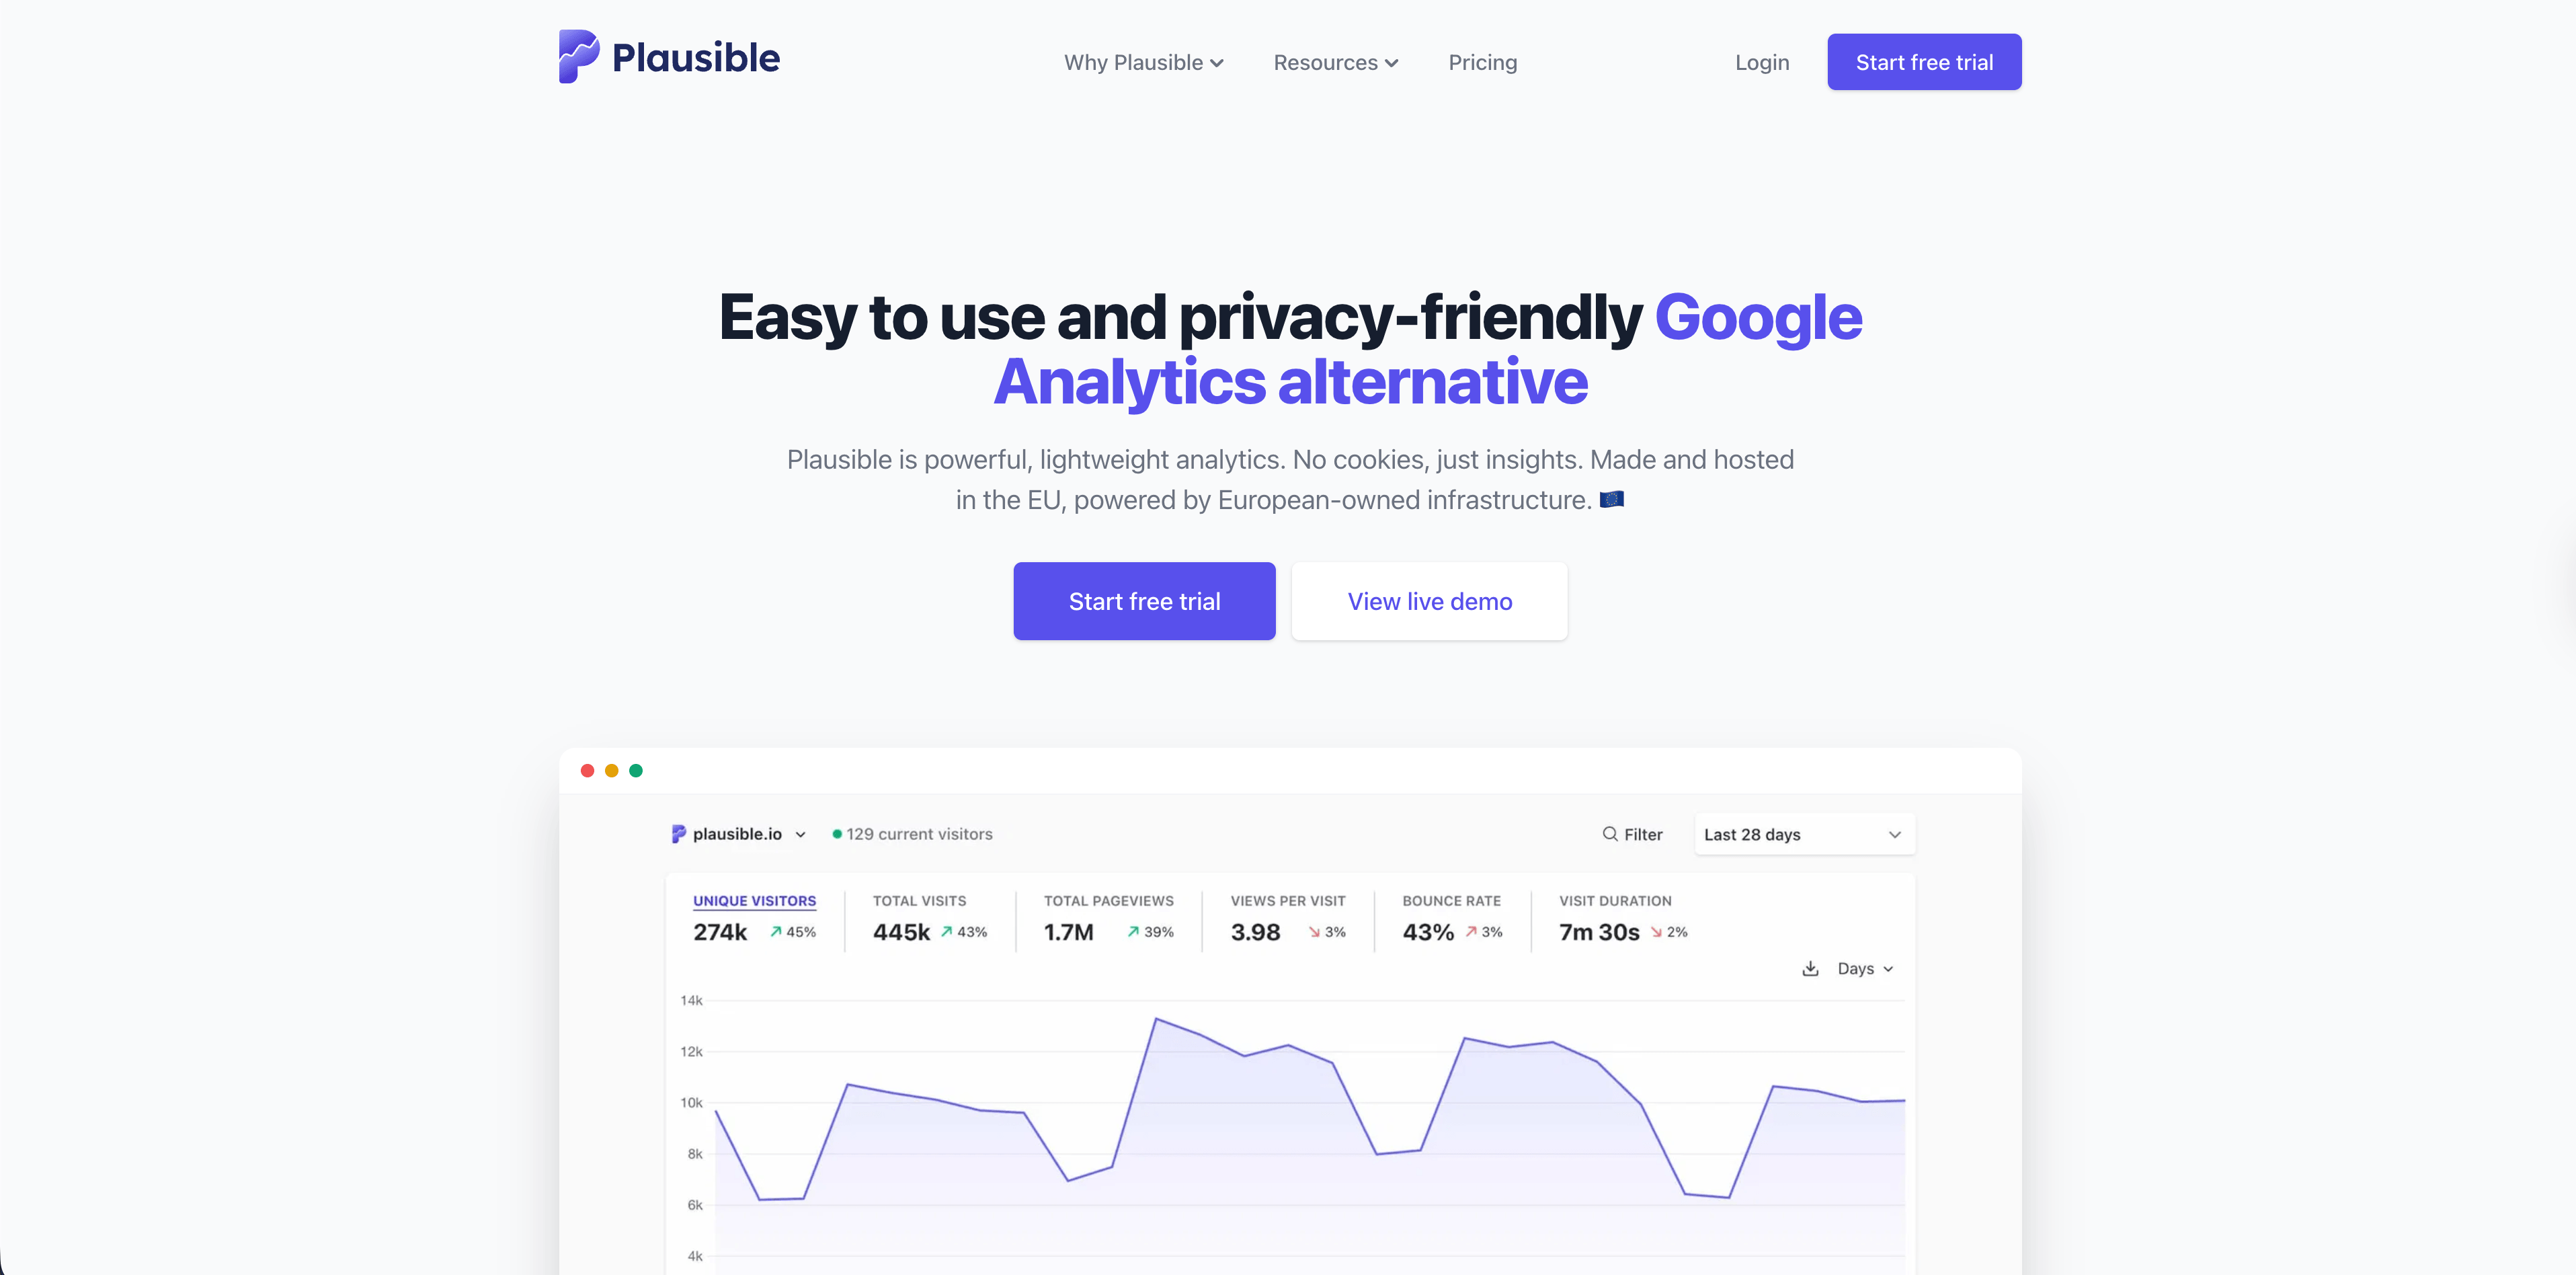
Plausible dokumentuje Events API do rejestrowania odsłon i zdarzeń niestandardowych. Dokumentacja wprost opisuje je jako przydatne w aplikacjach mobilnych i przy śledzeniu po stronie serwera, choć dla większości stron nadal zaleca standardowy skrypt.
Plausible sprawdza się, gdy chcesz prostego pulpitu przyjaznego prywatności i potrzebujesz tylko wybranych zdarzeń z backendu. Naturalnie pasuje do odsłon, celów, konwersji i lekkich zdarzeń niestandardowych.
Uważaj na nagłówki. Dokumentacja Plausible wskazuje User-Agent i X-Forwarded-For jako ważne dla liczenia unikalnych odwiedzających. Jeśli backend wysyła ogólne nagłówki biblioteki HTTP lub adresy IP proxy, zdarzenie może zostać przyjęte, ale policzone niezgodnie z rzeczywistością.
3. Fathom
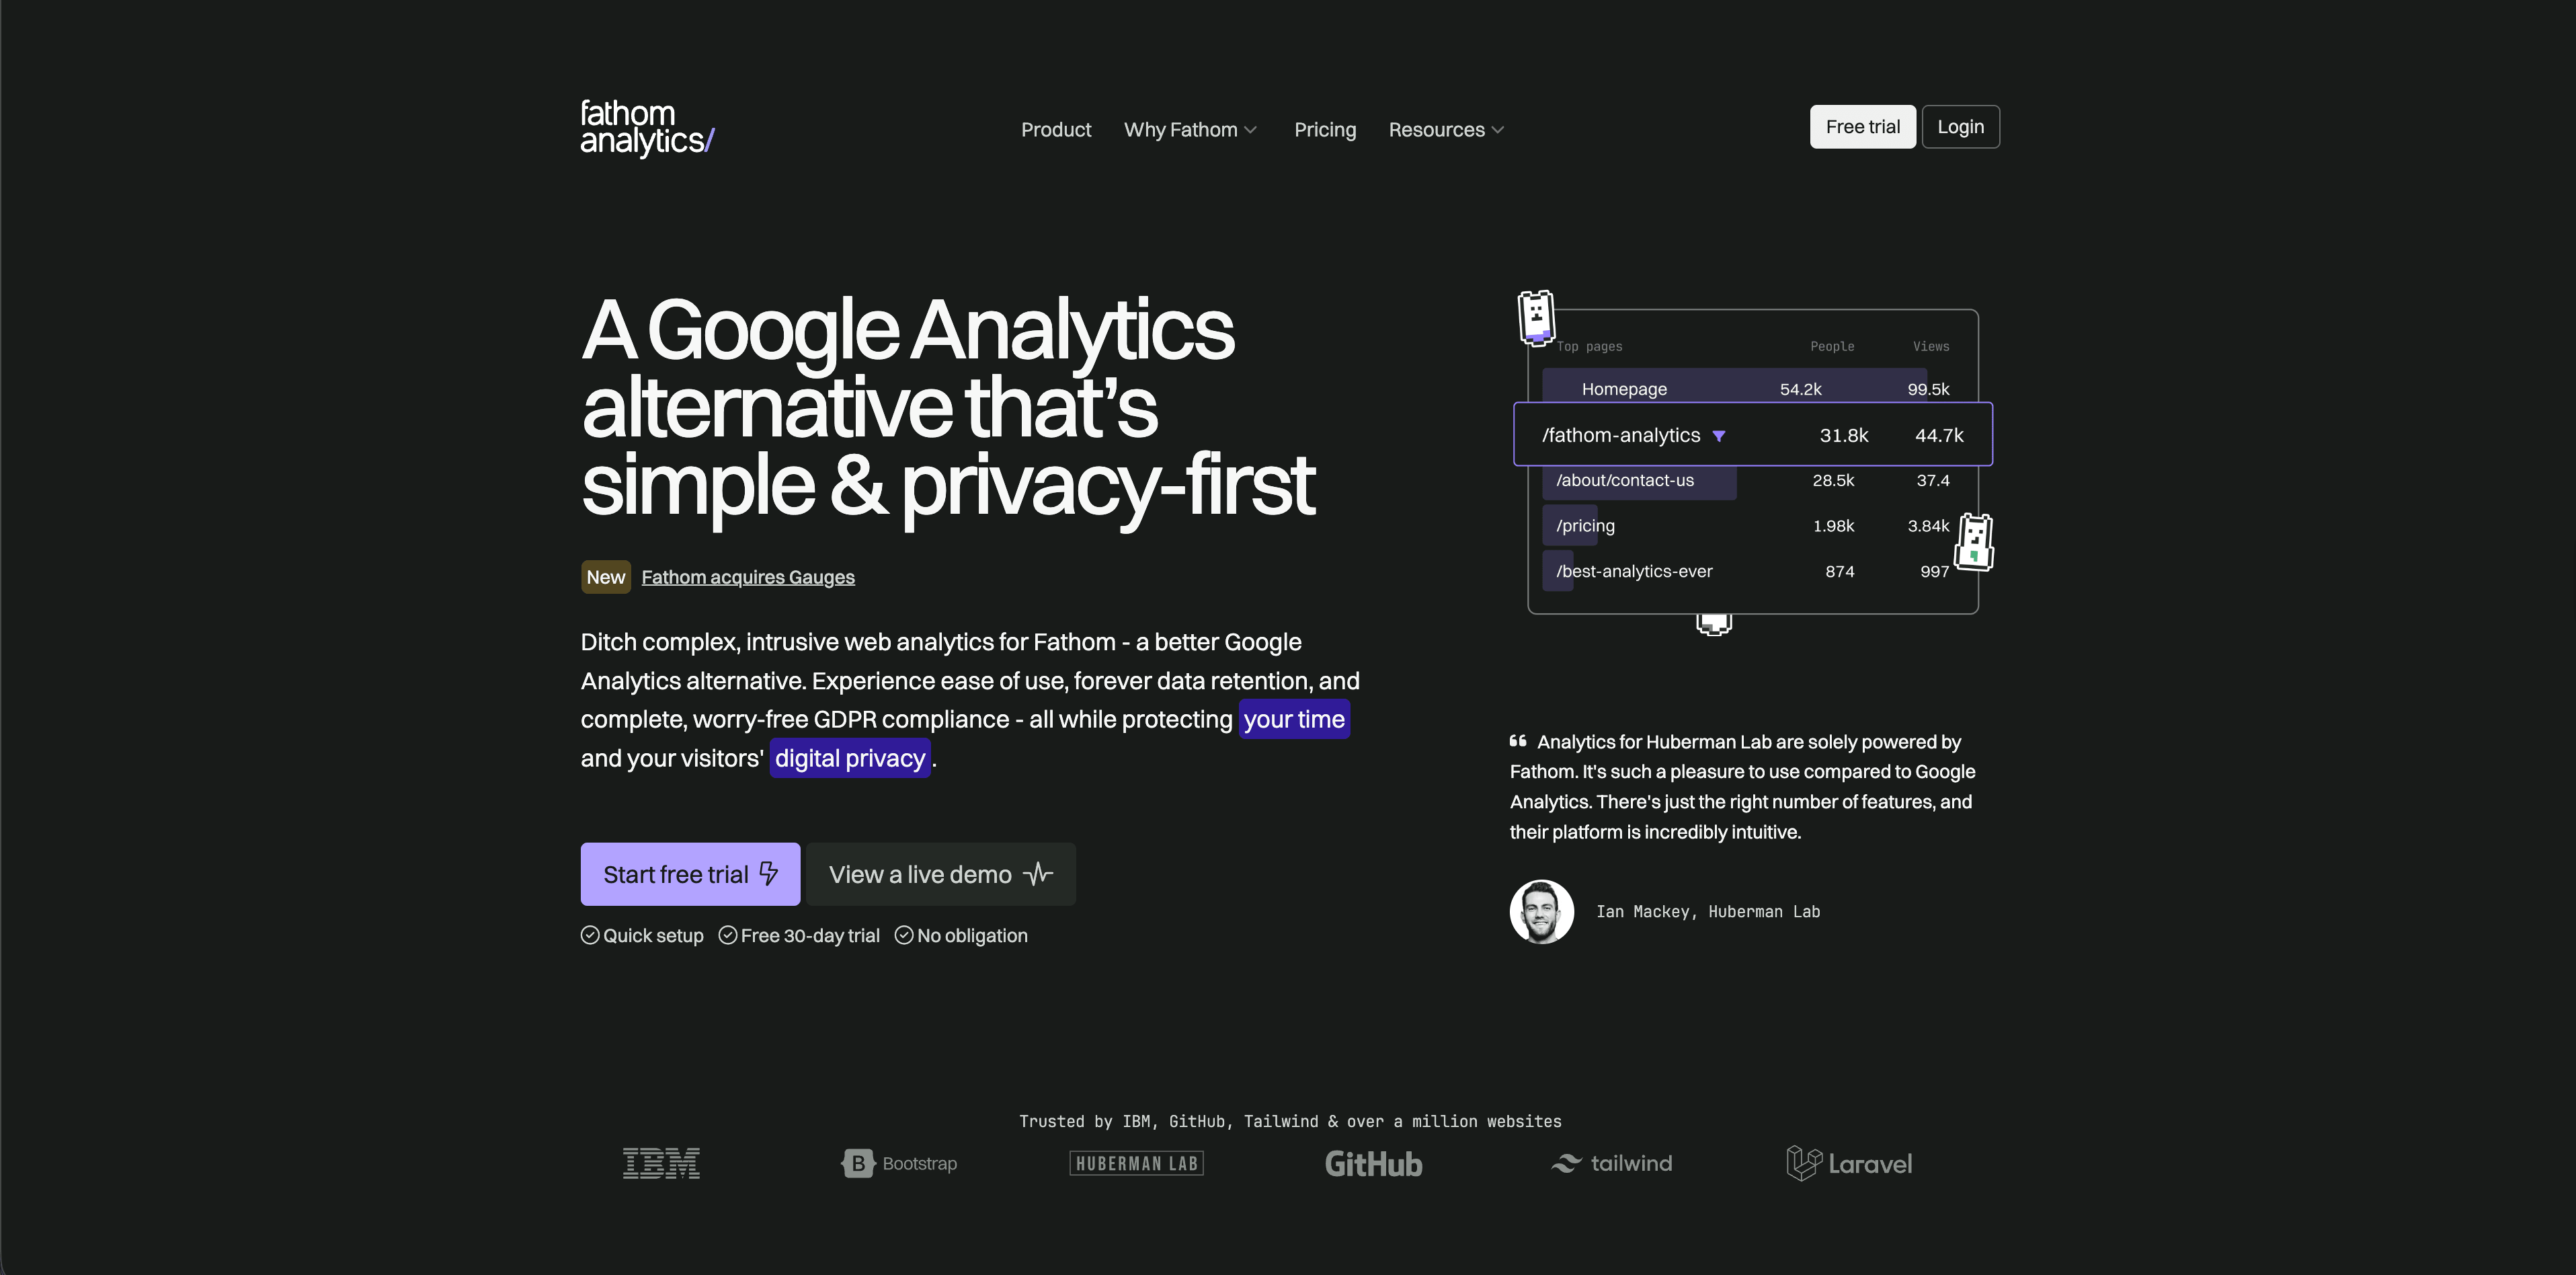
Fathom Analytics to prosty produkt analityczny w modelu hostowanym, z dokumentacją API obejmującą śledzenie zdarzeń. Najlepiej traktować go jako przejrzystą analitykę strony, która może przyjmować ważne dane o zdarzeniach, a nie jako szeroki magazyn danych produktowych.
Fathom pasuje do zespołów, które chcą hostowanego pulpitu niewymagającego utrzymania i tylko kilku wartościowych zdarzeń z backendu. Szczególnie atrakcyjny jest dla agencji, małych firm, twórców i stron marketingowych SaaS, w których raporty mają pozostać czytelne.
Uważaj na zakres. Jeśli plan po stronie serwera obejmuje kohorty, retencję, łączenie danych w hurtowni, flagi funkcji i dziesiątki zdarzeń produktowych, Fathom raczej nie będzie głównym systemem.
4. Simple Analytics
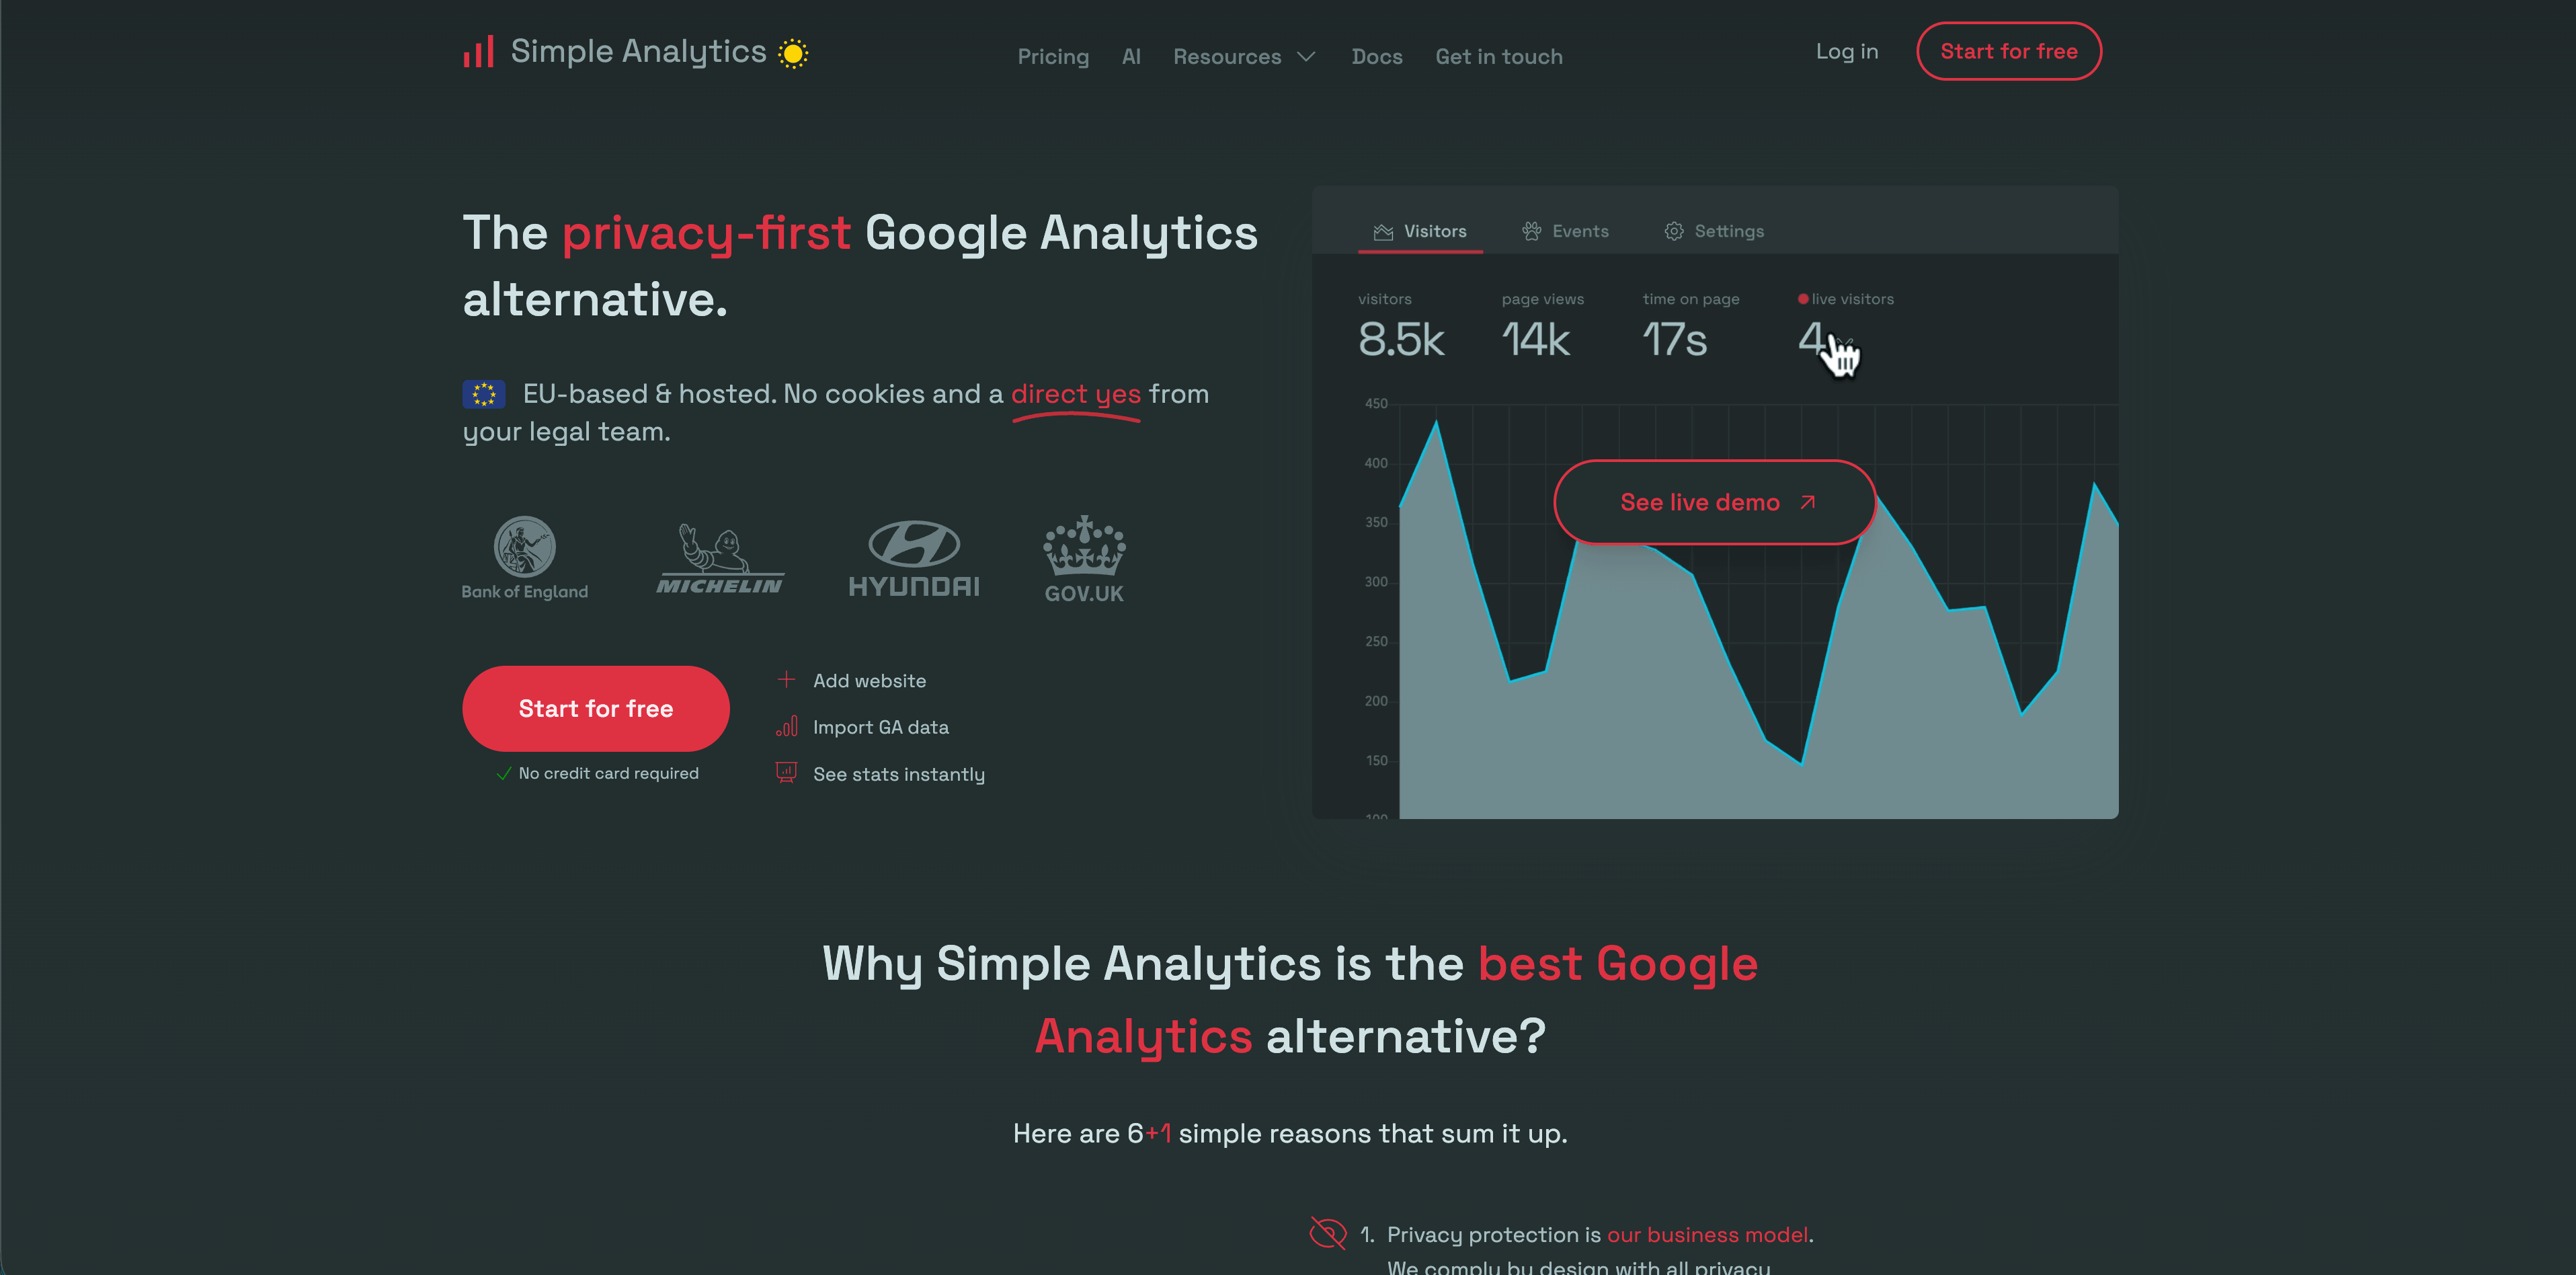
Simple Analytics ma osobną dokumentację wysyłania zdarzeń i odsłon z serwera. Programiści mogą wysyłać JSON do punktu końcowego events, dodawać metadane, a później analizować zdarzenia w pulpicie lub Events Explorer.
Platforma jest najmocniejsza, gdy chcesz zagregowanych raportów i rygorystycznego podejścia do prywatności. Zdarzenia po stronie serwera mogą obejmować źródła mobilne, backendowe i pozaprzeglądarkowe bez rezygnacji z minimalistycznej filozofii produktu.
Uważaj na user agenta. Simple Analytics ostrzega przed domyślnymi user agentami bibliotek HTTP, które mogą wyglądać jak boty. To przydatne przypomnienie dla każdej konfiguracji po stronie serwera: zdarzenia z backendu nadal potrzebują wystarczającego kontekstu żądania, by można je było poprawnie zinterpretować.
5. Pirsch
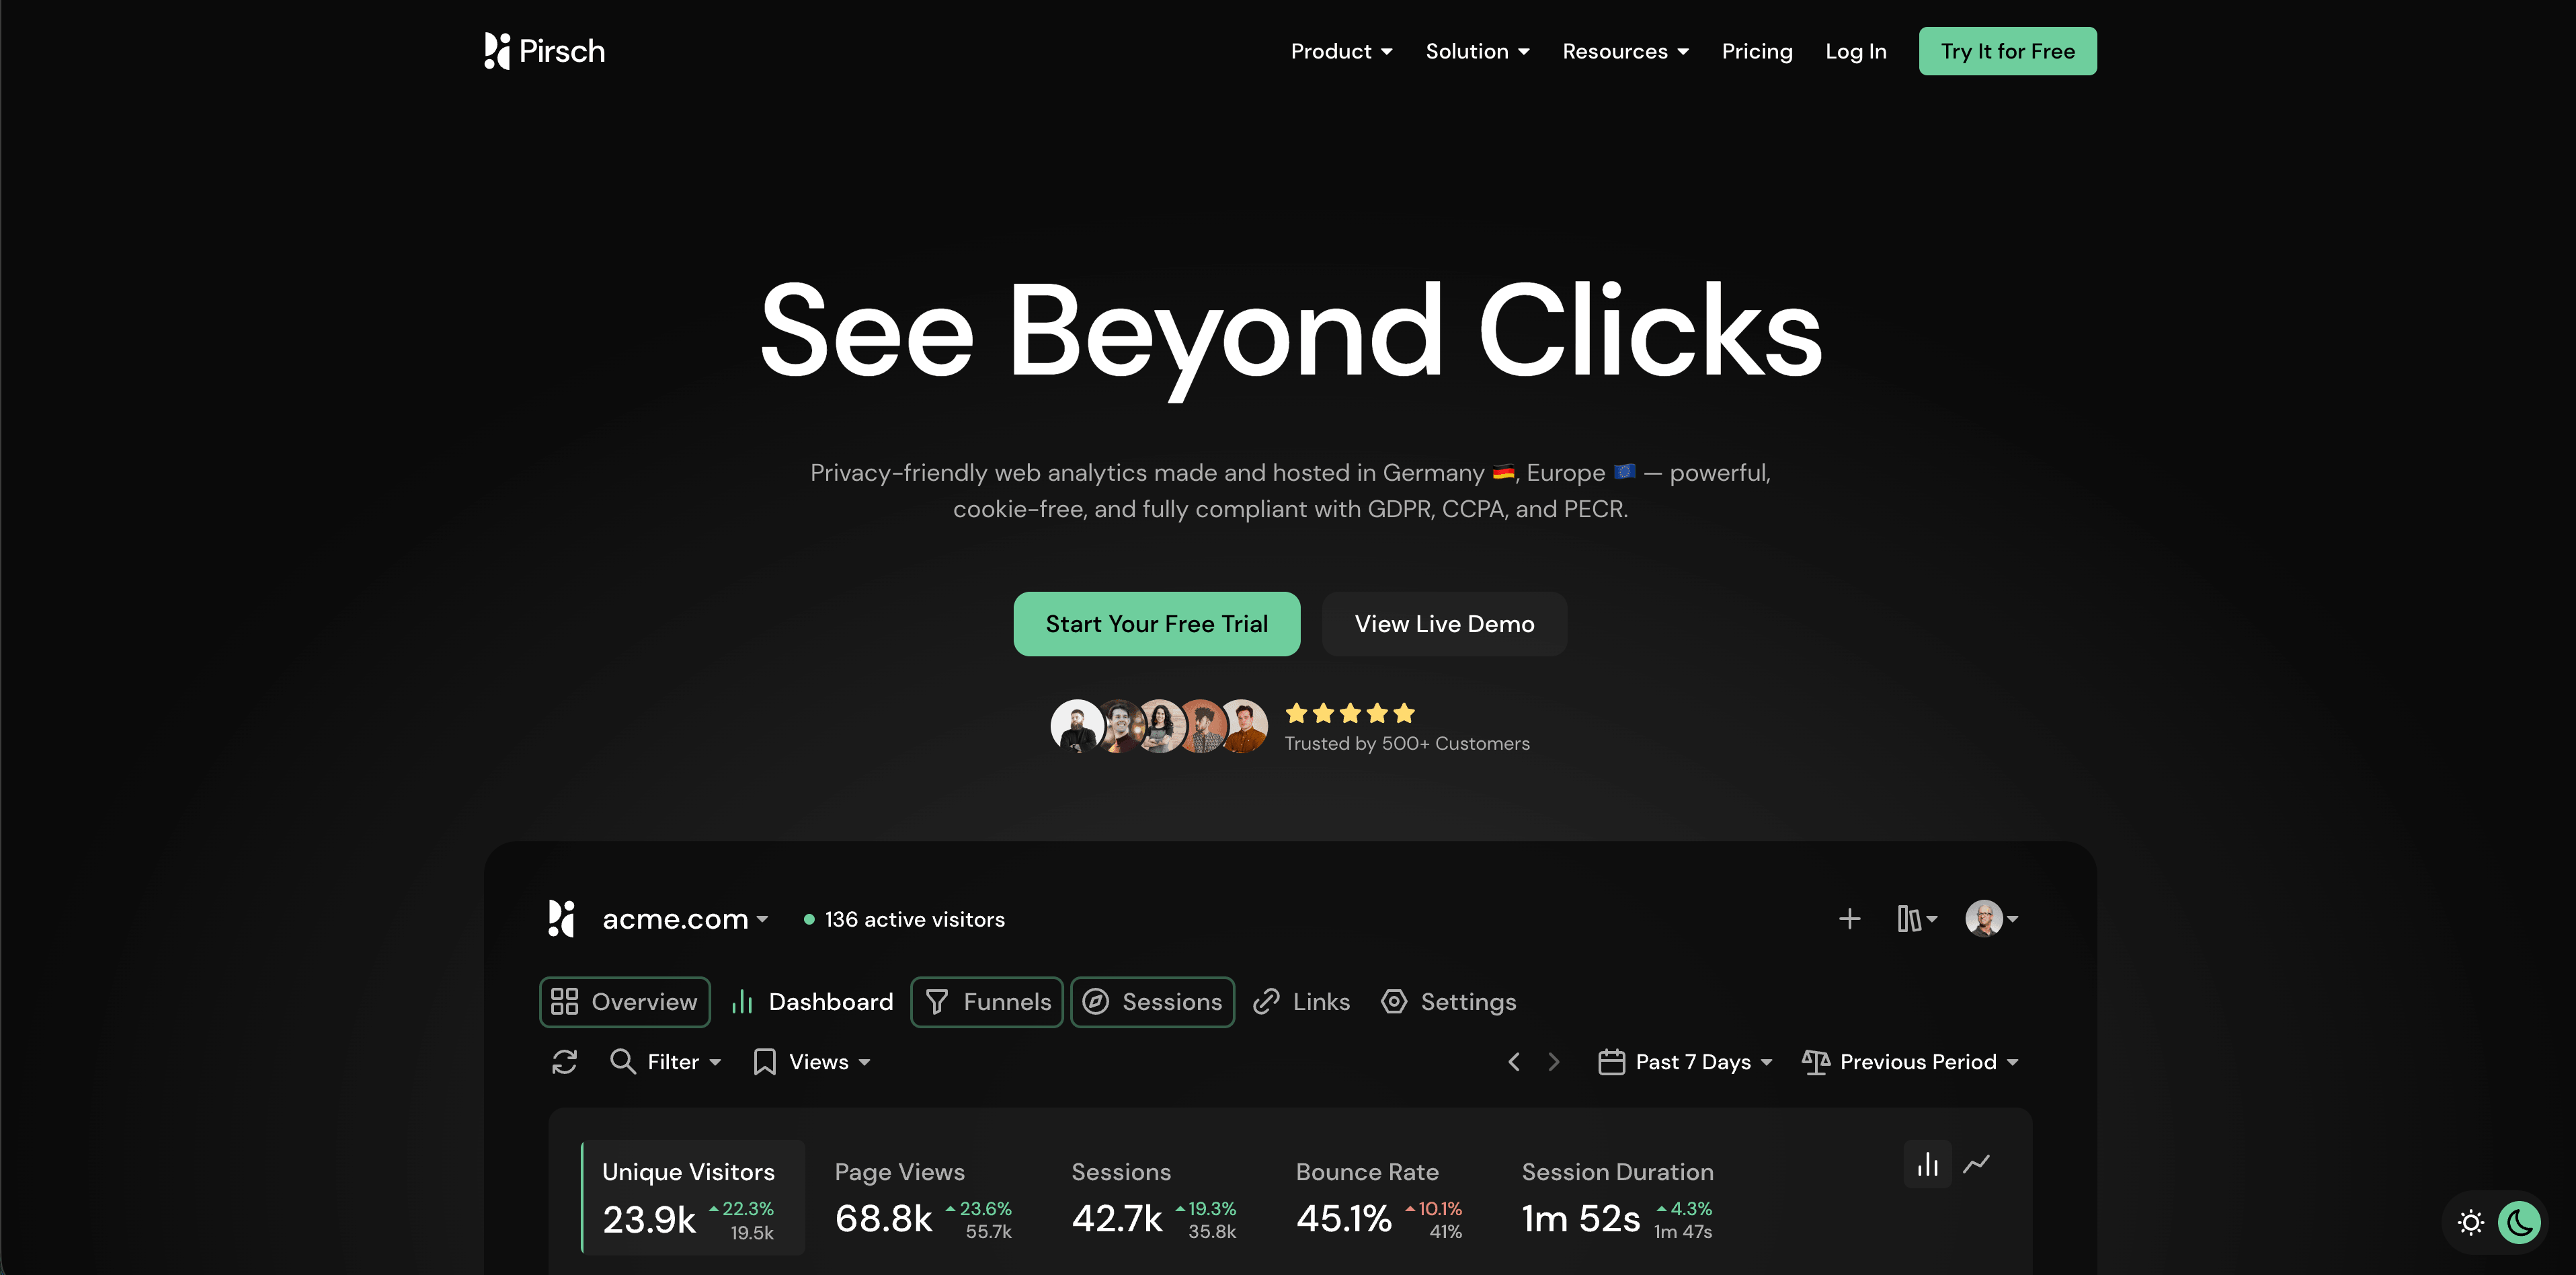
Pirsch dokumentuje integrację po stronie serwera, API i SDK, zdarzenia, cele konwersji, segmentację, testy A/B, wieloetapowe lejki, osadzanie pulpitów i proxy. Dokumentacja zdarzeń podaje, że można je wysyłać ze strony za pomocą JavaScriptu lub z backendu przez API albo SDK.
Pirsch pasuje do agencji, programistów i zespołów dbających o prywatność, którym potrzeba więcej możliwości konfiguracji niż w najbardziej minimalistycznych narzędziach. Dostęp do API, SDK, własne domeny, zespoły, white label i hosting w Niemczech czynią go mocną opcją techniczną.
Uważaj na model prywatności. Pirsch działa bez cookies, ale jego dokumentacja i FAQ opisują anonimowe rozpoznawanie odwiedzających na podstawie danych z żądań. Może to pasować do twojej konfiguracji, ale ocena prawna powinna dotyczyć faktycznych pól, hashowania, okresu przechowywania i celu, a nie tylko słowa „bez cookies”.
Panel w czasie rzeczywistym
Śledzenie celów
Śledzenie bez cookie
6. Matomo
Matomo ma działające od lat Tracking HTTP API oraz dokumentację dla programistów obejmującą śledzenie, raportowanie, Javę, PHP i inne ścieżki wdrożenia. Można go używać w chmurze lub na własnym serwerze i należy do najbardziej rozbudowanych tradycyjnych platform analityki internetowej.
Matomo pasuje do zespołów, które potrzebują własności danych, self-hostingu, analityki e-commerce, niestandardowych wymiarów, celów, segmentów i dojrzałych raportów. Śledzenie po stronie serwera można wdrożyć bezpośrednio przez API lub przez infrastrukturę wysyłającą trafienia do Matomo.
Uważaj na złożoność. Matomo daje wiele ustawień, a każde z nich wpływa na prywatność, zgodę, okres przechowywania, jakość danych i utrzymanie. Możliwości są realne, ale tak samo praca operacyjna.
7. Umami
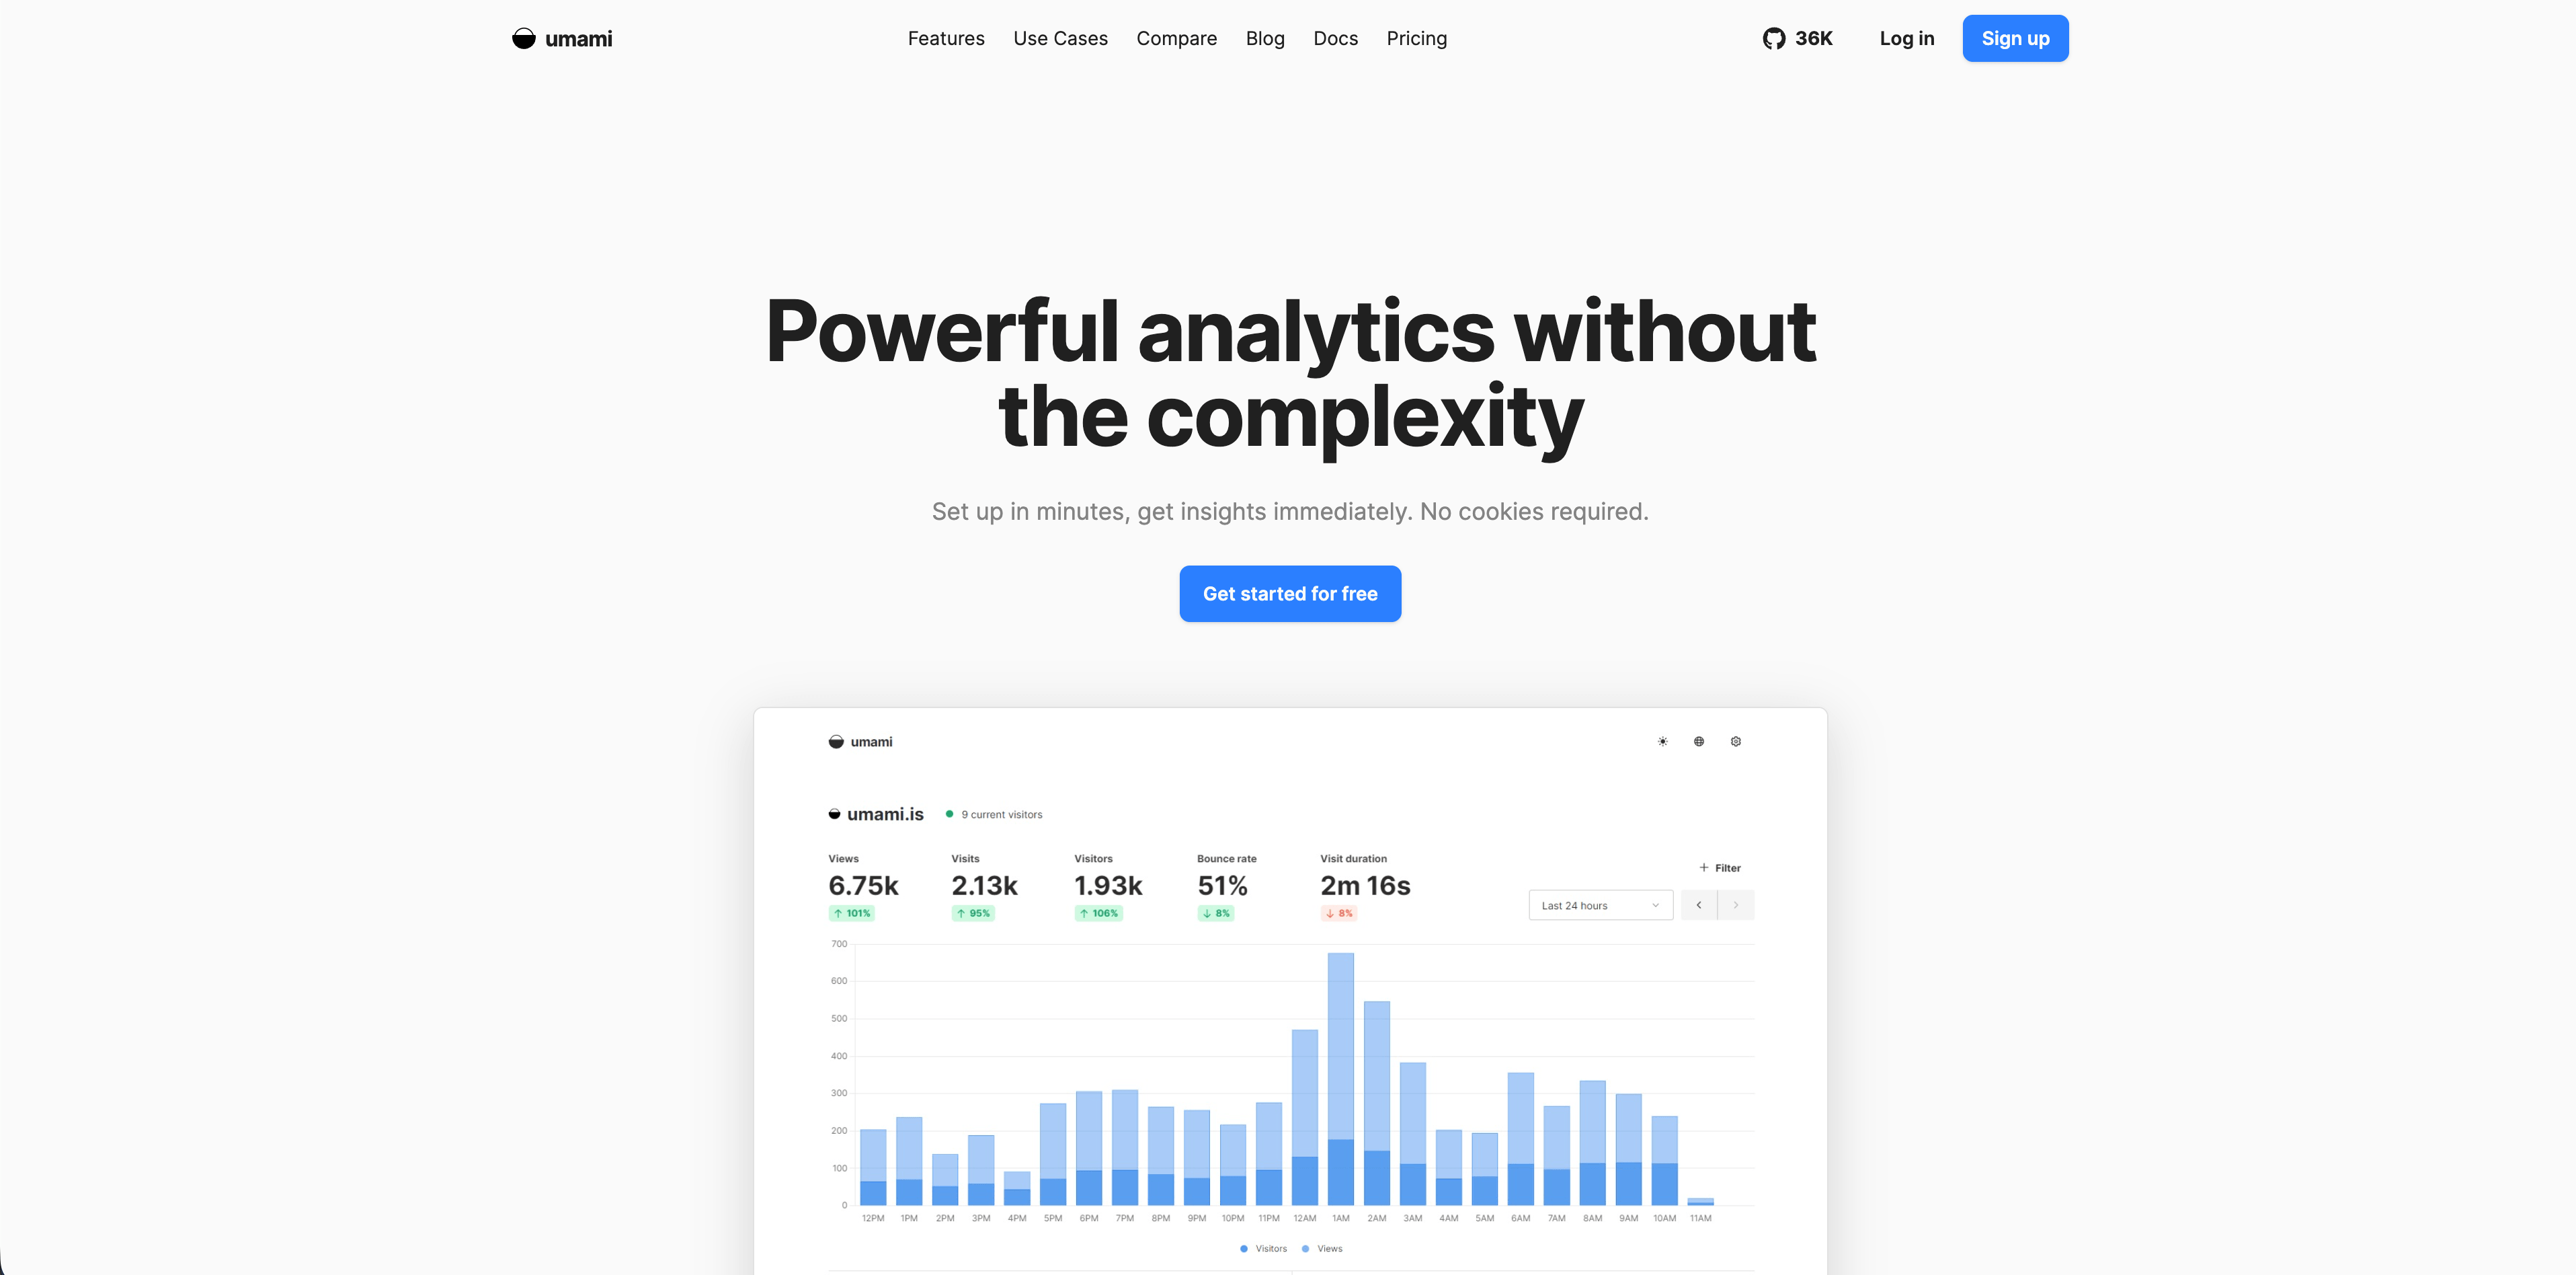
Umami publikuje poradnik o zdarzeniach po stronie serwera dla usług backendowych. Dokumentacja opisuje użycie klienta Node lub punktu końcowego /api/send przy webhookach płatności, działaniach API, zadaniach w tle i importach historycznych. Wspomina też o punkcie końcowym wsadowym do uzupełniania dużych ilości danych.
Umami pasuje do zespołów prowadzonych przez programistów, które chcą prostej analityki na własnym serwerze lub w zarządzanej chmurze. Zdarzenia po stronie serwera przydają się, gdy płatność, zadanie w tle lub działanie w API mają się pojawić w tym samym miejscu co dane o stronie.
Uważaj na kontekst atrybucji. Jeśli zdarzenie z backendu jest odłączone od pierwotnej wizyty w przeglądarce, możesz dostać poprawne zdarzenie, które trudno przypisać do kampanii, strony docelowej lub referrera.
8. Seline
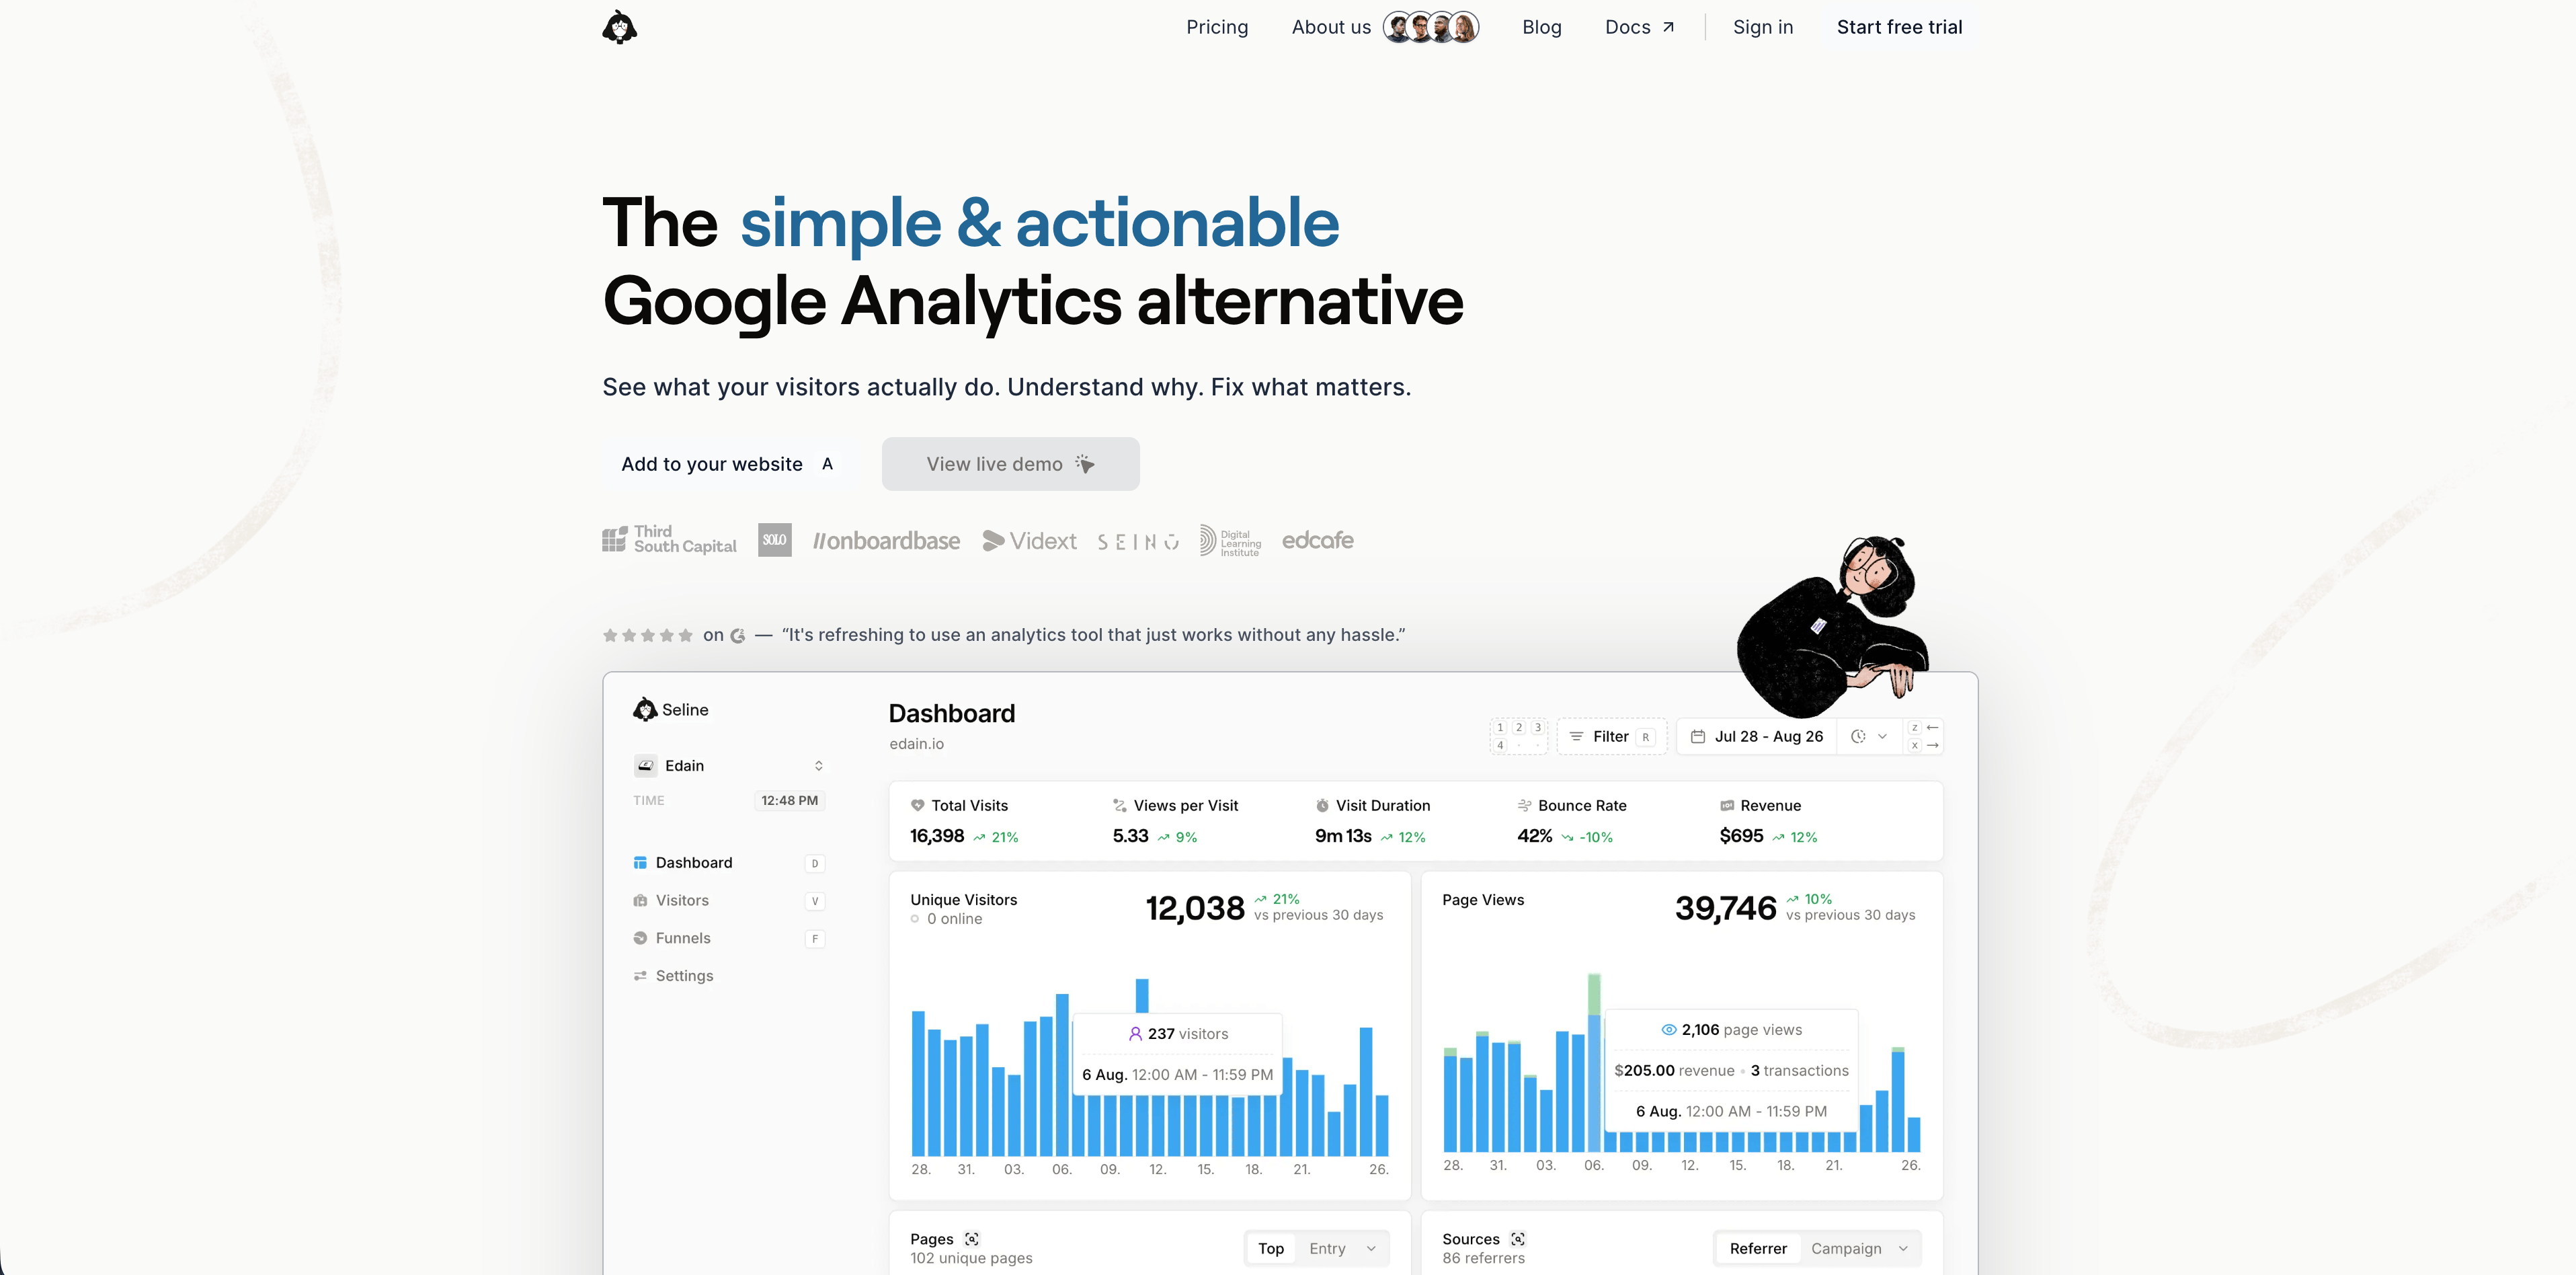
Seline podaje, że zdarzenia niestandardowe są dostępne zarówno po stronie klienta, jak i serwera. Dokumentacja zaleca krótkie nazwy zdarzeń, obsługuje właściwości niestandardowe i wymaga unikalnego identyfikatora użytkownika dla zdarzeń wysyłanych z serwera. Opisuje też idempotentność za pomocą insertId, która zapobiega duplikatom.
Seline pasuje do zespołów SaaS i e-commerce, które chcą bogatszych ścieżek, profili, lejków, przychodów i atrybucji niż w minimalistycznym pulpicie odsłon. Zdarzenia z serwera mają sens przy rejestracjach, subskrypcjach i działaniach przychodowych powiązanych ze znanymi użytkownikami.
Uważaj na konfigurację tożsamości. Jeśli zdarzenie z serwera wymaga znanego identyfikatora użytkownika, anonimowa atrybucja marketingowa potrzebuje świadomie zaprojektowanego przejścia od wizyty na stronie docelowej do konta lub zakupu.
9. DataFast
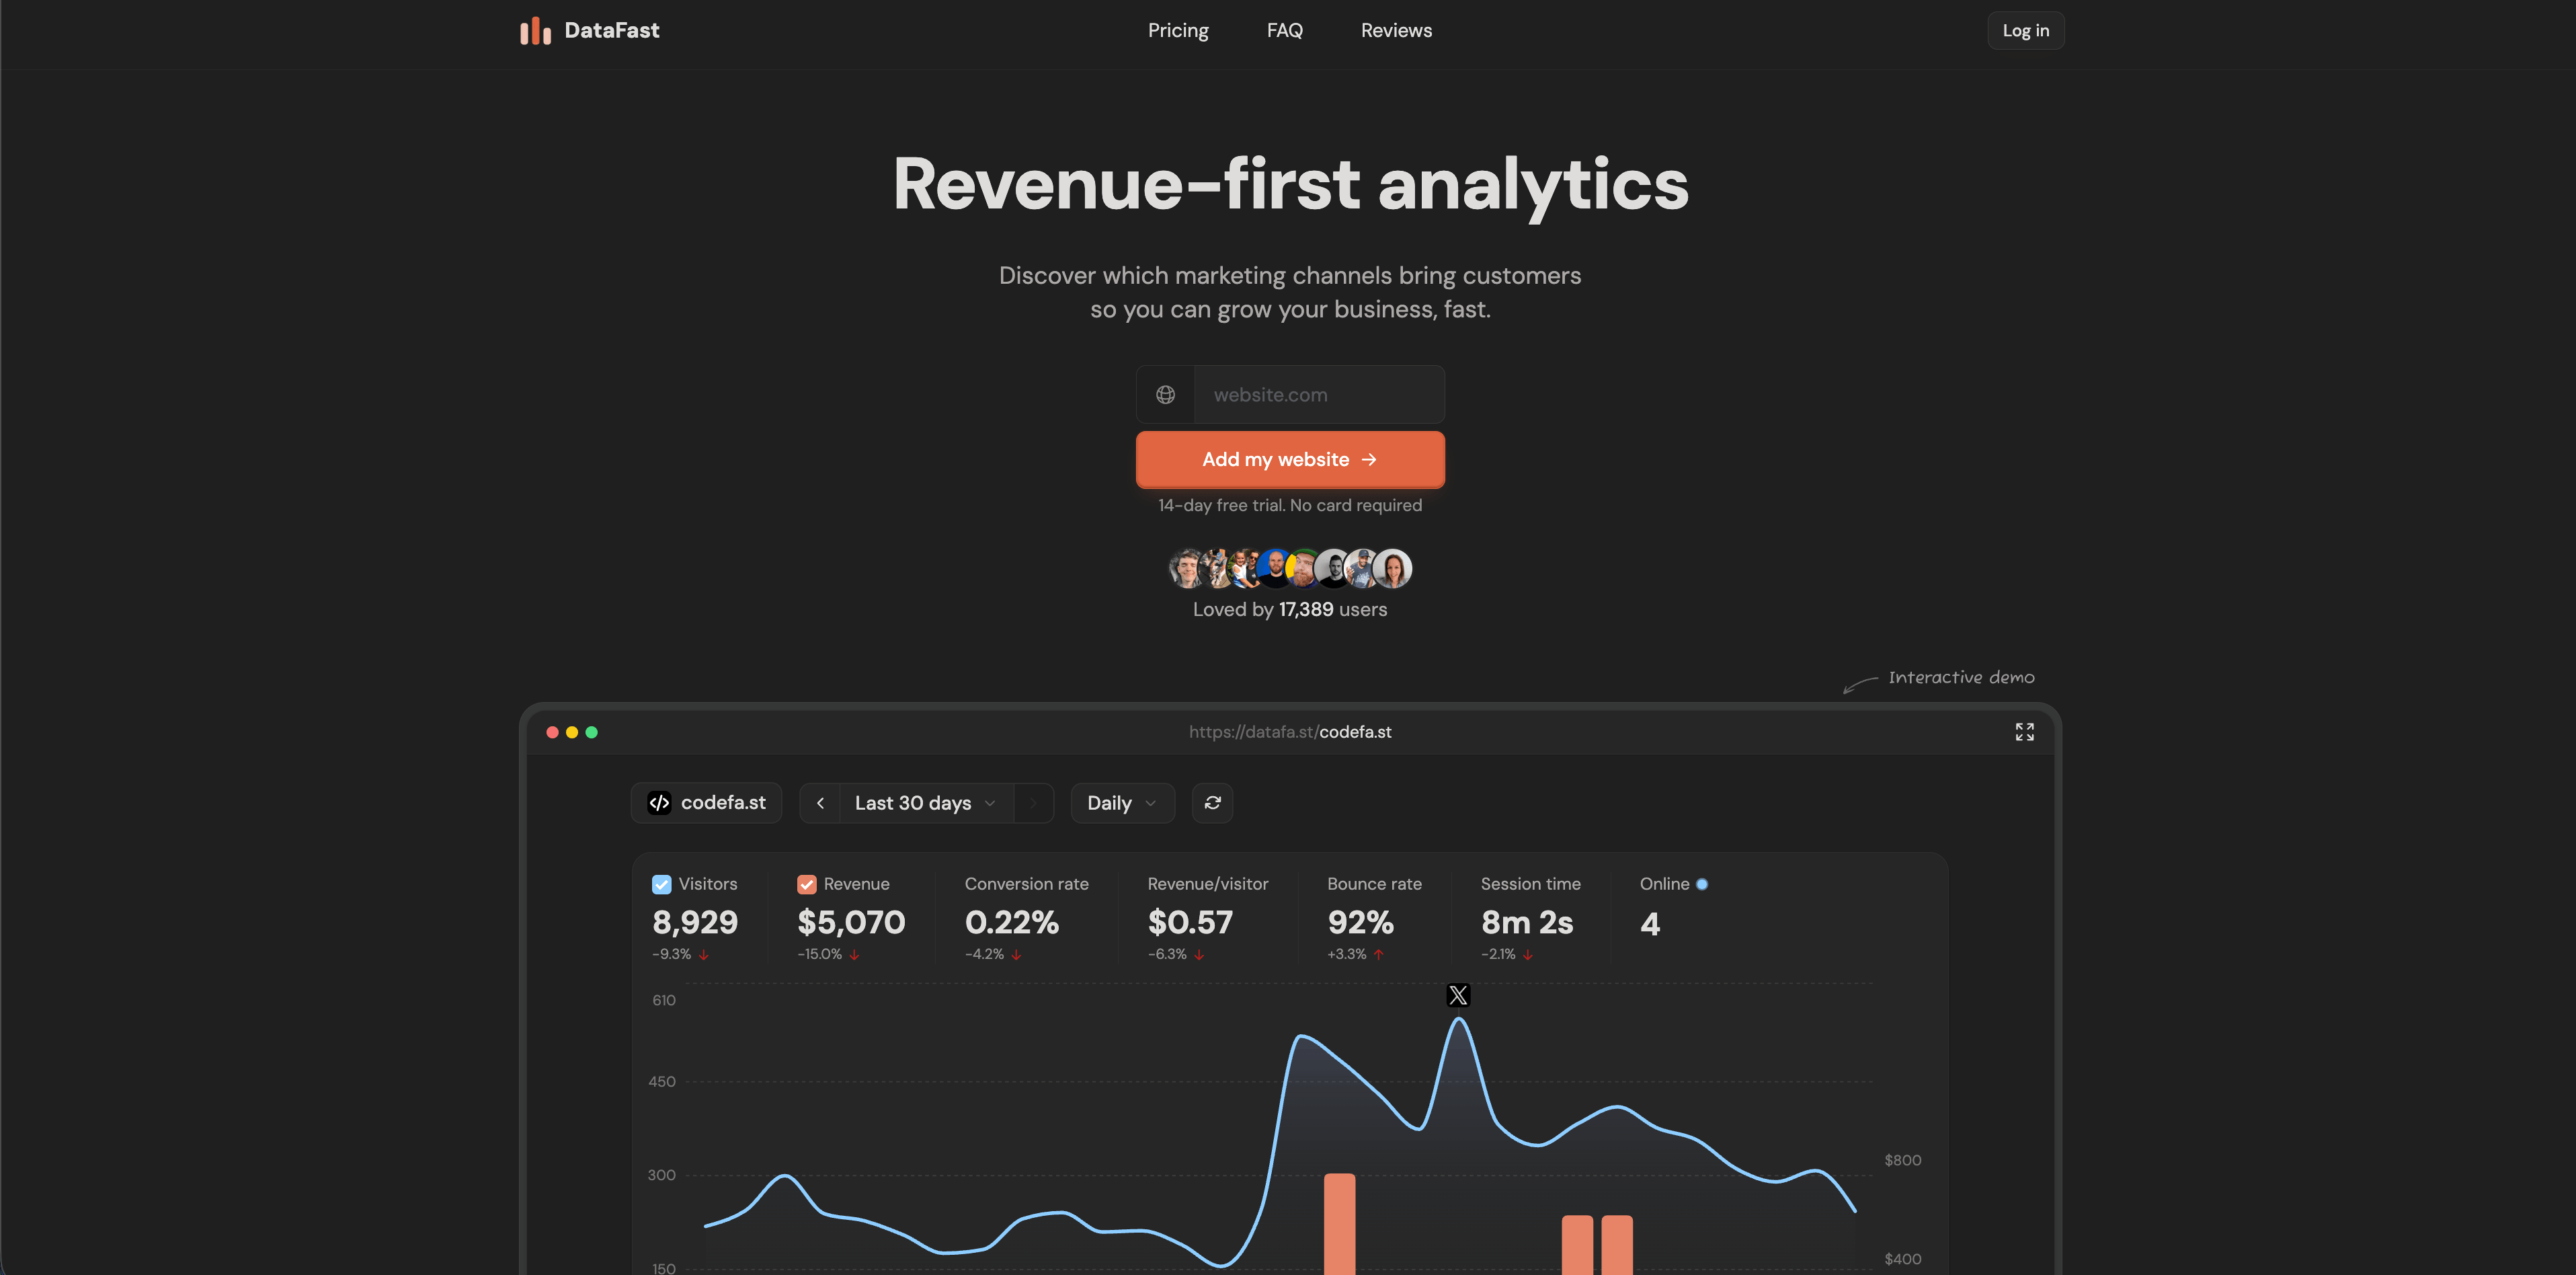
DataFast dokumentuje API v1 dla danych analitycznych i celów, a jego lista zmian z kwietnia 2025 r. podaje, że API może tworzyć po stronie serwera cele niestandardowe dla określonych działań użytkowników. Dokumentacja przychodów po stronie klienta również zaleca śledzenie po stronie serwera dla lepszej dokładności.
DataFast pasuje do małych twórców i niewielkich zespołów SaaS, którym najbardziej zależy na tym, które kanały przynoszą klientów i przychody. Jego zastosowanie po stronie serwera to mniej szeroka instrumentacja, a bardziej potwierdzanie celów i zdarzeń przychodowych.
Panel w czasie rzeczywistym
Śledzenie celów
Śledzenie bez cookie
Uważaj na dopasowanie odwiedzających. Atrybucja przychodów zależy od powiązania zweryfikowanej płatności lub celu z odwiedzającym, sesją lub źródłem, które je wygenerowały.
10. PostHog
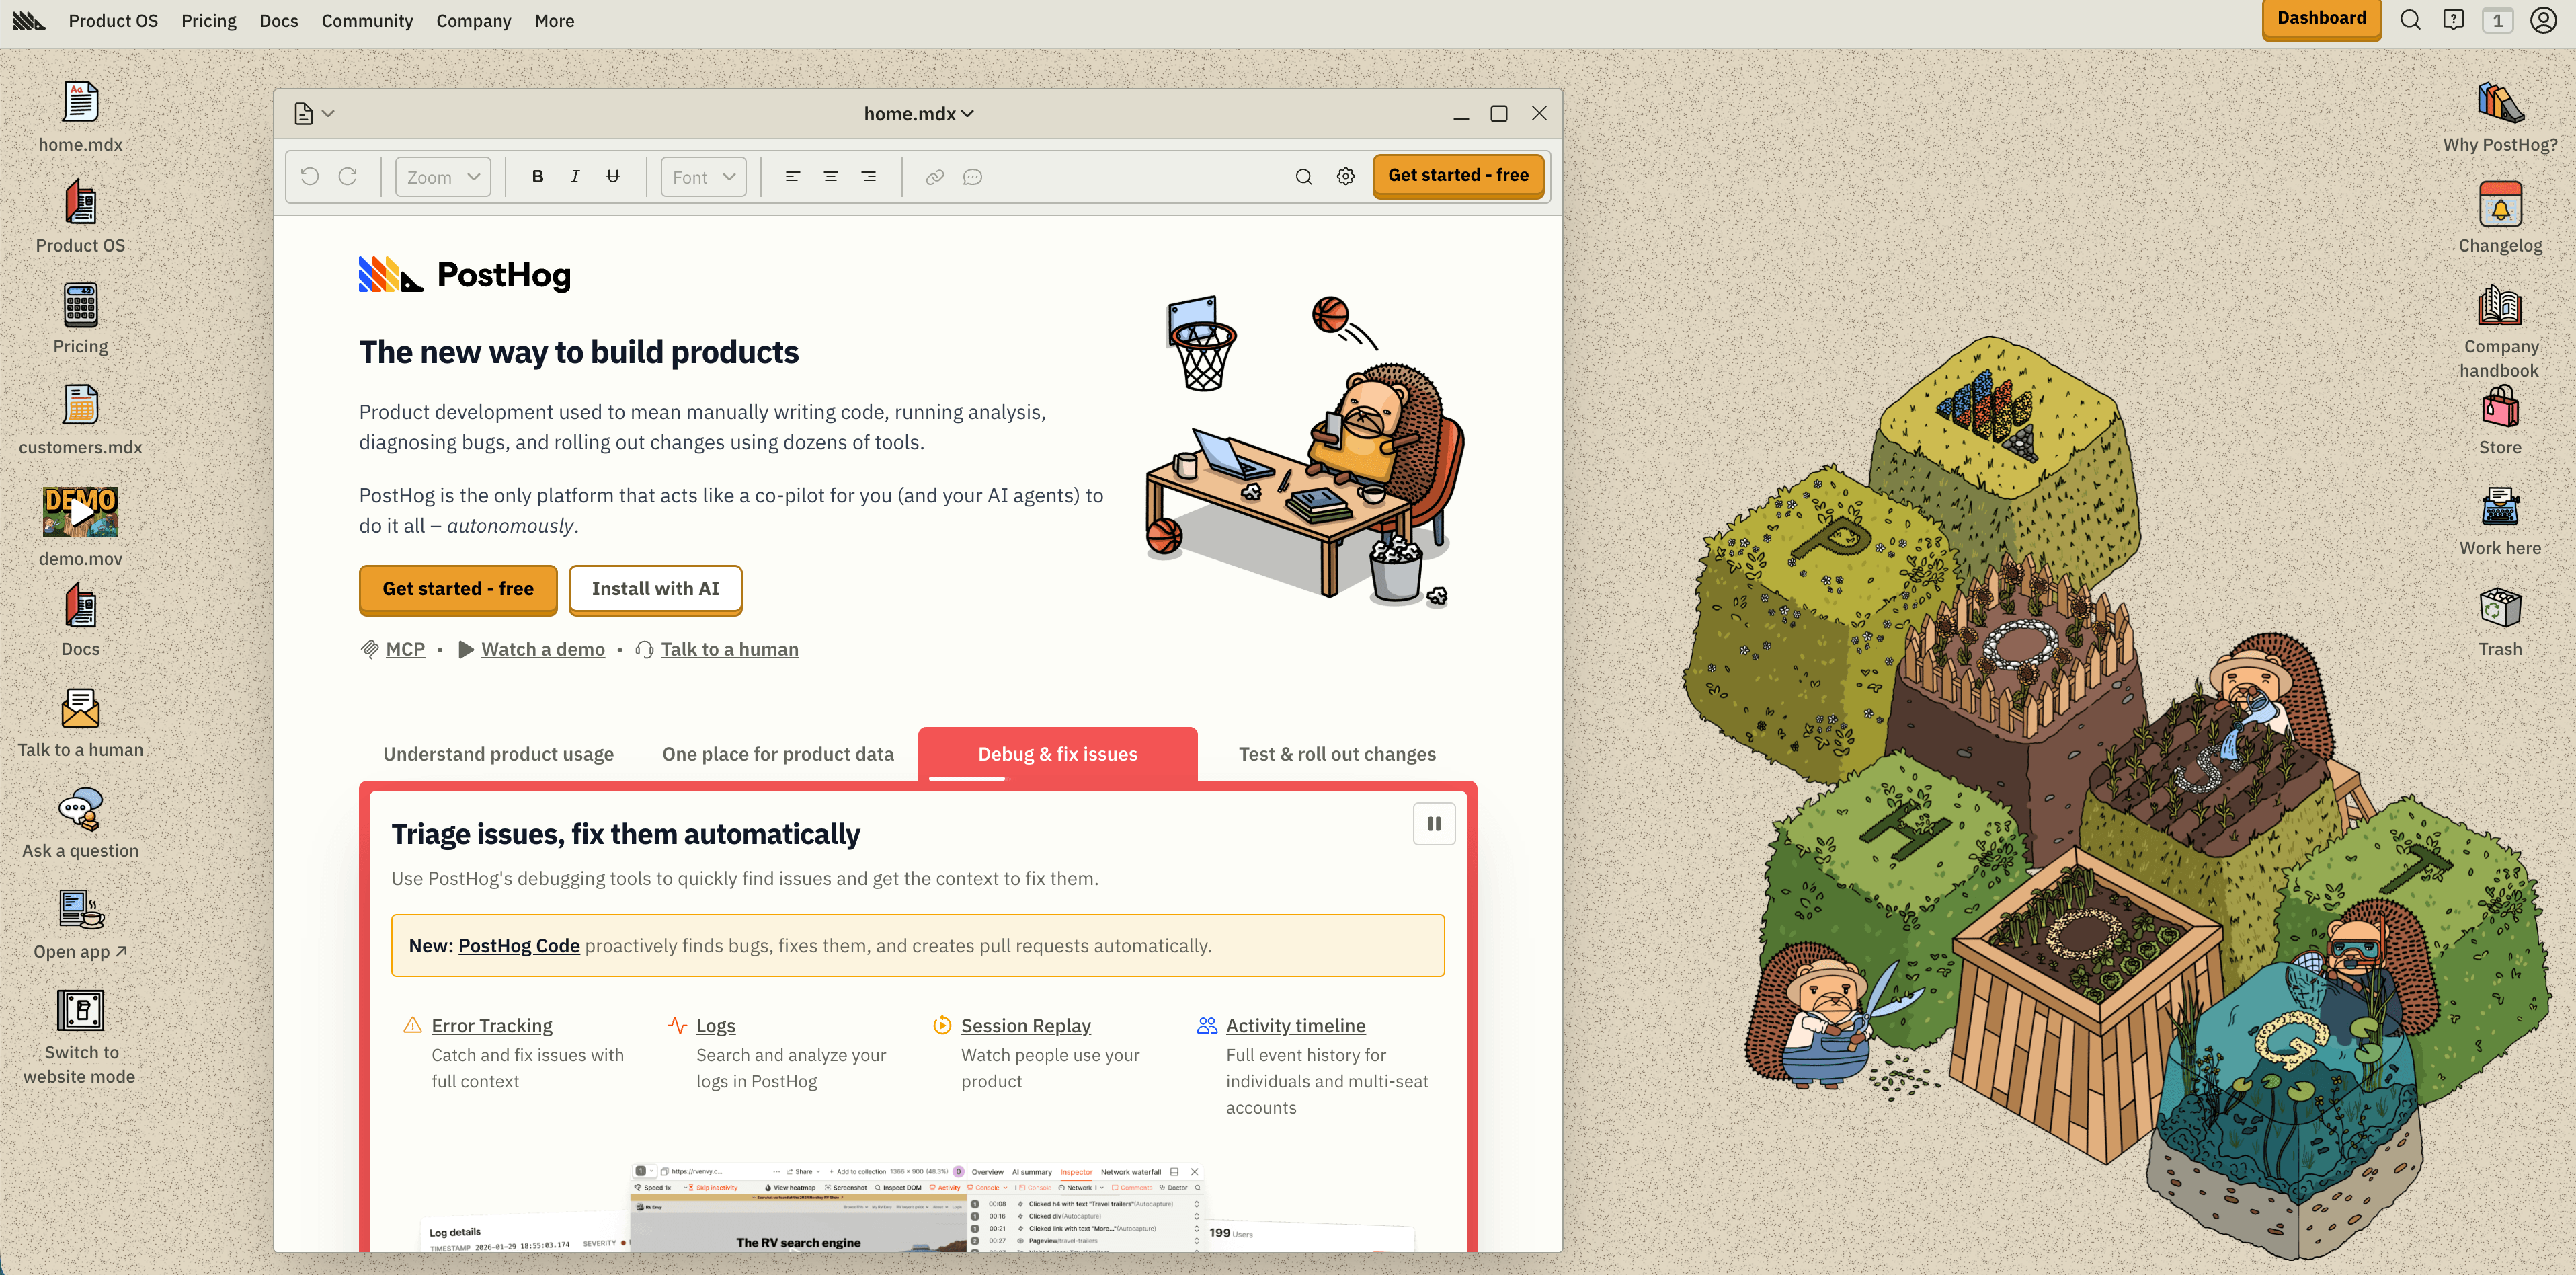
PostHog jest znacznie szerszy niż analityka stron. Jego publiczne strony produktowe i listy SDK opisują biblioteki webowe, mobilne i serwerowe, analitykę produktową i webową, odtwarzanie sesji, flagi funkcji, eksperymenty, ankiety, hurtownię danych, potoki danych, śledzenie błędów i nie tylko.
PostHog pasuje do zespołów prowadzonych przez inżynierów, które chcą mieć zdarzenia z backendu, analitykę produktową, flagi, eksperymenty, odtwarzanie sesji i przepływ danych w jednym produkcie. Śledzenie po stronie serwera jest tu częste przy zdarzeniach subskrypcji, stanie rozliczeń, zadaniach w tle, ocenie flag funkcji i działaniach dostępnych tylko w backendzie.
Uważaj na nadzór. PostHog może być lekki dla startupu, ale może też stać się centrum produktowego stosu danych. Zdecyduj, które zdarzenia są anonimowe, które tworzą profile osób, jakie właściwości są dozwolone i które zespoły mogą dodawać miejsca docelowe.
11. Mixpanel
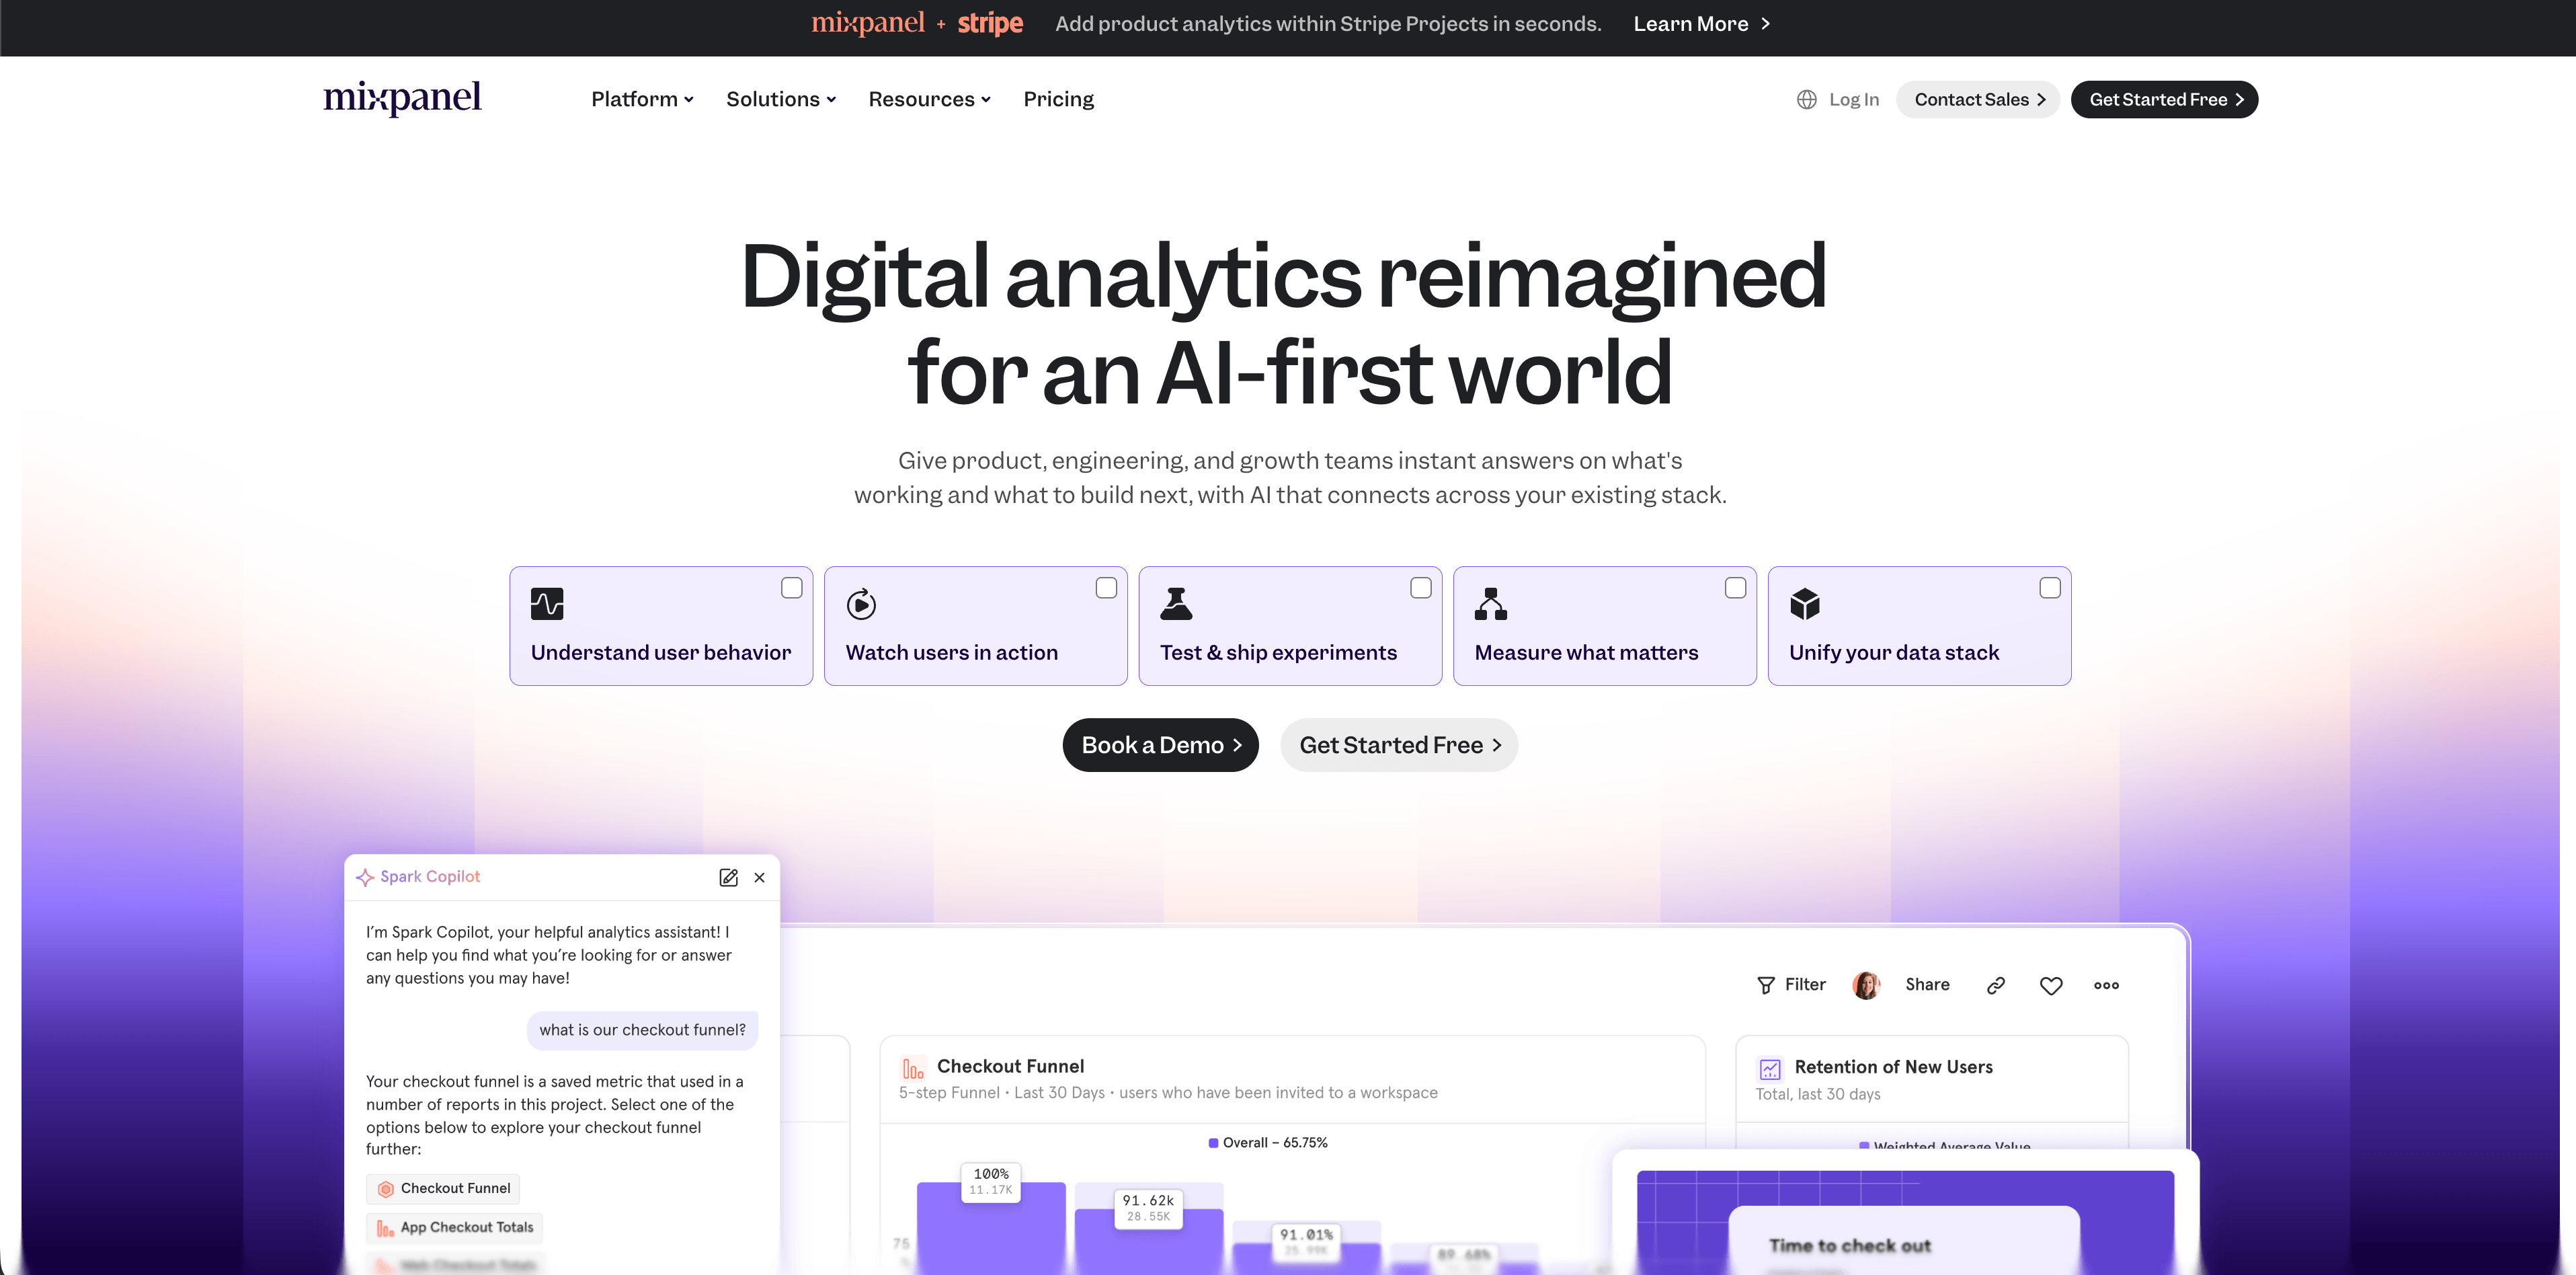
Dokumentacja Mixpanel dla programistów opisuje punkt końcowy /track, a biblioteki klienckie Mixpanel obsługują śledzenie zdarzeń po stronie serwera. Zdarzenia z serwera naturalnie pasują do zdarzeń produktowych, które backend zna z całą pewnością.
Mixpanel pasuje do zespołów z prawdziwą taksonomią zdarzeń: aktywacja, retencja, użycie funkcji, kohorty, lejki i analiza cyklu życia. Jest potężny, gdy firma traktuje śledzenie jak zaprojektowany produkt danych, a nie stos doraźnych wywołań.
Uważaj na brak domyślnych danych z przeglądarki. Zdarzenia z serwera nie dziedziczą automatycznie UTM, referrera, urządzenia, kampanii ani kontekstu sesji, chyba że celowo je przekażesz lub zachowasz.
12. Heap
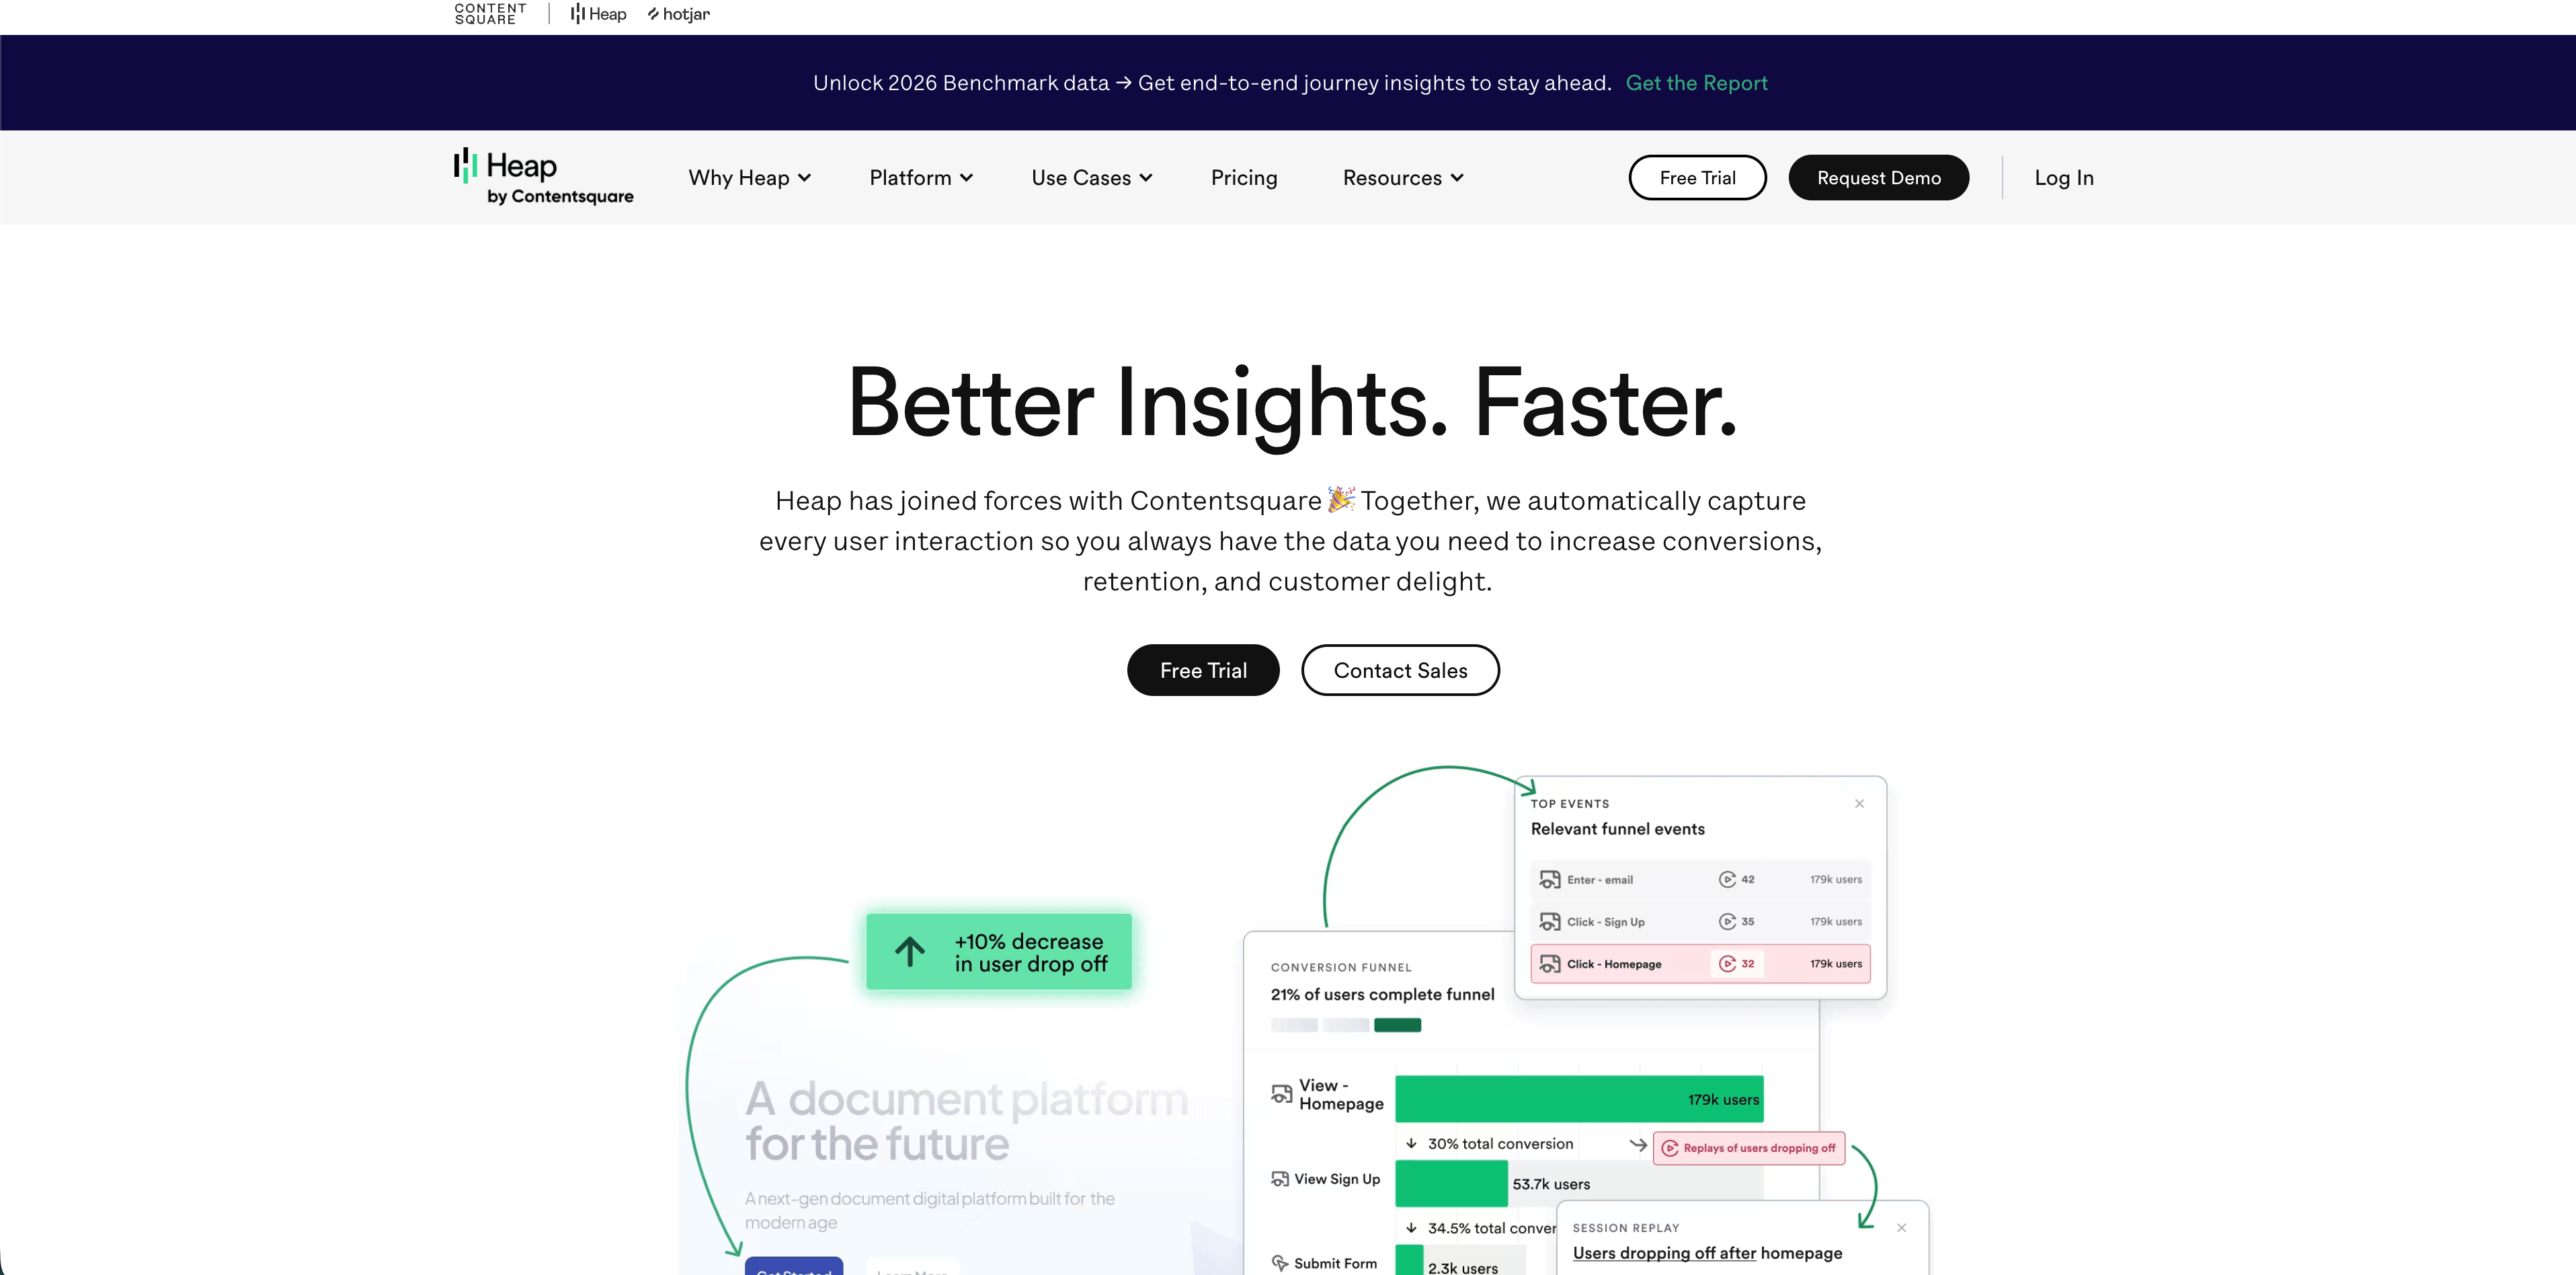
Heap dokumentuje Track API po stronie serwera dla zdarzeń niestandardowych. API jest zalecane dla zdarzeń, które muszą dokładnie odpowiadać danym z backendu, takich jak ukończone zamówienia, lub których Heap nie może przechwycić po stronie klienta.
Heap pasuje do zespołów produktowych, które chcą automatycznie zbieranych zachowań w przeglądarce oraz wybranych faktów z backendu. To połączenie jest przydatne, gdy liczy się ścieżka we frontendzie, ale końcowa konwersja lub stan konta są wiarygodne tylko na serwerze.
Uważaj na zachowanie sesji. Dokumentacja Heap zaznacza, że zdarzenia niestandardowe po stronie serwera mają ograniczenia dotyczące tożsamości i łączenia w sesje. Nie zawsze można je stosować zamiennie z automatycznie zbieranymi zdarzeniami webowymi.
Praktyczny plan wdrożenia
Zanim wybierzesz narzędzia, zacznij od kontraktu pomiarowego.
| Metryka | Źródło prawdy | Ścieżka śledzenia |
|---|---|---|
| Odsłona | Analityka w przeglądarce lub zdarzenie trasy renderowanej na serwerze | Po stronie klienta, chyba że aplikacja jest w większości renderowana na serwerze |
| Utworzenie rejestracji | Baza danych aplikacji | Po stronie serwera |
| Zgłoszenie leada | Obsługa formularza w backendzie | Po stronie serwera, z dołączonym kontekstem źródła z przeglądarki |
| Opłacony zakup | Webhook płatności lub baza zamówień | Po stronie serwera |
| Kliknięcie zakładki cennika | Interfejs w przeglądarce | Po stronie klienta |
| Pobranie pliku | Uwierzytelniony punkt końcowy plików | Po stronie serwera |
| Przekroczenie limitu API | Usługa backendowa | Po stronie serwera |
| Głębokość przewijania | Obszar widoku przeglądarki | Po stronie klienta |
| Odsetek błędów 404 lub 500 | Logi serwera, brzegu sieci lub systemu obserwowalności | Po stronie serwera lub w logach |
Następnie zdefiniuj kontrakt zdarzeń:
Panel w czasie rzeczywistym
Śledzenie celów
Śledzenie bez cookie
- Nazywaj zdarzenia prostym językiem biznesowym, na przykład
signup_created,lead_qualified,checkout_paidlubinvoice_refunded. - Nadaj każdemu wartościowemu zdarzeniu klucz idempotentności lub identyfikator transakcji.
- Zachowaj źródło wejścia, parametry UTM, referrer i anonimowy identyfikator odwiedzającego przed konwersją.
- Przekazuj tylko właściwości potrzebne do raportowania.
- Usuwaj adresy e-mail, numery telefonów, surowe parametry zapytań, dane płatnicze i zbędne identyfikatory użytkowników.
- Zdecyduj, które zdarzenia wymagają zgody, a które są niezbędnymi zapisami operacyjnymi.
- Udokumentuj deduplikację między zdarzeniami z przeglądarki i serwera.
- Przetestuj każde zdarzenie w pulpicie i, jeśli to możliwe, w surowych eksportach.
Lista kontrolna prywatności
Śledzenie po stronie serwera może ograniczyć wycieki danych, ale tylko przy zdyscyplinowanym projekcie.
- Nie traktuj „po stronie serwera” jako synonimu „zgodne z przepisami o prywatności”.
- Dbaj, by dane analityczne były mniejsze niż rekordy backendu, z których pochodzą.
- Nie przekazuj pełnych adresów IP, adresów e-mail, nazwisk, uwag do zamówień ani parametrów zapytań w URL bez jasnej potrzeby i podstawy prawnej.
- Respektuj stan zgody i rezygnacji, zanim przekażesz zdarzenia do systemów analitycznych lub reklamowych.
- Oddzielaj logi operacyjne od analityki marketingowej.
- Ustal okresy przechowywania, zanim dane się nagromadzą.
- Włącz usuwanie, eksport, umowę powierzenia, podprocesorów i region hostingu do oceny dostawcy.
- Wybieraj raporty zagregowane tam, gdzie szczegóły na poziomie użytkownika nie są potrzebne.
Najczęściej zadawane pytania
Czy śledzenie po stronie serwera jest dokładniejsze?
Jest bardziej niezawodne przy zdarzeniach potwierdzanych przez serwer, takich jak płatności, rejestracje i działania w API. Nie jest automatycznie dokładniejsze przy zachowaniach w przeglądarce i może tracić kontekst atrybucji, jeśli UTM, referrer, user agent i identyfikatory odwiedzających nie są starannie obsługiwane.
Czy śledzenie po stronie serwera omija blokery reklam?
Może ograniczyć straty spowodowane blokowaniem skryptów w przeglądarce, gdy zdarzenia są wysyłane z backendu lub własnej infrastruktury. Jeśli zdarzenie nadal zaczyna się od skryptu w przeglądarce, narzędzia chroniące prywatność wciąż mogą na nie wpływać, a ty nadal musisz respektować zgodę i rezygnację.
Czy nadal potrzebuję analityki po stronie klienta?
Zwykle tak. Analityka po stronie klienta lepiej sprawdza się przy zachowaniach w przeglądarce: kontekście strony, kliknięciach, zmianach tras, głębokości przewijania, czasie widoczności, linkach wychodzących i interakcjach z interfejsem. Śledzenie po stronie serwera powinno ją uzupełniać o zweryfikowane fakty z backendu.
Czy śledzenie po stronie serwera znosi wymóg banera cookie?
Samo w sobie nie. Zasady zgody zależą od tego, jakie dane są zbierane, czy system zapisuje informacje na urządzeniu użytkownika lub uzyskuje do nich dostęp, czy używa identyfikatorów i dokąd wysyła dane. Minimalny log operacyjny na serwerze to coś innego niż serwerowy potok reklamowy.
Od której platformy zacząć?
Zacznij od Flowsery, jeśli zadaniem jest analityka strony dbająca o prywatność, ze źródłami, celami, lejkami, ścieżkami, zdarzeniami niestandardowymi i atrybucją przychodów. Plausible, Fathom, Simple Analytics, Pirsch, Umami lub Matomo wybierz, gdy chcesz prostszej analityki strony lub większej kontroli nad infrastrukturą. PostHog, Mixpanel lub Heap wybierz, gdy prawdziwym zadaniem jest analityka produktowa.
Co jest faktem z przeglądarki, a co faktem z serwera?
Kliknięcie zakładki z cennikiem to fakt z przeglądarki, potwierdzona płatność z backendu rozliczeń to fakt z serwera, a błąd 500 to fakt z infrastruktury. Przypisz każdą metrykę do systemu, który faktycznie ją zaobserwował, zamiast przepuszczać wszystkie zdarzenia przez jedno źródło.
Czy śledzenie w przeglądarce i na serwerze może policzyć tę samą konwersję dwa razy?
Tak, gdy przy zakupie uruchamia się zarówno piksel w przeglądarce, jak i zdarzenie płatności z backendu dla tego samego zamówienia. Zaprojektuj deduplikację wokół stabilnego identyfikatora transakcji, tak jak opcja data-disable-payments we Flowsery i pole insertId w Seline zapobiegają zdublowanym zdarzeniom płatności.
Co robi serwerowy kontener tagów, czego nie robi własne proxy?
Własne proxy odbiera zdarzenie z przeglądarki i przekazuje je dalej, więc nadal zaczyna się ono w przeglądarce i dotyczą go te same pytania o zgodę i dostęp do urządzenia. Serwerowy kontener tagów odbiera zdarzenia i kieruje je do wielu miejsc docelowych, obsługując przekształcenia i deduplikację, kosztem większej infrastruktury, wydatków i nadzoru.
Ile kosztuje Flowsery przy śledzeniu przychodów po stronie serwera?
Flowsery podaje plan Team za 250 $/miesiąc i Pro za 500 $/miesiąc po 14-dniowym darmowym okresie próbnym, a oba plany obejmują dostęp do API, cele niestandardowe i API płatności potrzebne do atrybucji przychodów po stronie serwera. Nie ma osobnego planu dla zdarzeń z serwera.
Czy surowe liczby z logów serwera to realna liczba odwiedzających?
Nie, logi serwera mieszają z ludźmi roboty, monitory dostępności, boty podglądu linków, roboty AI, ponowne próby, prefetch i żądania z pamięci podręcznej. Liczba żądań staje się użyteczną miarą odbiorców dopiero po sklasyfikowaniu i przefiltrowaniu tego ruchu, dlatego analityka logów i brzegu sieci lepiej nadaje się do operacji i śledzenia błędów niż do liczenia sesji.
Podsumowanie
Śledzenie po stronie serwera nie jest magicznym ulepszeniem. To sposób na umieszczenie właściwych zdarzeń we właściwym miejscu. Przeglądarki używaj do faktów z przeglądarki, backendu do faktów biznesowych, a pulpitu do decyzji, które przejdą przegląd pod kątem prywatności.
Zacznij od Flowsery i analityki dbającej o prywatność, jeśli chcesz mieć źródła, cele, lejki, ścieżki, zdarzenia niestandardowe i atrybucję przychodów, nie zamieniając każdego odwiedzającego w profil reklamowy.
Źródła sprawdzone 12 maja 2026 r.: cennik Flowsery, konfiguracja skryptu Flowsery, cele niestandardowe Flowsery, wprowadzenie do API Flowsery, Plausible Events API, dokumentacja API Fathom, dokumentacja Simple Analytics o śledzeniu po stronie serwera, dokumentacja Pirsch, dokumentacja zdarzeń Pirsch, Matomo Tracking API, zdarzenia po stronie serwera w Umami, zdarzenia niestandardowe Seline, dokumentacja API DataFast, lista zmian API DataFast, strony produktowe i SDK PostHog, Mixpanel Track Events API, Heap Track API, wytyczne ICO o plikach cookie i podobnych technologiach oraz wytyczne Data Protection Commission o plikach cookie.
Panel w czasie rzeczywistym
Śledzenie celów
Śledzenie bez cookie
Czy ten artykuł był pomocny?
Chętnie poznamy opinię!
Częściej widoczni w Google
Jedno kliknięcie ustawia Flowsery jako preferowane źródło, dzięki czemu nasze artykuły pojawiają się wyżej w Najważniejszych artykułach, trybie AI i Przeglądach od AI.
Jeszcze jedno...

Flowsery
Analityka witryny skupiona na przychodach
Każdy odwiedzający, źródło i konwersja w czasie rzeczywistym. Prosto, skutecznie i bez plików cookie.
Panel w czasie rzeczywistym
Śledzenie celów
Śledzenie bez cookie
Powiązane artykuły
Jak wybrać komercyjną platformę raportową: porównanie 12 narzędzi
Komercyjna platforma raportowa musi zapracować na swoją fakturę. Jedenaście narzędzi porównanych pod kątem prywatności, cen, lejków, atrybucji przychodów, hostingu i głębi produktu.
Jak wybrać narzędzia do śledzenia e-commerce bez nadmiernego śledzenia
Dobre narzędzie do śledzenia e-commerce wyjaśnia atrybucję i lejki zakupowe bez profilowania klientów. Porównanie pod kątem przychodów, prywatności i ceny.
Oprogramowanie do metryk webowych: 12 opcji w porównaniu na 2026
Dwanaście narzędzi do metryk webowych ze zweryfikowanymi cenami, uwagami o prywatności i zrzutami dashboardów oraz podpowiedź, które pominąć, gdy potrzebujesz tylko danych o ruchu.